MYLODLibrary er en bibliografisk katalog som beskriver ressurser ikke som isolerte poster lukket om seg selv, men som et nettverk av entiteter satt i relasjon til hverandre etter prinsippene for Linked Open Data, begrepsmodellen IFLA LRM og katalogiseringsstandarden RDA.
Den underliggende forutsetningen er at en katalog ikke bare skal bevitne at et dokument finnes, men skal gjøre eksplisitt de relasjonene som går gjennom det: forbindelsen mellom et verk og oversettelsene av det, mellom en utgave og eksemplaret som eies, mellom en forfatter og helheten av det vedkommende har skrevet, mellom en tekst og temaene den tar opp, og mye mer. En tradisjonell bibliografisk beskrivelse uttrykker disse relasjonene i en løpende, lukket form som er forståelig for et menneske, men ugjennomtrengelig for enhver automatisk behandling; her er de i stedet kodet i en formell struktur, og dermed søkbare, etterprøvbare og gjenbrukbare for tredjepartssystemer.
Prosjektet forener to katalogiseringsveier — det tradisjonelle biblioteksformatet MARC21 og beskrivelse født i IFLA LRM — som møtes i den samme offentlige katalogen og mater én felles RDF-datagraf, fritt søkbar, blant annet gjennom et SPARQL-endepunkt. Seksjonene nedenfor går gjennom hovedkomponentene, fra gjenfinningsgrensesnittet til verktøyene for å produsere og publisere dataene.
En merknad til leseren: ressursene i katalogen til MYLODLibrary tilhører en privat, personlig boksamling som stadig oppdateres, publisert med det formål å gjøres tilgjengelig for studier og for utviklingen av prosjektet. Derfor er det viktig å merke seg at dataene på eksemplarnivå bare er ment å validere forskningen og resultatene i MYLOD og å gi studiemateriale for dataregistrering og for å bygge Linked Open Data.
Søk og utforsk
Den generelle katalogen er inngangen til samlingene som er beskrevet i MYLODLibrary, og det viktigste utsiktspunktet for enhver som slår opp i den. Søk kan gjøres i enkel form — på tittel, forfatter eller emne, med støtte for jokertegn ved delvise søk — eller i avansert form, ved å kombinere flere kriterier med boolske operatorer (AND, OR, NOT) som gjør det mulig å snevre inn treffmengden trinn for trinn til nøyaktig det man trenger er isolert.
Gjenfinningsgrensesnittet gir en analytisk framstilling av sammenhengen: ved siden av trefflisten beskriver et panel med dynamisk beregnet statistikk den delen av katalogen som konsulteres, fordelt på tekstens språk, utgivelsessted og -dato, agenter og så videre. Muligheten for å filtrere treffene etter registreringsmåte gir brukeren oversikt over hva som er publisert født i RDF-format eller eventuelt med utgangspunkt i MARC21. Søket slutter dermed å være ren postgjenfinning og blir et analyseverktøy: brukeren får ikke bare en liste, men et kvantitativt sammendrag av delmengden som er isolert.
Hvert treff angir dessuten sin egen opprinnelse ved å oppgi det samlede antallet genererte tripler, slik at informasjonstettheten bak beskrivelsen blir umiddelbart merkbar. Herfra kommer man til den fullstendige posten for verket og til alle formatene det er tilgjengelig i.
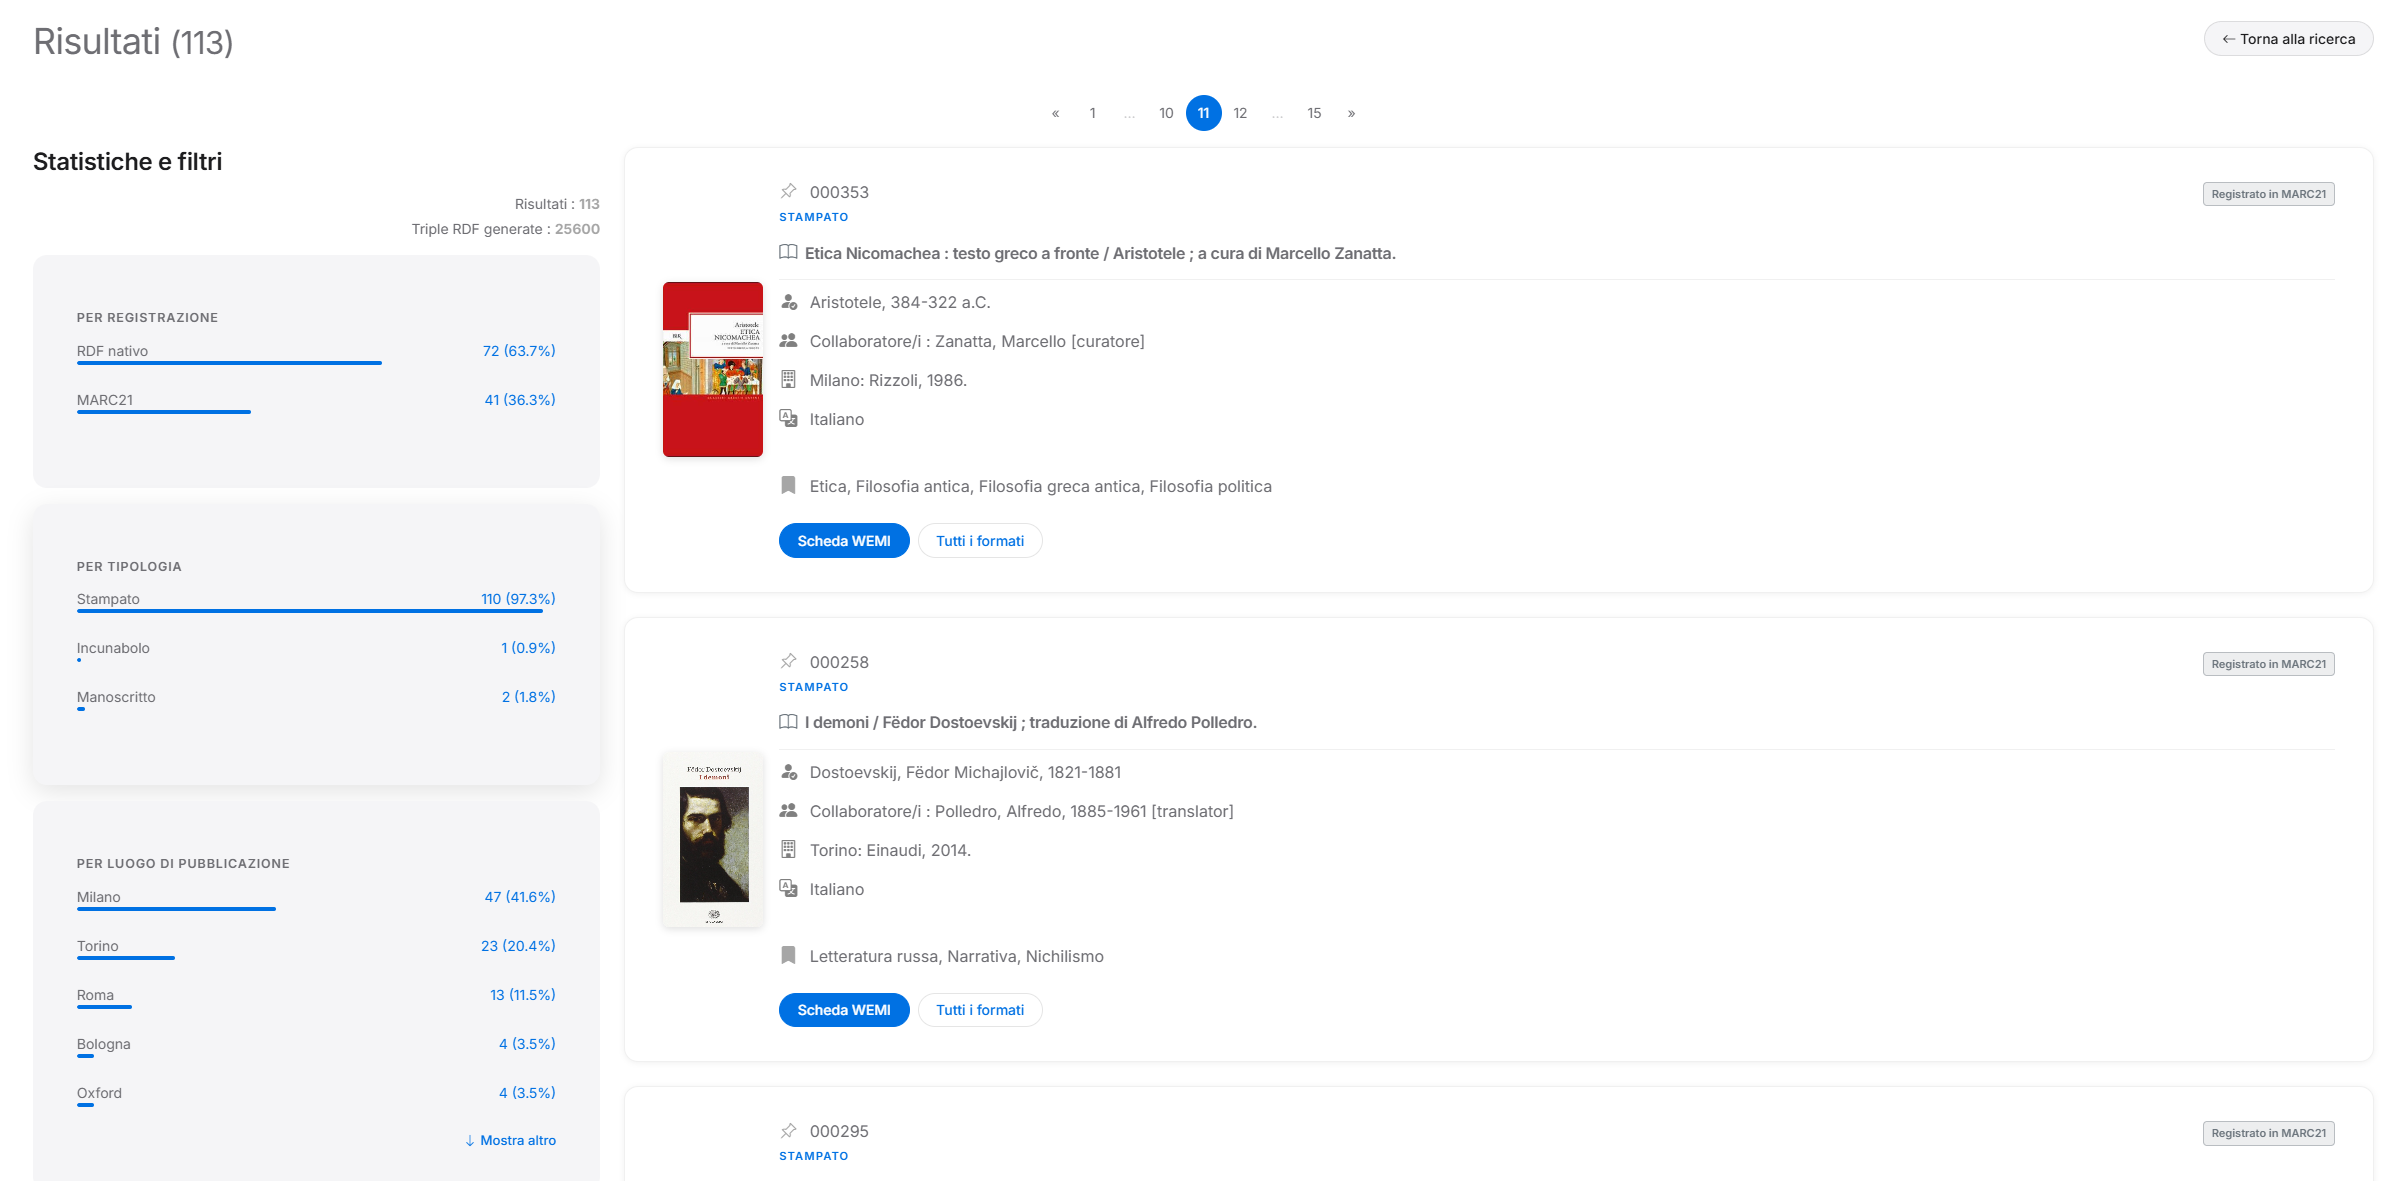
Søk i den generelle katalogen, med filtre og statistikk i sanntid
Verk, Uttrykk, Manifestasjon, Eksemplar
I kjernen av prosjektets begrepsapparat ligger IFLA Library Reference Model, rammeverket som det internasjonale bibliotekmiljøet har tenkt beskrivelsen av ressurser på nytt gjennom. Prinsippet er at det vi til daglig kaller «en bok» i virkeligheten ikke er ett enkelt objekt, men lagene av fire atskilte entiteter knyttet sammen i et hierarki.
Verket er det intellektuelle innholdet i abstrakt forstand — Den guddommelige komedie som en skapelse av tanken, uansett hvordan man leser den. Uttrykket er en konkret realisering av det: en bestemt oversettelse, en kritisk revisjon, en versjon på et gitt språk. Manifestasjonen svarer til utgaven slik den fysisk er produsert og utgitt, med sitt forlag, sitt år, sitt ISBN. Eksemplaret er til sist det enkelte fysiske eksemplaret som eies og står på hylla.
Å beskrive disse fire nivåene hver for seg, i stedet for å presse dem sammen i én post, gjør at katalogen kan svare på spørsmål en flat beskrivelse ikke engang kan formulere: hvor mange oversettelser av et gitt verk som finnes, i hvilke utgaver de er utgitt, hvilke eksemplarer som eies. Hver entitet settes dessuten i relasjon til agentene som har frambrakt den, emnene den behandler, og stedene og periodene den viser til.
Hele veven av disse relasjonene kan undersøkes som en interaktiv graf, generert automatisk ut fra hver post: et verktøy som gjør den semantiske arkitekturen bak bibliografisk beskrivelse synlig — og pedagogisk lesbar. Dette oppsettet tjener også programvaresystemet som produserer dataene, ettersom det lar maskinen generere, forvalte og bevare automatisk hver relasjon katalogisatoren er i stand til å beskrive, og dermed gir den som slår opp i katalogen frihet til å bevege seg gjennom de ulike scenarioene ressursene omfatter eller kan føre til, både innenfor katalogen og utenfor den.
Den samme relasjonslogikken omfatter også agentene selv: en person kan erklæres medlem av en korporasjon, en korporasjon kan gå forut for eller etterfølge en annen — gjennom sammenslåinger, oppdelinger, navneendringer — og to agenter kan mer generelt registreres som knyttet til hverandre. Også disse koblingene, modellert etter relasjonstypene definert i IFLA LRM, publiseres som RDF-tripler og vises på den offentlige posten til hver agent.
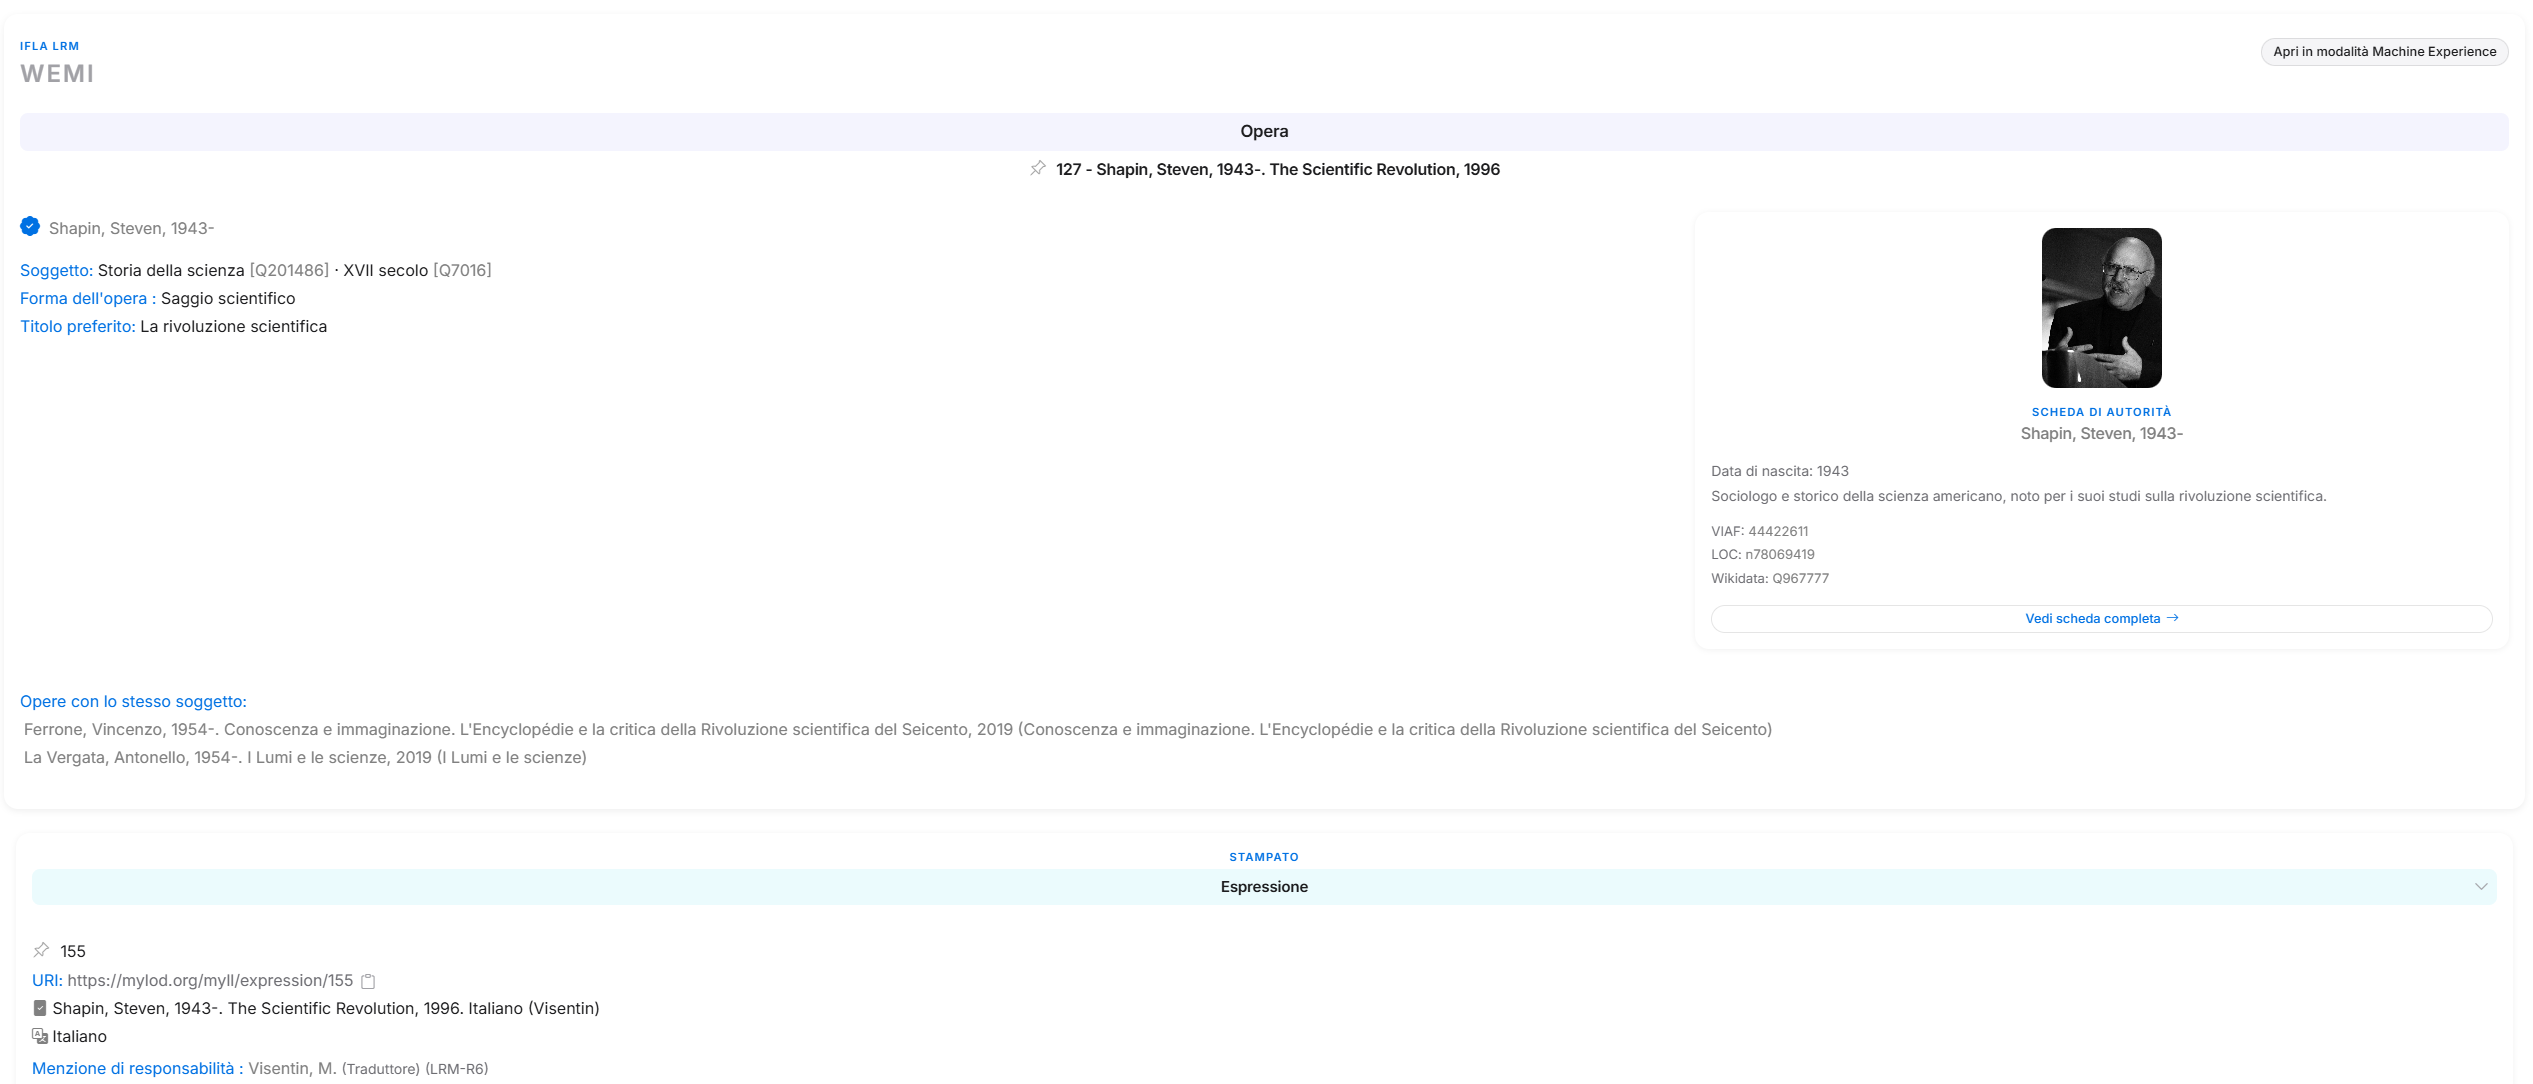
Kaskaden Verk → Uttrykk → Manifestasjon, med agentens autoritetspost ved siden av
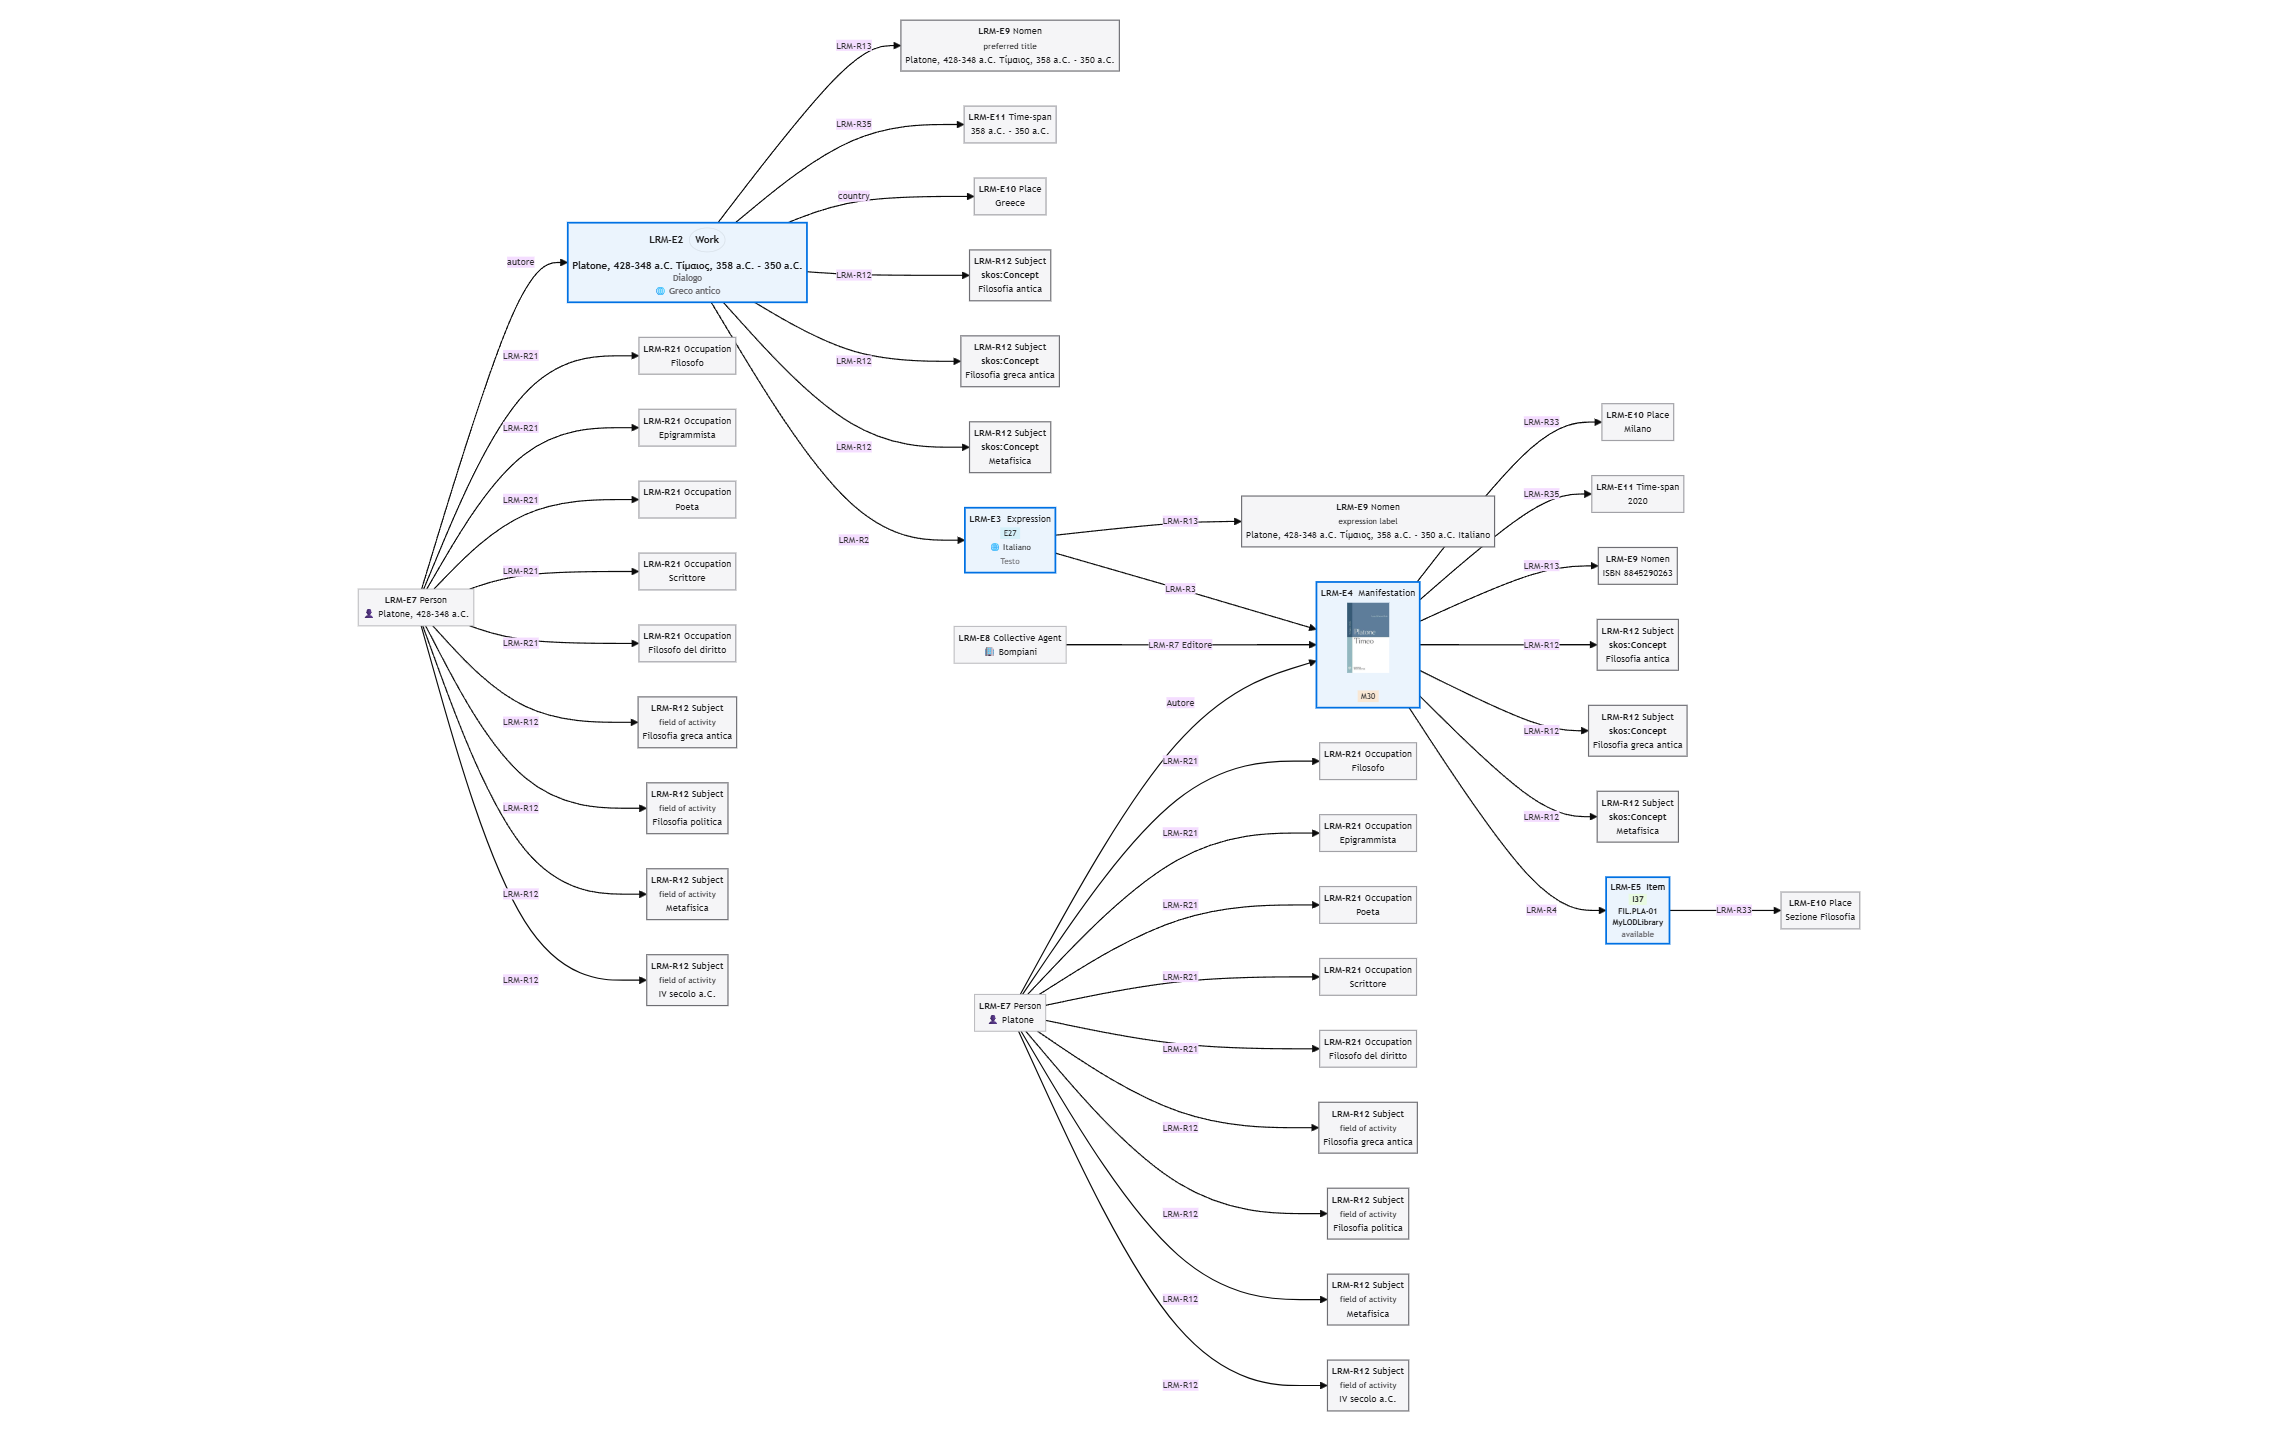
LRM-relasjonsgrafen, generert automatisk for hvert verk
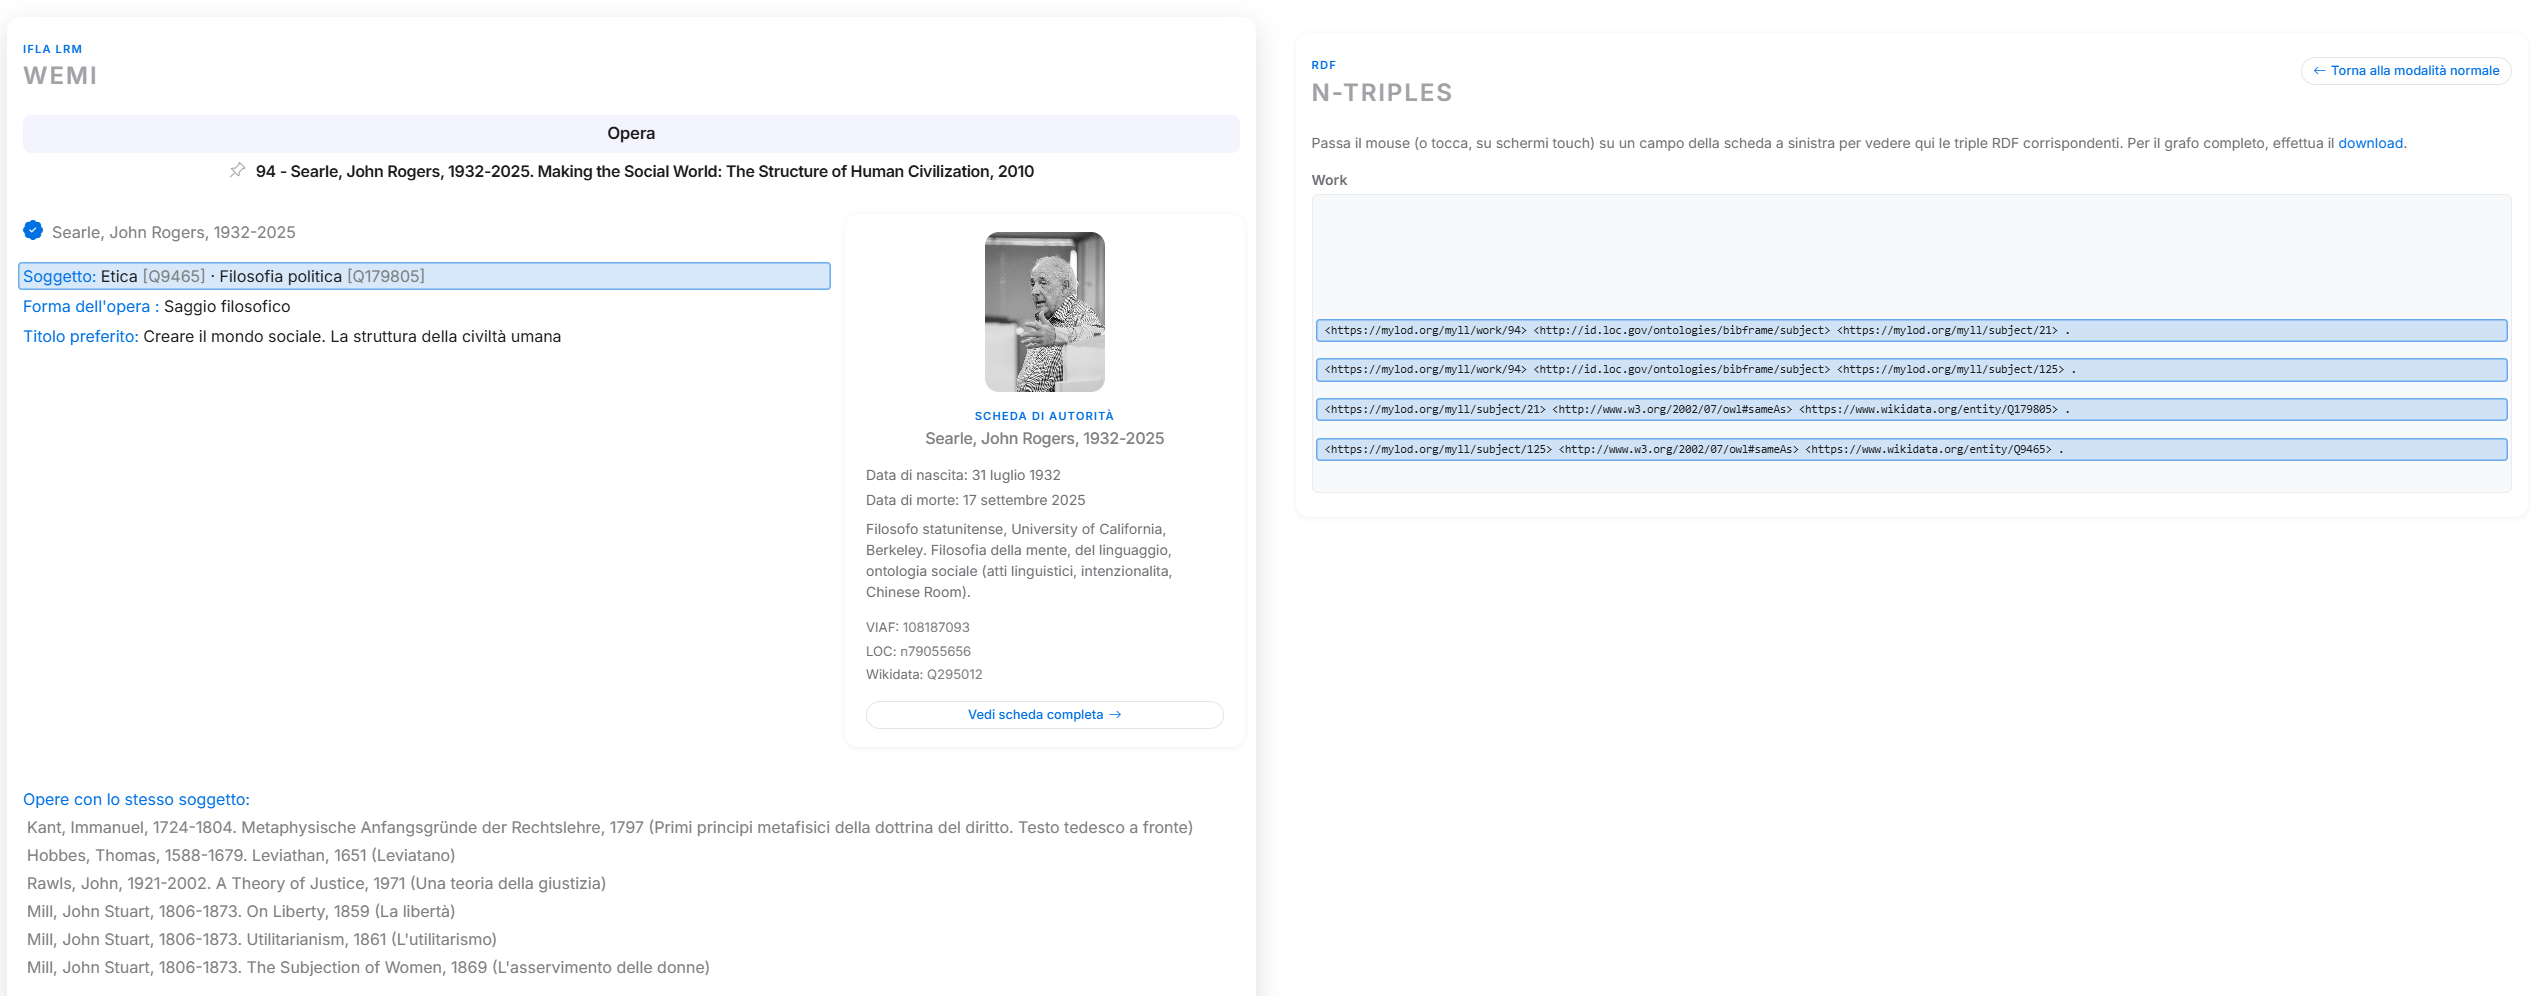
La naturlig språk og maskinspråk leve side om side, og utforsk RDF-triplene dine
Agenter, steder og emner som entiteter
Forfattere, korporasjoner, steder, emner, yrker og uniforme titler opptrer ikke i katalogen som tekststrenger gjentatt i hver post, men som selvstendige autoritetsentiteter: beskrevet én gang, med sin egen varige identifikator, og kalt ved referanse overalt hvor de forekommer. Dette er prinsippet om autoritetskontroll, her anvendt systematisk på hver klasse av entitet modellen omfatter.
Konkrete følger springer ut av dette. En retting i formen av et forfatternavn forplanter seg øyeblikkelig til hvert verk som viser til det, uten behov for gjentatte inngrep; navnevarianter, pseudonymer og former i ulike skriftsystemer samles om den samme entiteten, slik at et søk på hvilken som helst av dem likevel fører til det samme resultatet.
Hver autoritetspost samler den foretrukne formen av navnet, de registrerte variantformene, en biografisk eller beskrivende note og — avgjørende for samvirke — lenker til identifikatorene til de viktigste internasjonale instansene: VIAF, Library of Congress, ISNI, Bibliothèque nationale de France, SBN og Wikidata, for å nevne noen. Gjennom disse koblingene slutter entiteten å være lokale data og tar plass i det globale nettverket av bibliografiske autoriteter, der biografiske og geografiske data kan berikes automatisk fra de lenkede kildene.
Hver beskrivelse kan til slutt eksporteres i de viktigste RDF-formatene — Turtle, JSON-LD, N-Triples, RDF/XML, N-Quads — eller utforskes direkte i et miljø for grafspørringer.
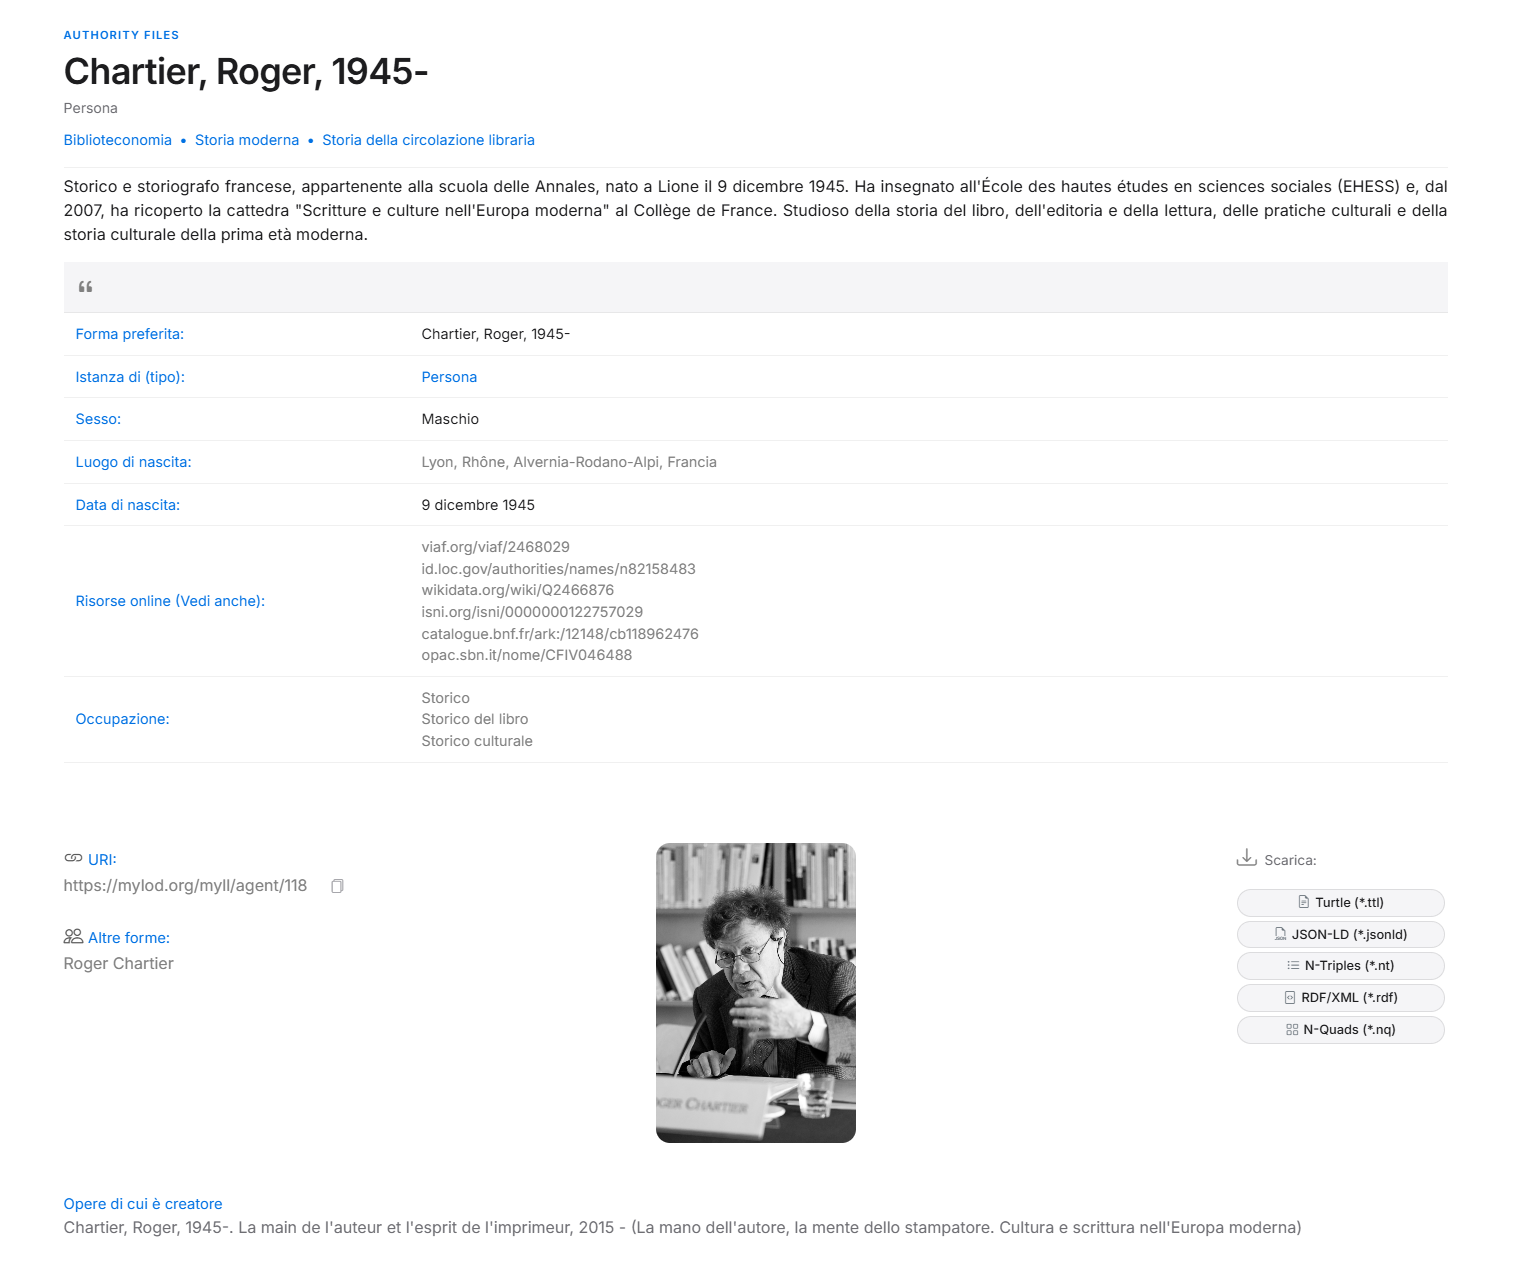
Autoritetspost med RDF-eksport, beriket automatisk fra Wikidata
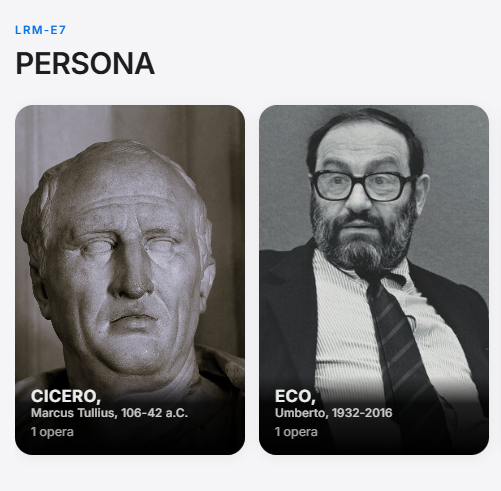
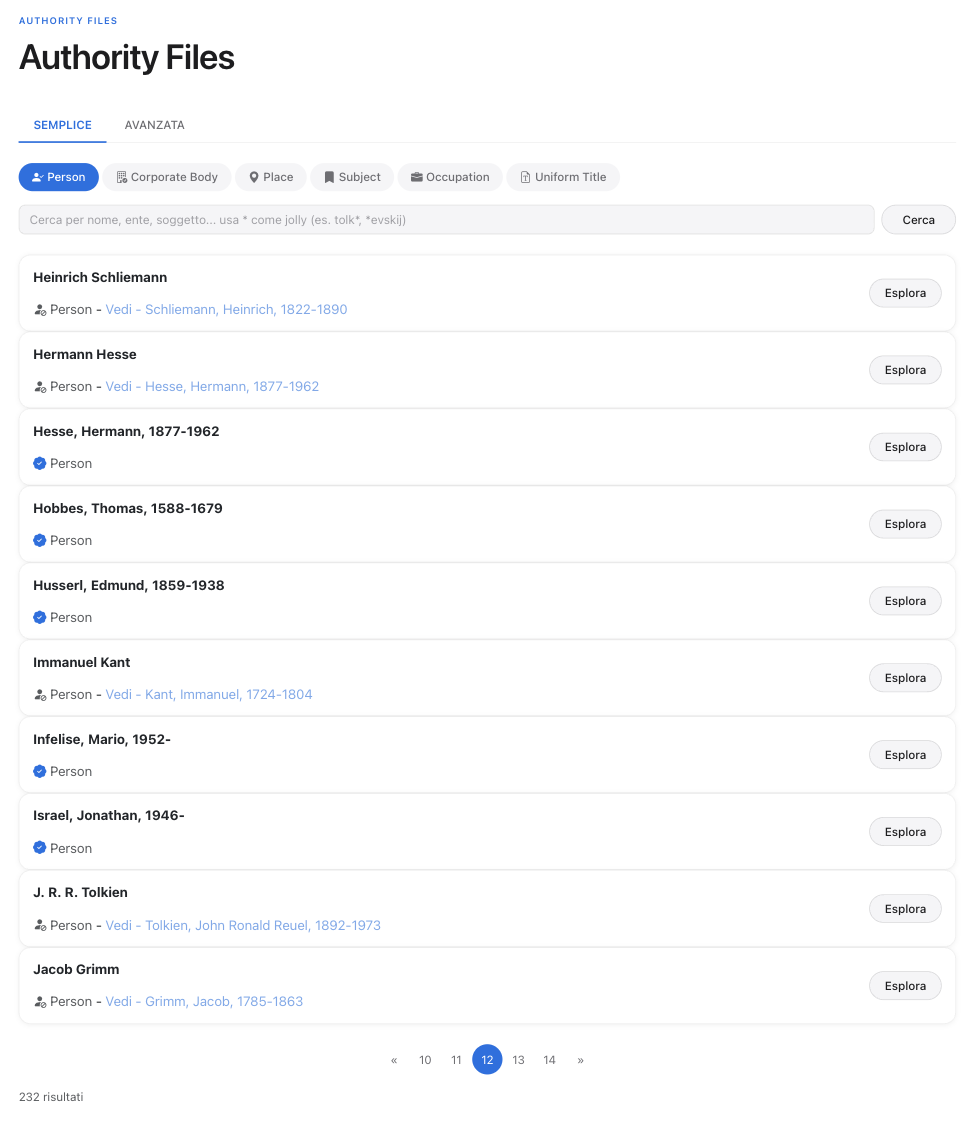
Personer som selvstendige entiteter, og det egne søket etter entitetstype
En søkbar datagraf
Hver entitet som er beskrevet i katalogen — verk, uttrykk, manifestasjoner, eksemplarer, agenter, steder, emner og perioder — publiseres samtidig som et sett RDF-tripler, den semantiske vevens elementære enhet, hver bestående av et subjekt, et predikat og et objekt. Egenskapene som brukes er ikke definert lokalt, men hentet fra standardvokabularene det internasjonale miljøet har tatt i bruk: BIBFRAME, FOAF og mange andre.
Det er denne strukturen som gjør at dataene kan forlate applikasjonens grenser. Et eksternt system som kjenner disse vokabularene kan tolke beskrivelsene til MYLODLibrary uten noen forutgående avtale, på samme måte som katalogen på sin side kan knytte seg til eksterne ressurser gjennom felles identifikatorer. Resultatet er ikke et lukket arkiv, men en node i et videre dokumentasjonsnettverk. Konverteringen av dataene fra MARC21-formatet til RDF (gjennom flere trinn både i produksjonen og i tilgjengelige dataformater, som MARCXML) er utformet for å gi katalogisatoren mulighet til å lære semantikken i RDF-data uten å forlate MARC21-formatet. Dette er mulig fordi to databaser eksisterer side om side: den relasjonelle, som MARC21 arbeider på, og den åpne, bygget for å holde data publisert for den semantiske veven.
Hele grafen av tripler kan søkes offentlig i SPARQL, det opprinnelige språket for å utforske RDF-data, gjennom et endepunkt som kun leser. For å senke terskelen og gjøre søkingen enklere tilbyr grensesnittet en samling ferdige spørringer — fordelingen av språk, forfatterne som var virksomme i et gitt århundre, de hyppigst forekommende emnene — som kan kjøres med én gang og deretter endres: en måte å lære språket på ved å se virkningene av det, uten forkunnskaper.
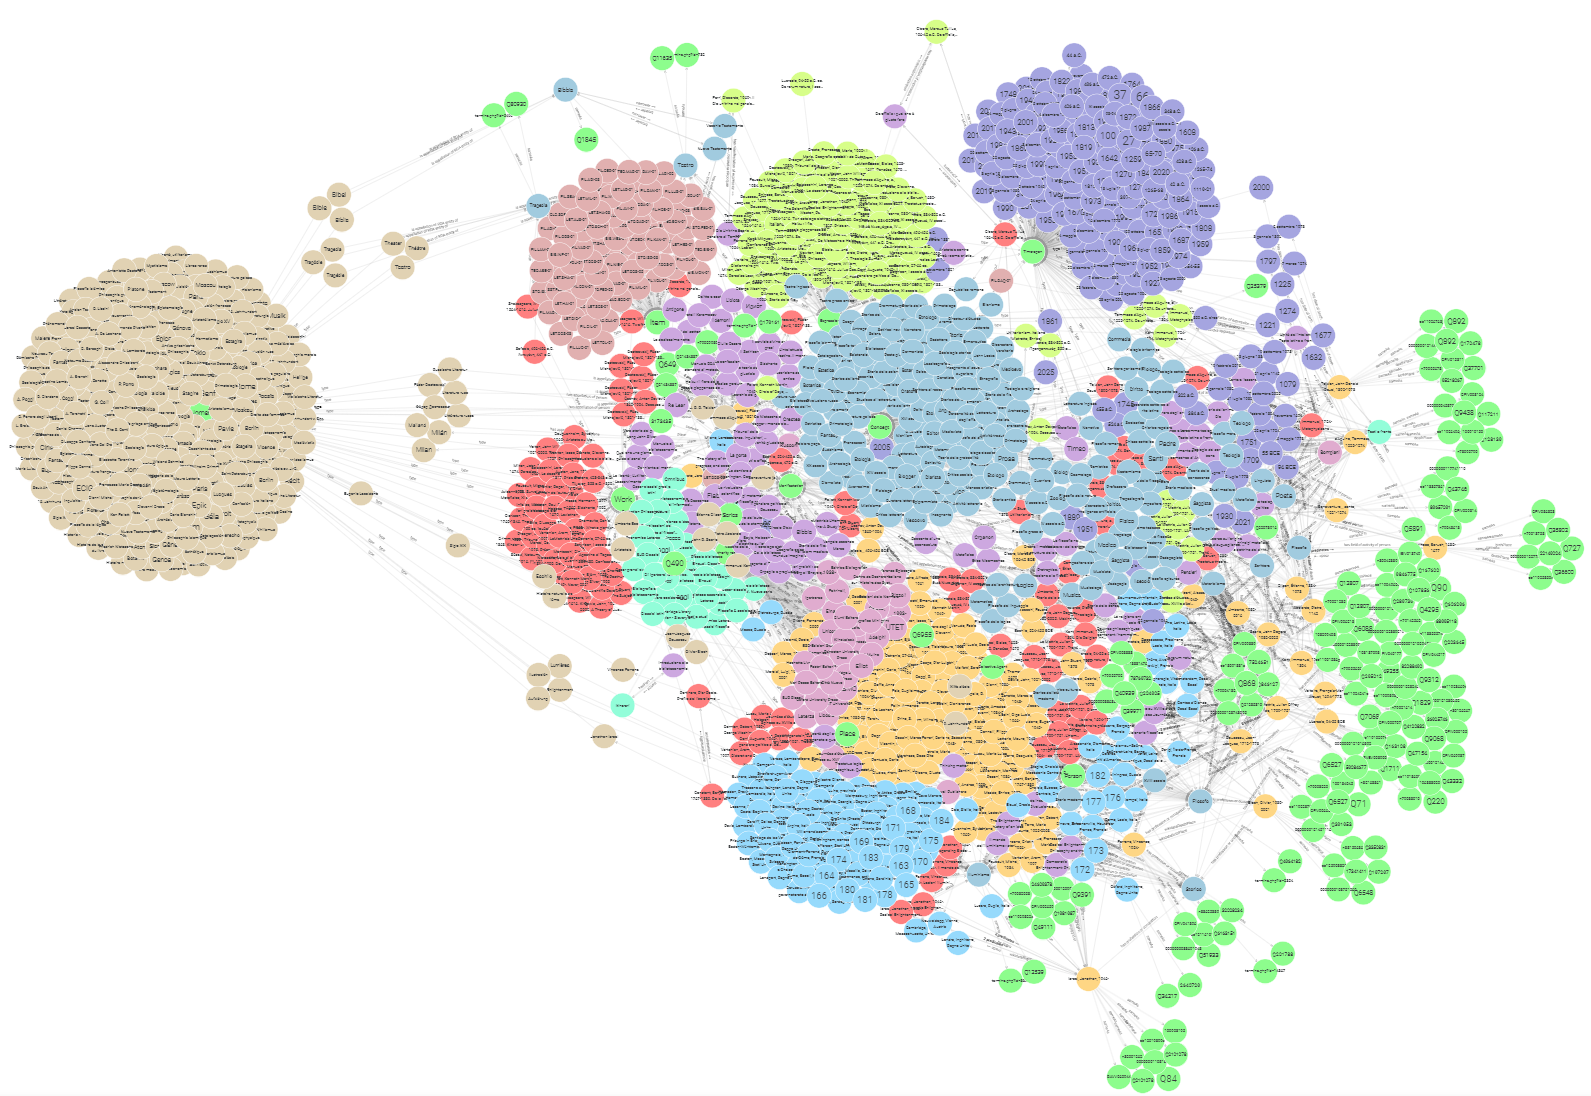
En del av katalogens RDF-graf: hver node er en entitet, hver kant en relasjon
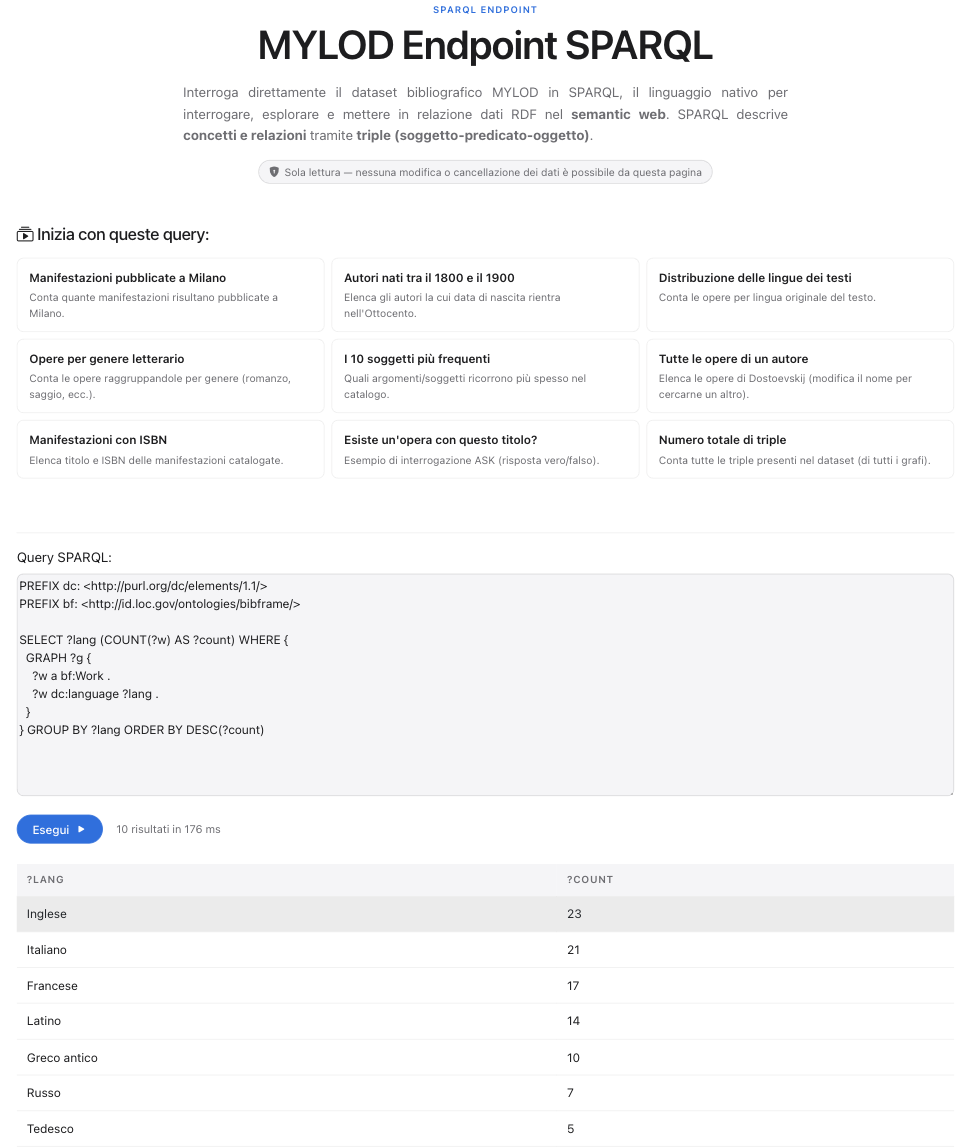
Det offentlige SPARQL-endepunktet, med ferdige eksempelspørringer
MARC21, født i RDF og ditt personlige område
På produksjonssiden følger MYLODLibrary to parallelle veier i stedet for å påtvinge én. Den første tar utgangspunkt i det tradisjonelle biblioteksformatet: en MARC21-post settes opp etter innarbeidet praksis, og en automatisk prosedyre utleder av den, felt for felt, de tilsvarende LRM-entitetene, og genererer kjeden Verk-Uttrykk-Manifestasjon-Eksemplar og de tilhørende autoritetskoblingene. Den andre gjør det mulig å katalogisere direkte etter modellene RDA og IFLA LRM, gjennom en pakke med skjemaer viet hver entitet i modellen.
De to veiene er ikke alternativer til hverandre, men svar på ulike behov: den første ivaretar opplæringsinvesteringen og arbeidsflyten til dem som allerede arbeider i MARC21, den andre gjør det mulig å utnytte uttrykkskraften i LRM-modellen uten begrensningene i et format som ble unnfanget i en annen teknologisk tid. Begge møtes i den samme katalogen og den samme RDF-grafen. Det betyr at hver entitet oppfyller katalogiseringskravene uavhengig av hvilket format som velges. Enten man produserer data født i RDF eller tar utgangspunkt i MARC21, kommer man like fullt fram til den kaskadevise publiseringen i WEMI-systemet.
Hver registrert bruker får dessuten et personlig katalogiseringsområde — et laboratorium der man kan øve og bygge sine egne beskrivelser, enten fra bunnen av eller fra en ferdig utfylt eksempelpost. Data man arbeider med i dette området forblir strengt private: de vises ikke i den offentlige katalogen, er ikke synlige for andre brukere og går ikke inn i den søkbare grafen. Dette er en nødvendig forutsetning for at verktøyet også skal kunne brukes i undervisning, der feil — og eventuelt melding om vedlikeholdsproblemer på plattformen — er en del av prosessen med å vokse og lære.
Det personlige området er likevel ikke avskåret fra resten av katalogen: en katalogisator står fritt til å gjenbruke autoritetsentiteter som allerede er offentlige — en agent, et sted, et emne, et yrke — akkurat slik en erfaren katalogisator ville gjort, og unngår unødig dublering. Uttrykk, manifestasjoner og eksemplarer forblir derimot alltid ens egne, atskilte entiteter: selv når de beskriver et verk som allerede finnes i den generelle katalogen, blir de aldri slått sammen med eller lagt oppå eksisterende poster. Skillet er bevisst: autoriteter er felles arv, detaljert bibliografisk beskrivelse forblir personlig.
Beskrivelsesmodellen er ikke begrenset til den trykte boken: håndskrifter og sjeldne bøker har egne seksjoner — materiale, legg- og fascikkelstruktur, skrift, innbinding, fingeravtrykk, trykkermerke — og, for håndskriftene, en modul for TEI/XML-transkripsjon som kan genereres automatisk ut fra metadataene som allerede er katalogisert, eller importeres fra en fil laget andre steder og valideres mot det offisielle TEI-skjemaet. Som et siste ledd kan hver manifestasjon ha sitt eget digitale eksemplar — en PDF lastet opp direkte til plattformen, som kan vises fra den offentlige posten uten behov for ekstern programvare.
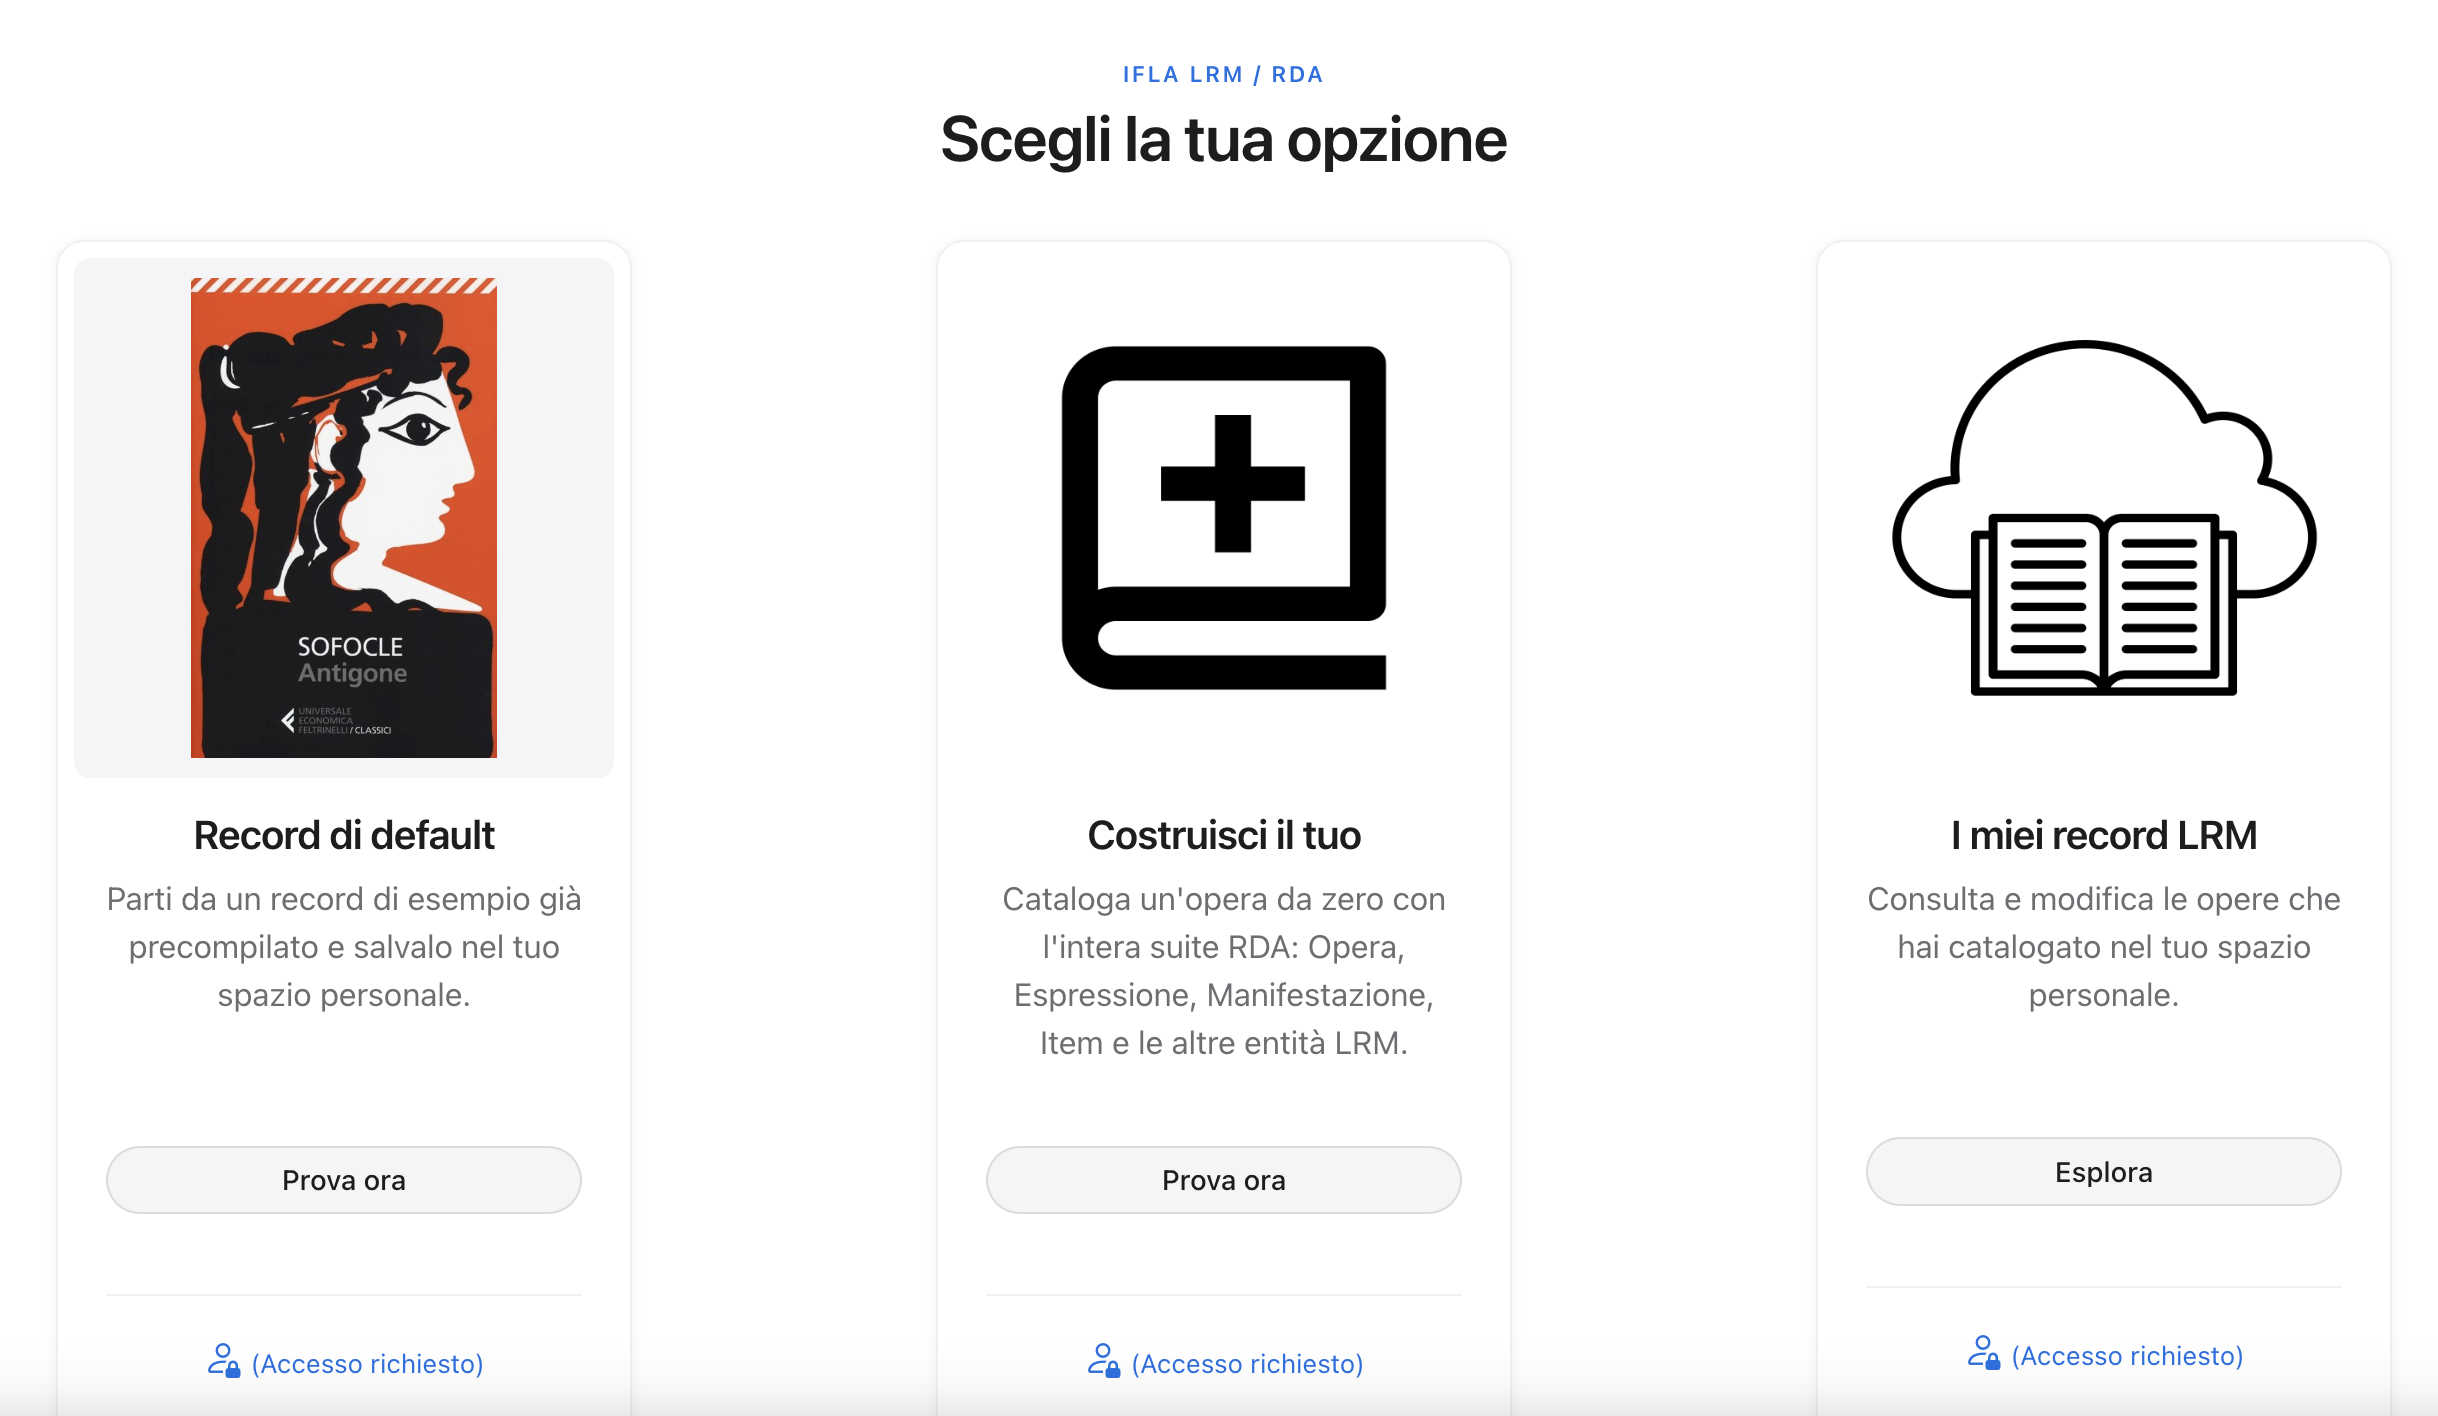
Navet for katalogisering født i IFLA LRM/RDA, med katalogisatorens personlige område
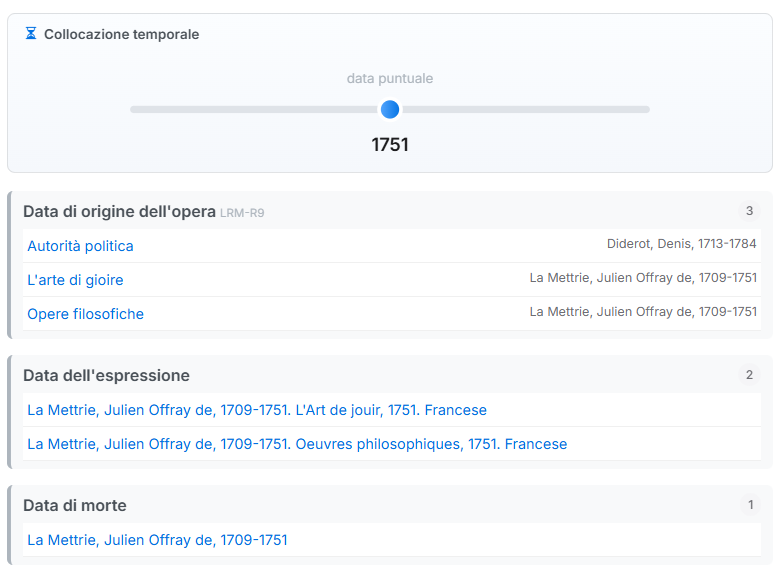
Naviger relasjonene mellom ressursene gjennom entiteten Tidsrom