MYLODLibrary は、リソースを、孤立した自己完結的なレコードとしてではなく、Linked Open Data の論理、概念モデル IFLA LRM、および目録規則 RDA に従って相互に関連づけられた実体のネットワークとして記述する書誌目録です。
前提となる考え方は、目録は資料の存在を証明するだけにとどまるべきではなく、そこを貫く関係を明示すべきだというものです。すなわち、ある著作とその翻訳との結びつき、ある版と所蔵されている一冊との結びつき、ある著者とその著作全体との結びつき、あるテキストとそれが扱う主題との結びつき、そしてさらに多くの関係です。従来の書誌記述はこうした関係を叙述的で閉じた形で述べており、人間の読者には理解できても、機械処理にとっては不透明でした。ここではそれらが形式的な構造として符号化されているため、問い合わせが可能であり、検証可能であり、第三者のシステムから再利用することもできます。
本プロジェクトは二つの目録作成の道筋 — 伝統的な図書館用フォーマットである MARC21 と、IFLA LRM によるネイティブ記述 — を統合しています。両者は同一の公開目録に合流し、SPARQL エンドポイントを通じても自由に問い合わせ可能な単一の RDF データグラフを形成します。以下の各節では、閲覧インターフェースからデータの生成・公開のためのツールに至るまで、その主要な構成要素をたどります。
読者の方へ: MYLODLibrary の目録に含まれるリソースは、常に更新されている私的・個人的な蔵書に属しており、研究およびプロジェクトの発展のために提供することを目的として公開されています。そのため、Item(個別資料)の記述のレベルでは、データは MYLOD の調査・成果を検証し、データ入力および Linked Open Data の構築のための学習ツールを提供することのみを目的としている点にご留意ください。
検索と探索
一般目録は MYLODLibrary に記述された蔵書への入口であり、閲覧者にとって最も見通しの良い観測点でもあります。検索は簡易な形式 — タイトル・著者・主題による検索で、部分検索のためのワイルドカードにも対応 — でも、高度な形式 — ブール演算子(AND、OR、NOT)によって複数の条件を組み合わせ、目的のものだけが残るまで結果集合を段階的に絞り込む — でも行えます。
閲覧インターフェースは、文脈を分析的に示します。結果一覧の傍らに、動的に算出された統計のパネルが、閲覧中の目録の部分集合を、テキストの言語・出版地と出版年・関係主体などごとに分解して示します。結果を登録方式で絞り込む機能により、利用者は、RDF ネイティブ形式で、あるいは必要に応じて MARC21 から出発して公開されたものの全体像を把握できます。こうして検索は単なるレコードの取得ではなくなり、分析の道具となります。閲覧者が得るのは一覧だけではなく、自らが切り出した部分集合の量的な一覧表です。
さらに各結果は、生成されたトリプルの総数を示すことで自らの来歴を明示し、記述の背後にある情報の密度を直ちに感じ取れるようにしています。ここから著作の完全なレコードと、それが利用可能なすべての形式へ進むことができます。
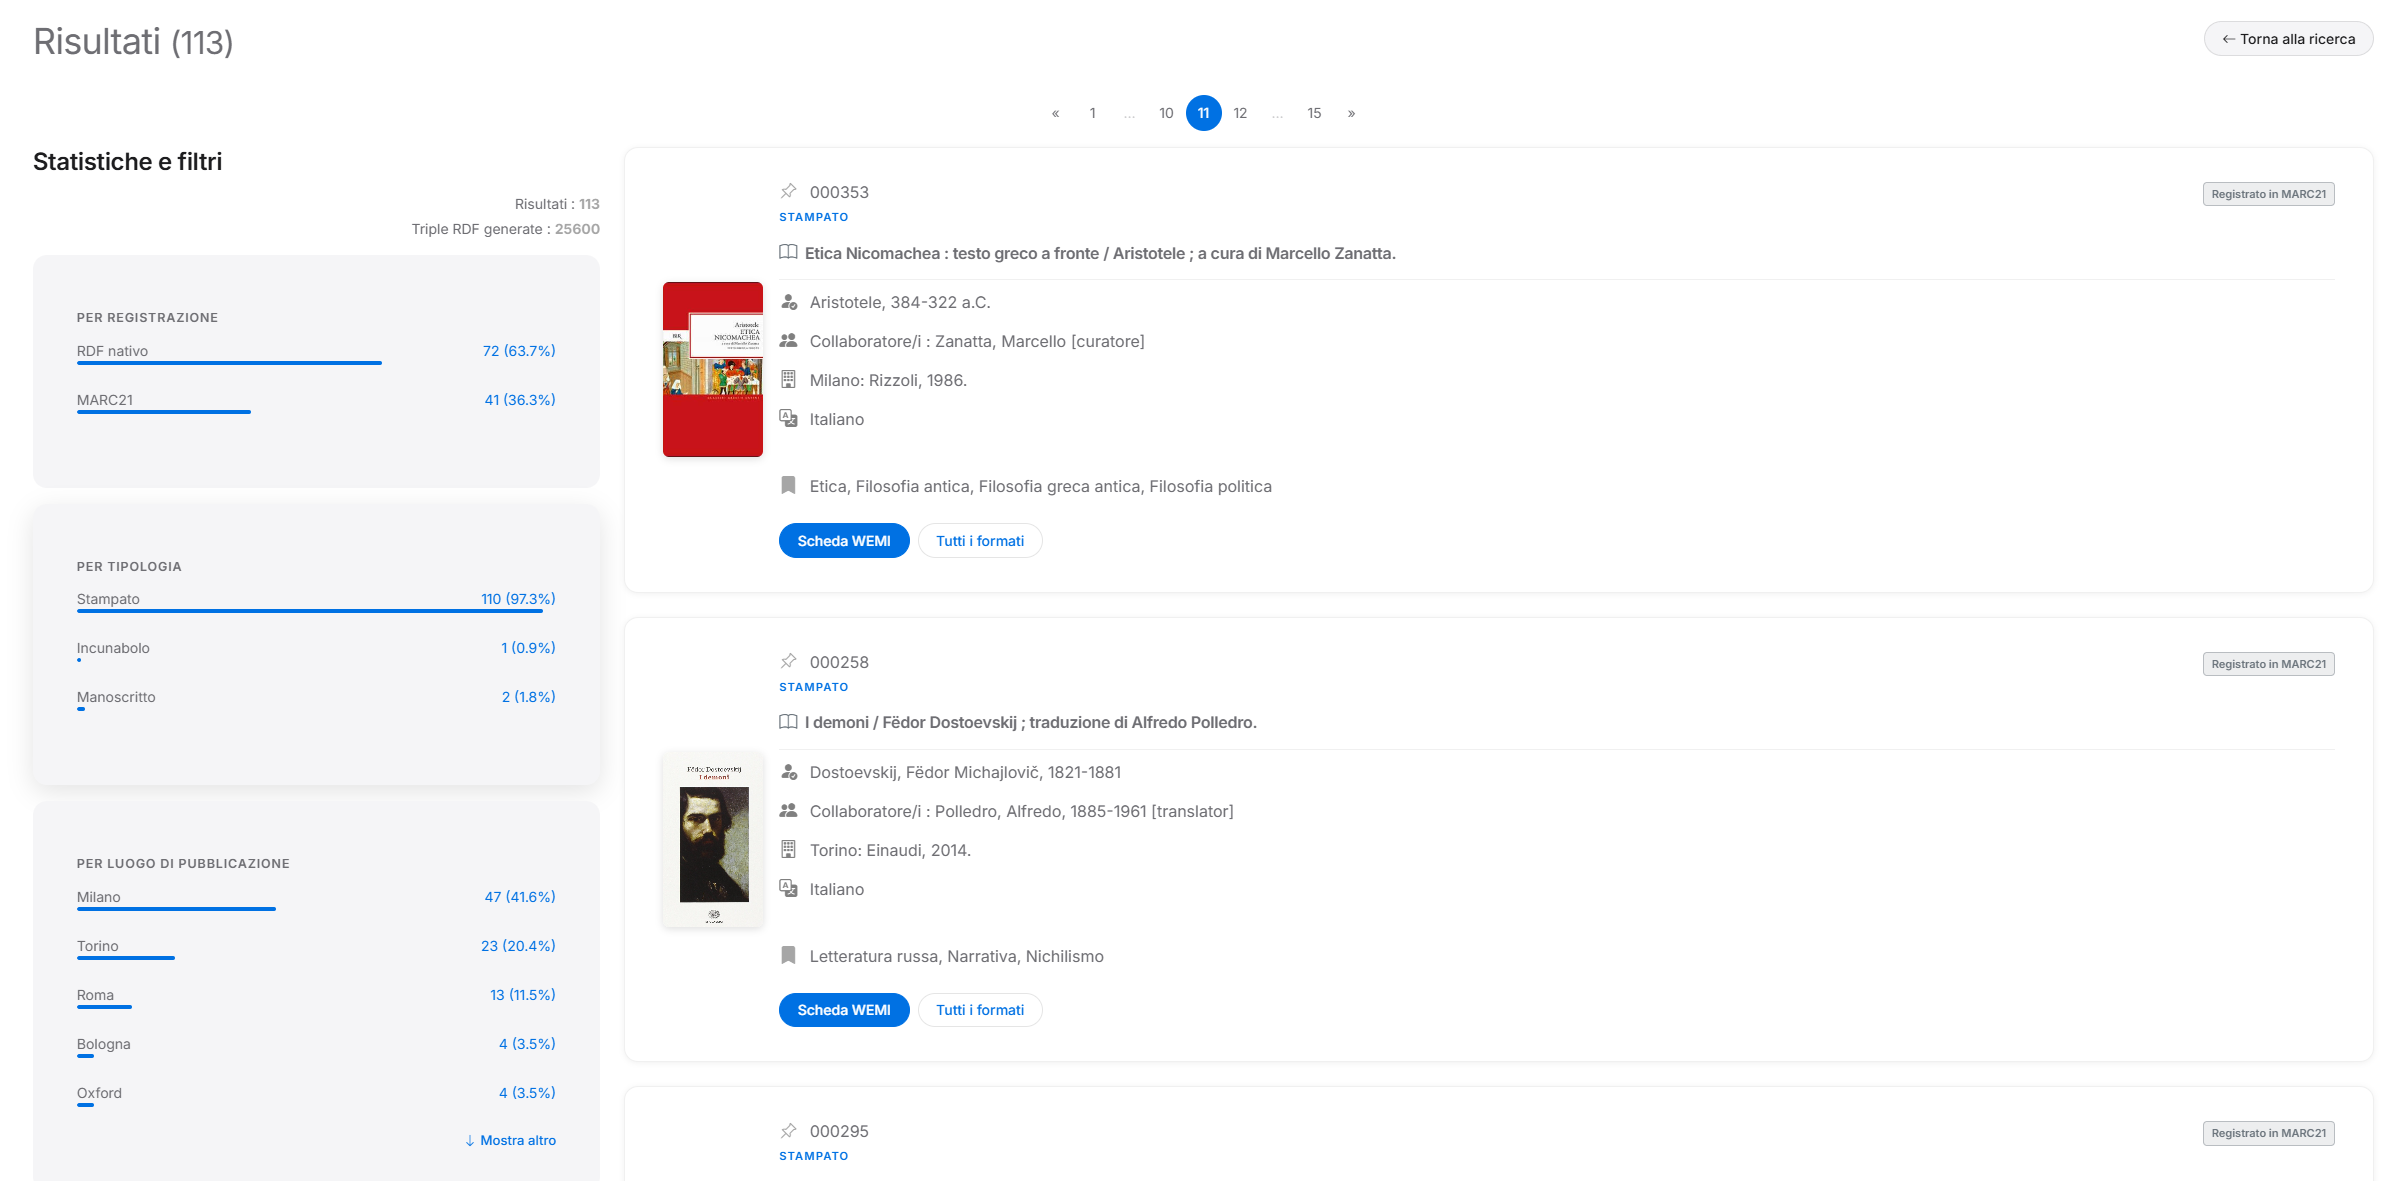
一般目録での検索。フィルターとリアルタイム統計付き
著作・表現形・体現形・個別資料
本プロジェクトの概念的な骨格の中心に置かれているのが IFLA Library Reference Model です。これは国際的な図書館コミュニティが資料の記述を捉え直すために築いた参照枠組みです。その原理は、私たちが普通「一冊の本」と呼ぶものが、実際には単一の対象ではなく、区別される四つの実体が階層的に結びついて重なり合ったものだ、というところにあります。
著作とは抽象としての知的内容です — たとえば『神曲』は、どのように読まれるかとは無関係に、知性の創造物としてそこにあります。表現形はその具体的な実現です。ある特定の翻訳、校訂版、ある言語による版などがこれにあたります。体現形は物理的に制作・出版された版に対応し、出版者・出版年・ISBN を伴います。そして個別資料とは、実際に所蔵され書架に置かれている一冊そのものです。
これら四つの層を単一のレコードに圧縮せず個別に記述することで、平板な記述では問いとして立てることすらできない事柄に目録が答えられるようになります。ある著作にいくつの翻訳が存在するのか、どの版として出版されたのか、どの資料が所蔵されているのか。さらに各実体は、それを生み出した行為主体、扱う主題、言及する場所や時代とも関連づけられます。
これらの関係の網の目全体は、各レコードの画面から自動生成される対話的なグラフとして確認できます。書誌記述を支える意味論的な構造を可視化し、教育的にも読み取りやすくする道具です。この仕組みはデータを生成する情報システムにとっても助けとなります。目録作成者が記述しうるすべての関係を、機械が自動的に生成・管理・保存できるようにするからです。これにより、目録を利用する人は、資源が内包する、あるいは資源が導きうるさまざまな文脈のあいだを、目録の内外を問わず自由に行き来できるようになります。
同じ関係のロジックは、行為主体同士の間にも及ぶ。ある人物は団体の構成員として、団体は合併・分割・名称変更などによって別の団体に先行または後続すると宣言でき、二つの行為主体がより一般的に関連しているとも記録できる。これらの関係も IFLA LRM が定める関係タイプに基づいてモデル化され、RDFトリプルとして公開され、各行為主体の公開ページに表示される。
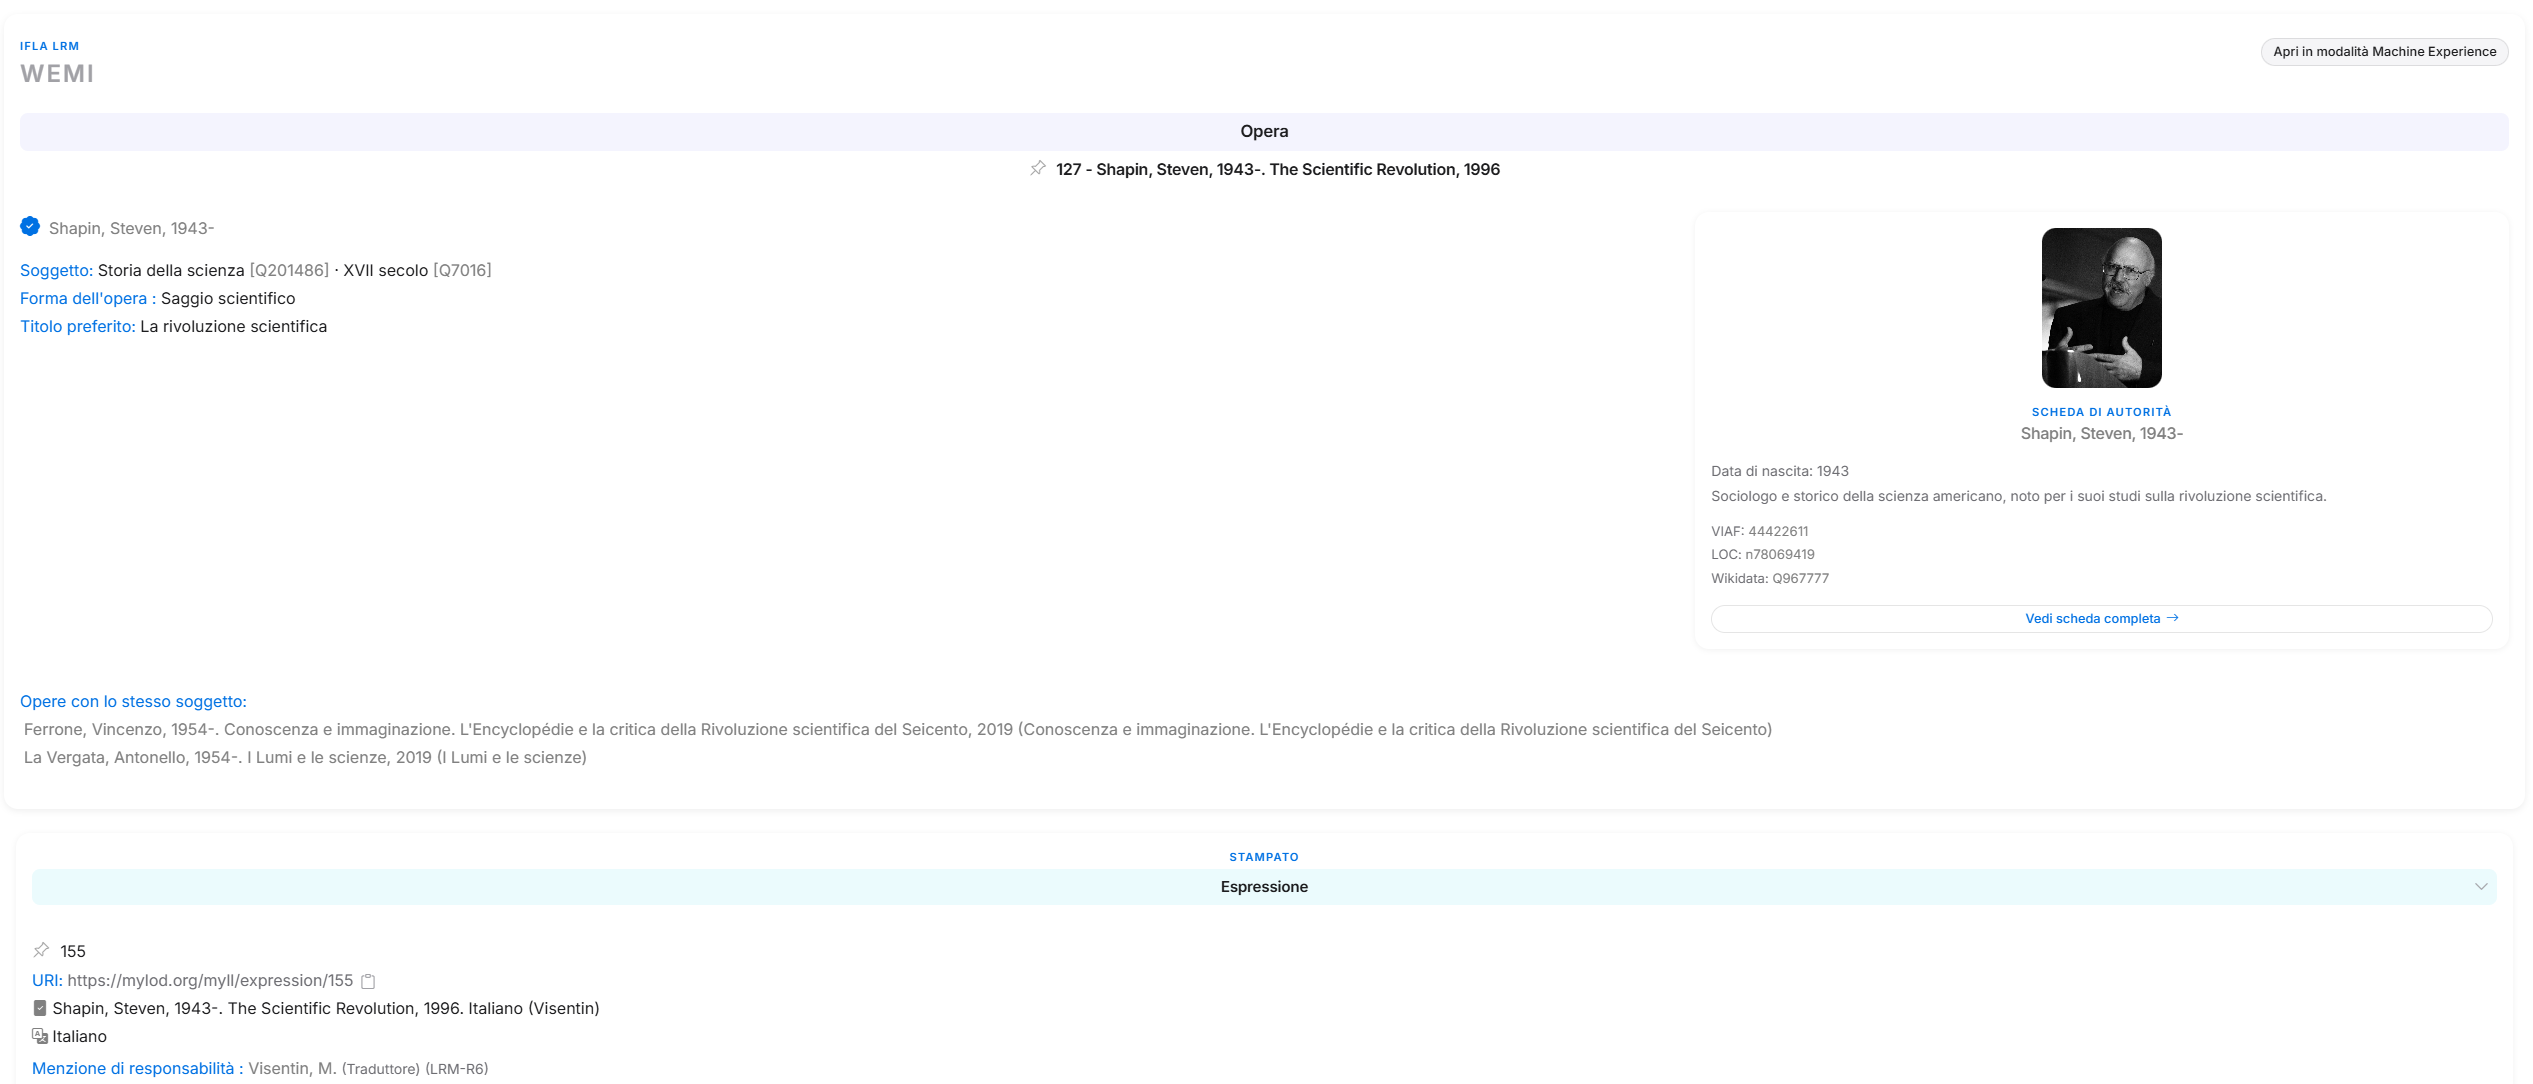
著作 → 表現形 → 体現形のカスケード。傍らに行為主体の典拠レコード
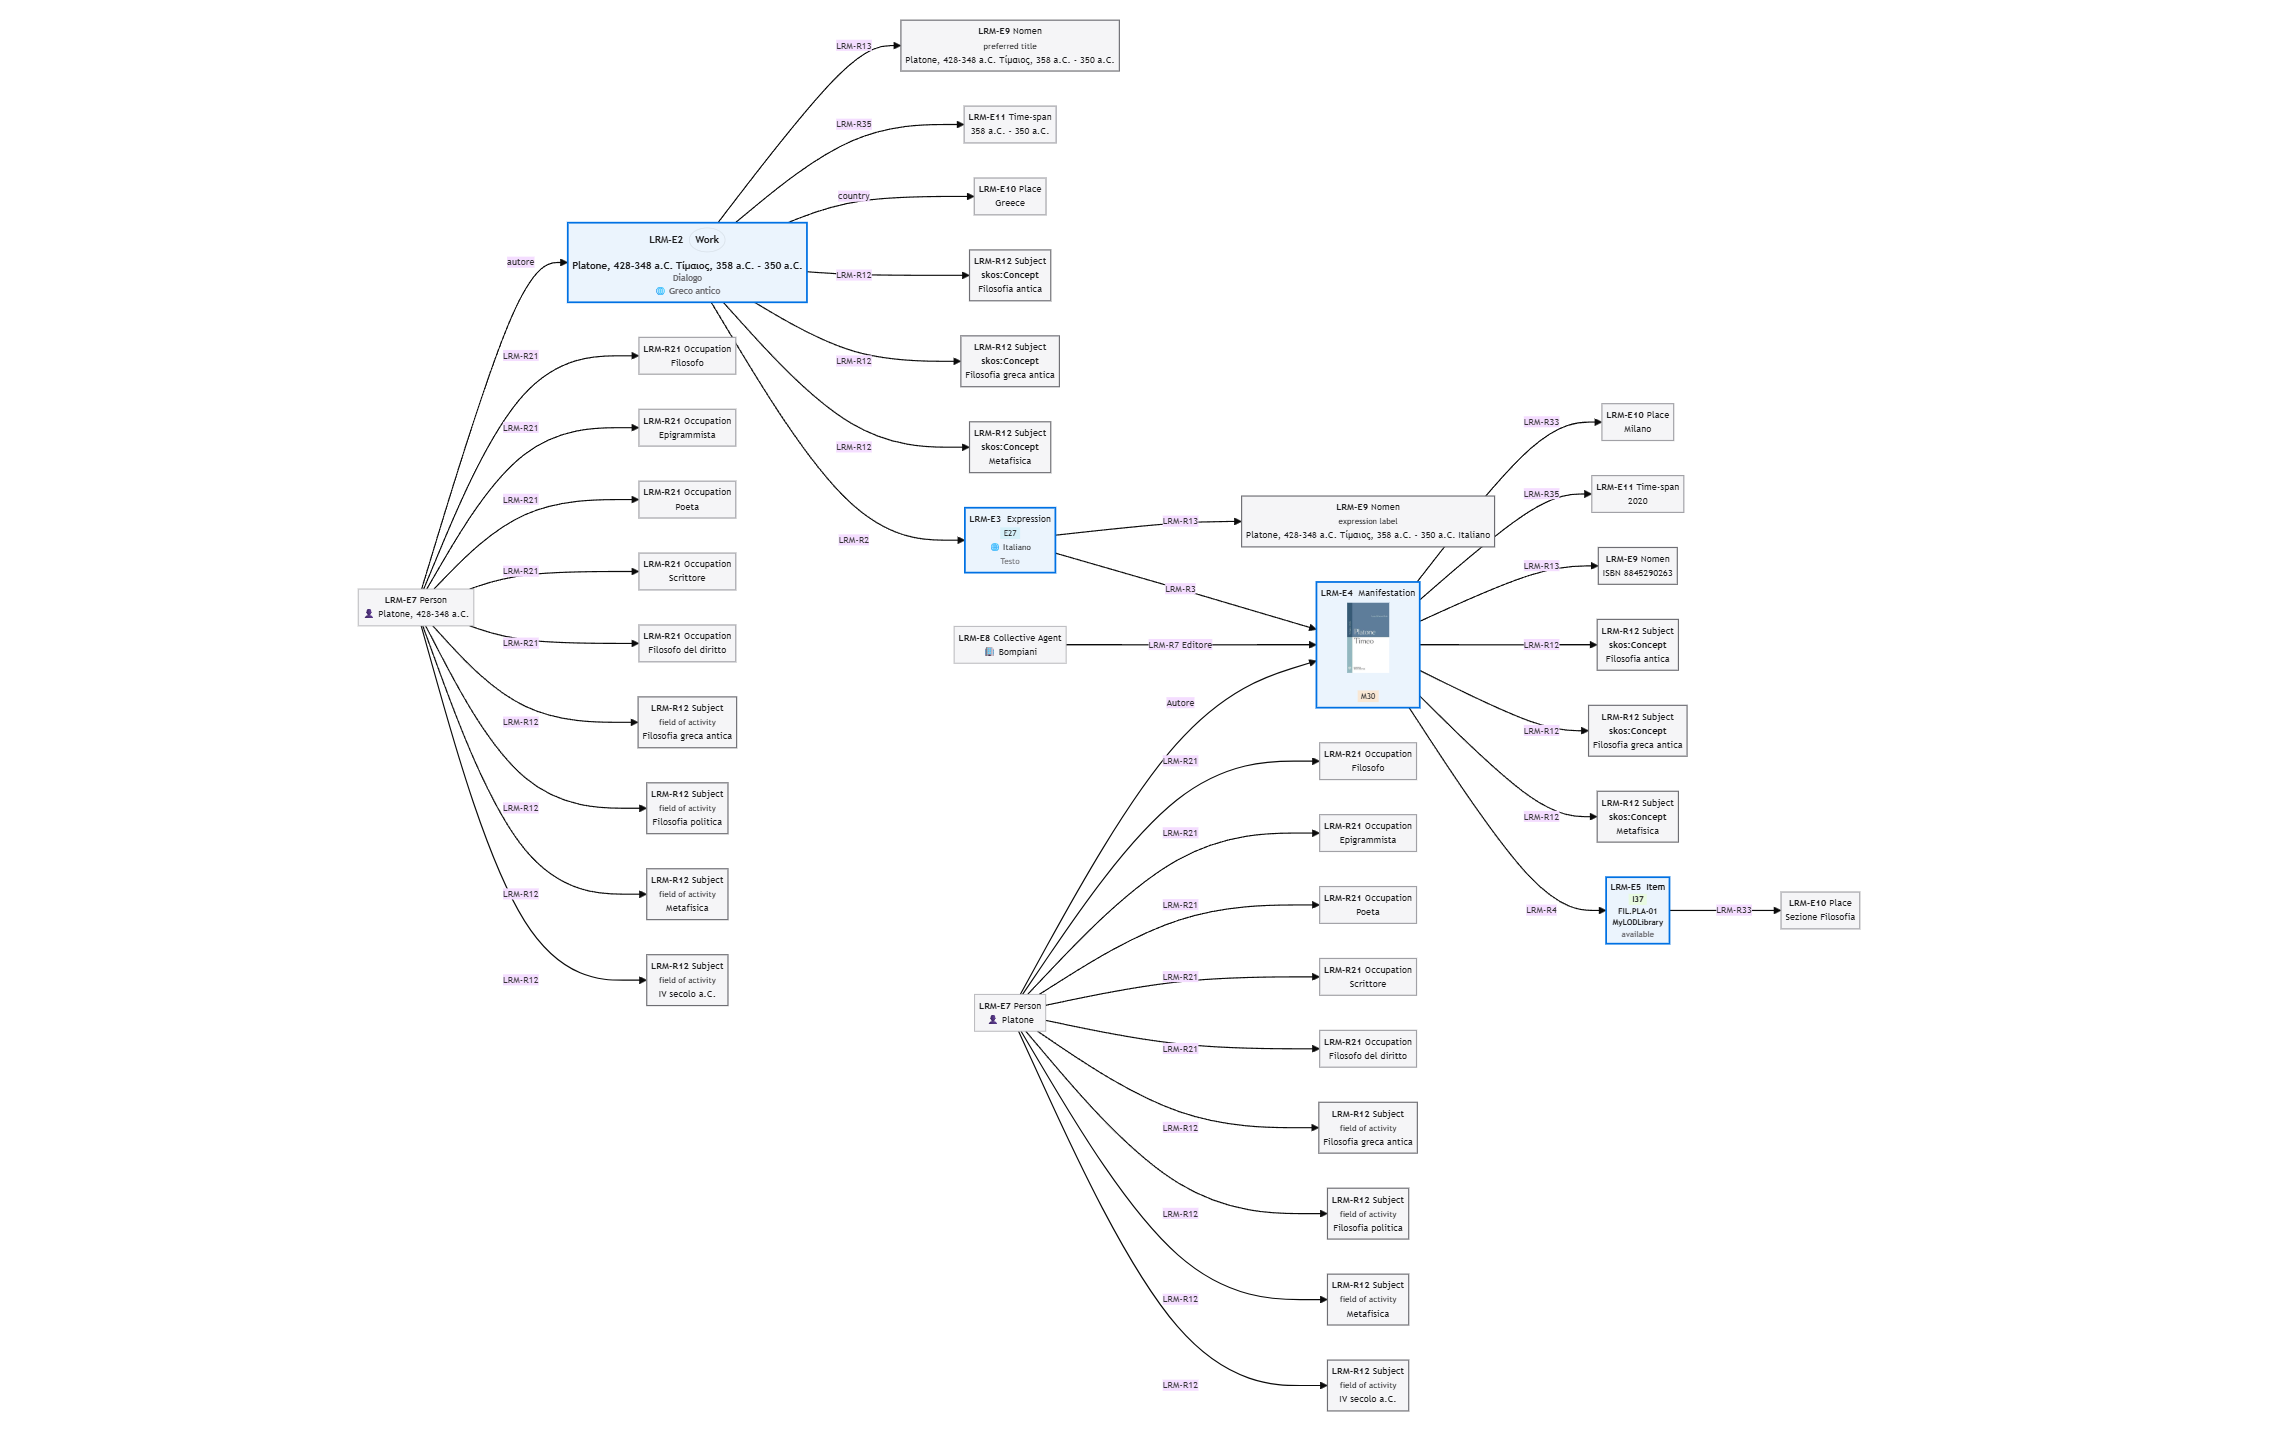
LRM 関係グラフ。各著作について自動生成される
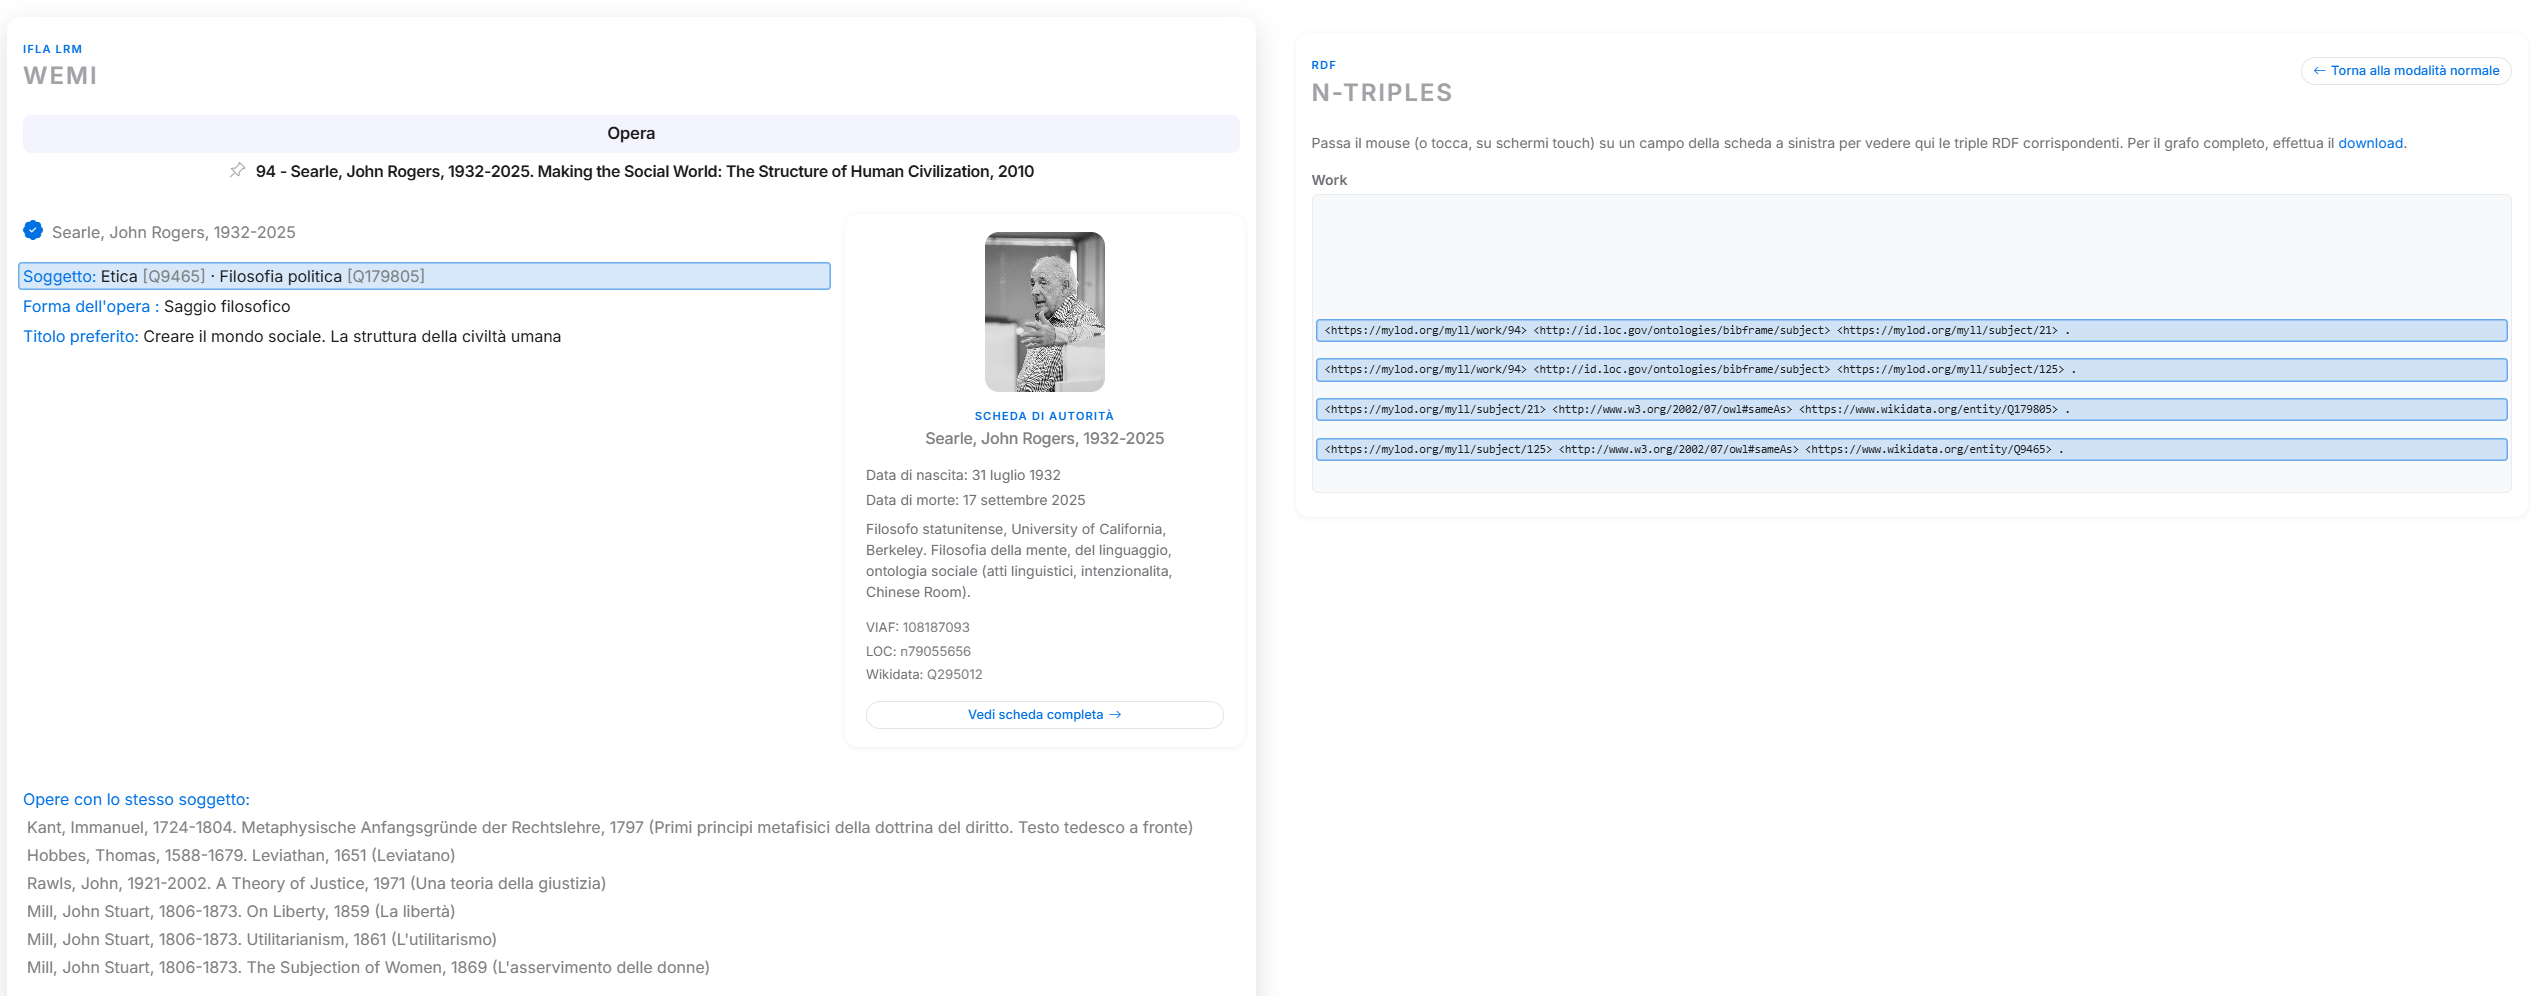
自然言語とマシン言語を並行して息づかせ、あなたのRDFトリプルを探索する
実体としての行為主体・場所・主題
著者、団体、場所、主題、職業、統一タイトルは、各レコードに複製された文字列として目録に現れるのではなく、自律した典拠実体として存在します。すなわち一度だけ記述され、固有の永続的識別子を与えられ、現れるところではどこでも参照によって呼び出されます。これは典拠コントロールの原理であり、ここではモデルが定めるすべての実体クラスに体系的に適用されています。
ここから具体的な帰結が生まれます。ある著者の名前の形を訂正すれば、それを参照するすべての著作に即座に反映され、同じ作業を繰り返す必要がありません。異なる名称形、筆名、異なる文字体系による形は同一の実体へ収束するため、そのいずれで検索しても同じ結果にたどり着くことが保証されます。
各典拠レコードは、優先形の名称、記録された異形、伝記的あるいは記述的な注記、そして相互運用性にとって決定的な要素である主要な国際機関の識別子へのリンク — VIAF、Library of Congress、ISNI、Bibliothèque nationale de France、SBN、Wikidata など — をまとめています。こうした対応づけによって、実体は局所的なデータであることをやめ、書誌典拠の世界的なネットワークの中に位置づけられます。そこでは伝記的・地理的データを、リンクされた情報源から自動的に補完することができます。
各記述は最終的に主要な RDF 形式 — Turtle、JSON-LD、N-Triples、RDF/XML、N-Quads — で書き出すことができ、グラフ問い合わせ環境で直接探索することもできます。
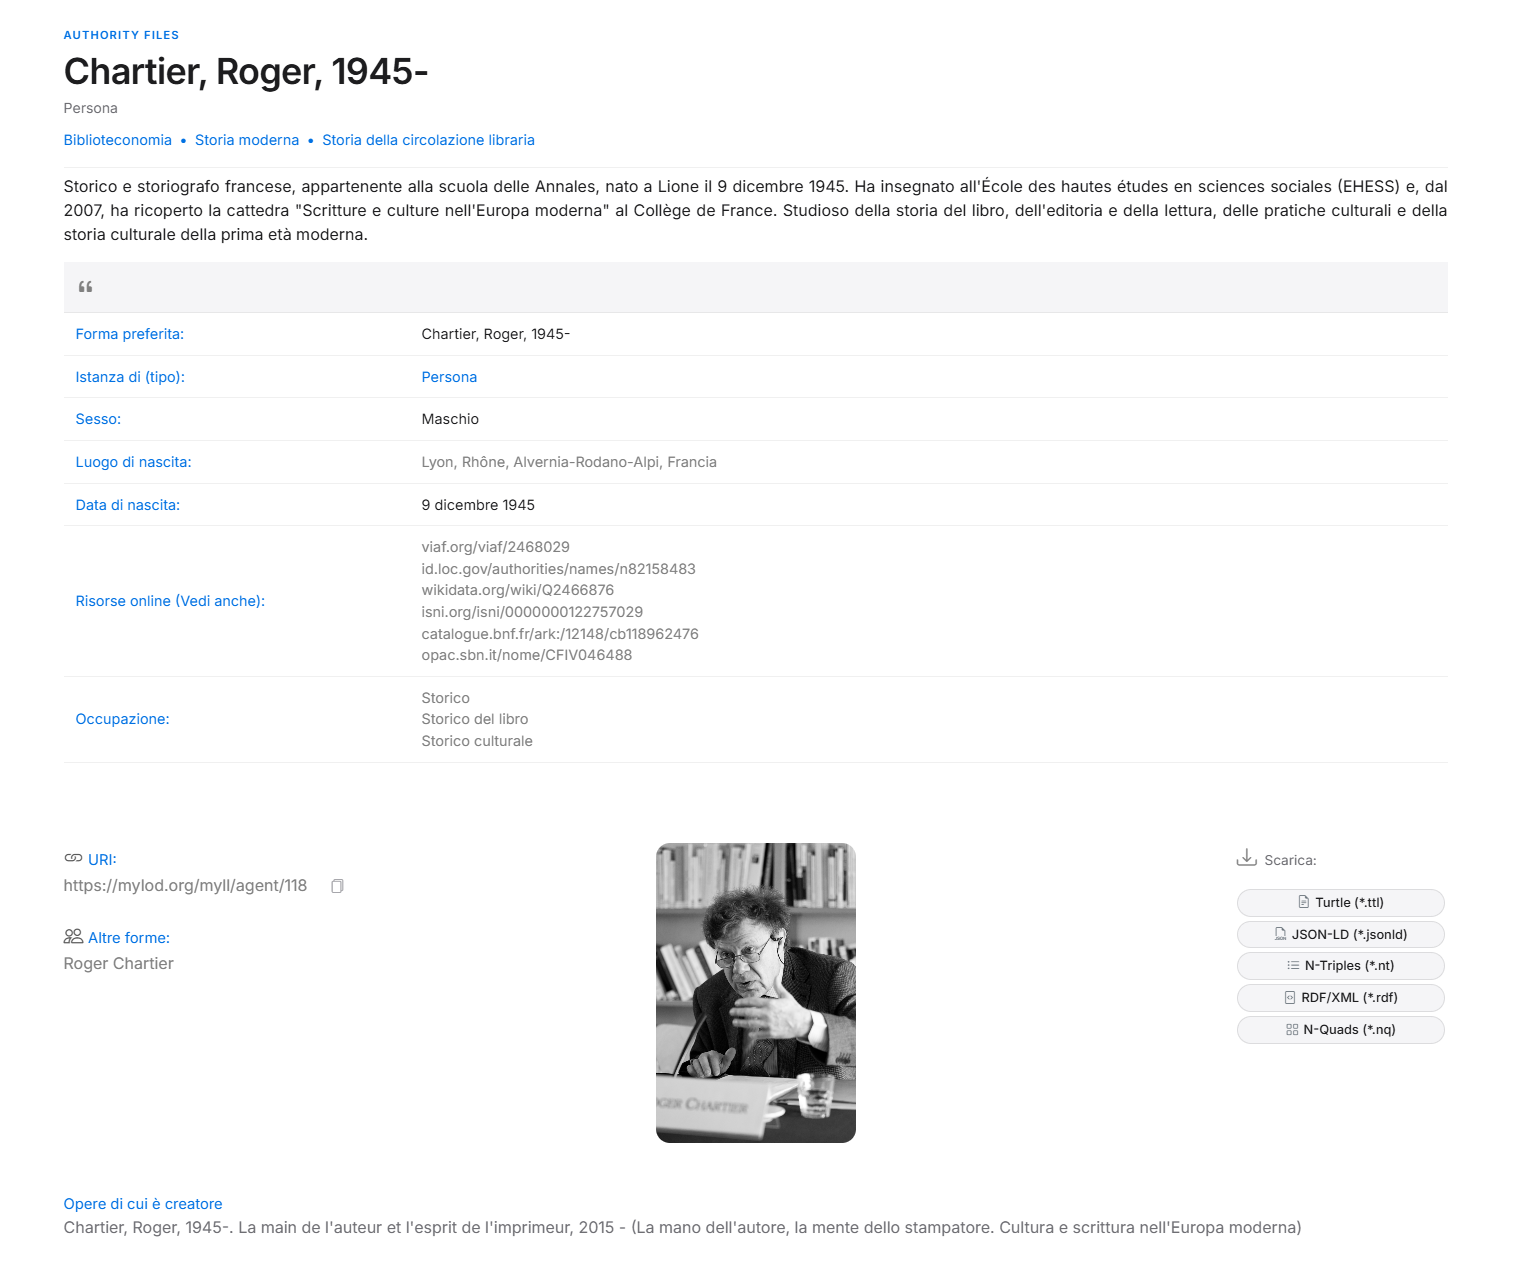
RDF 書き出しに対応した典拠レコード。Wikidata から自動的に補完
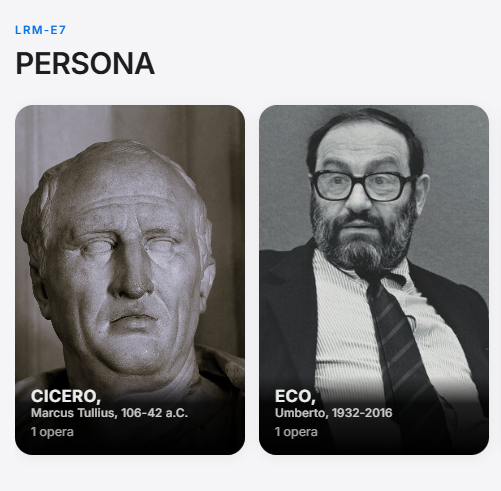
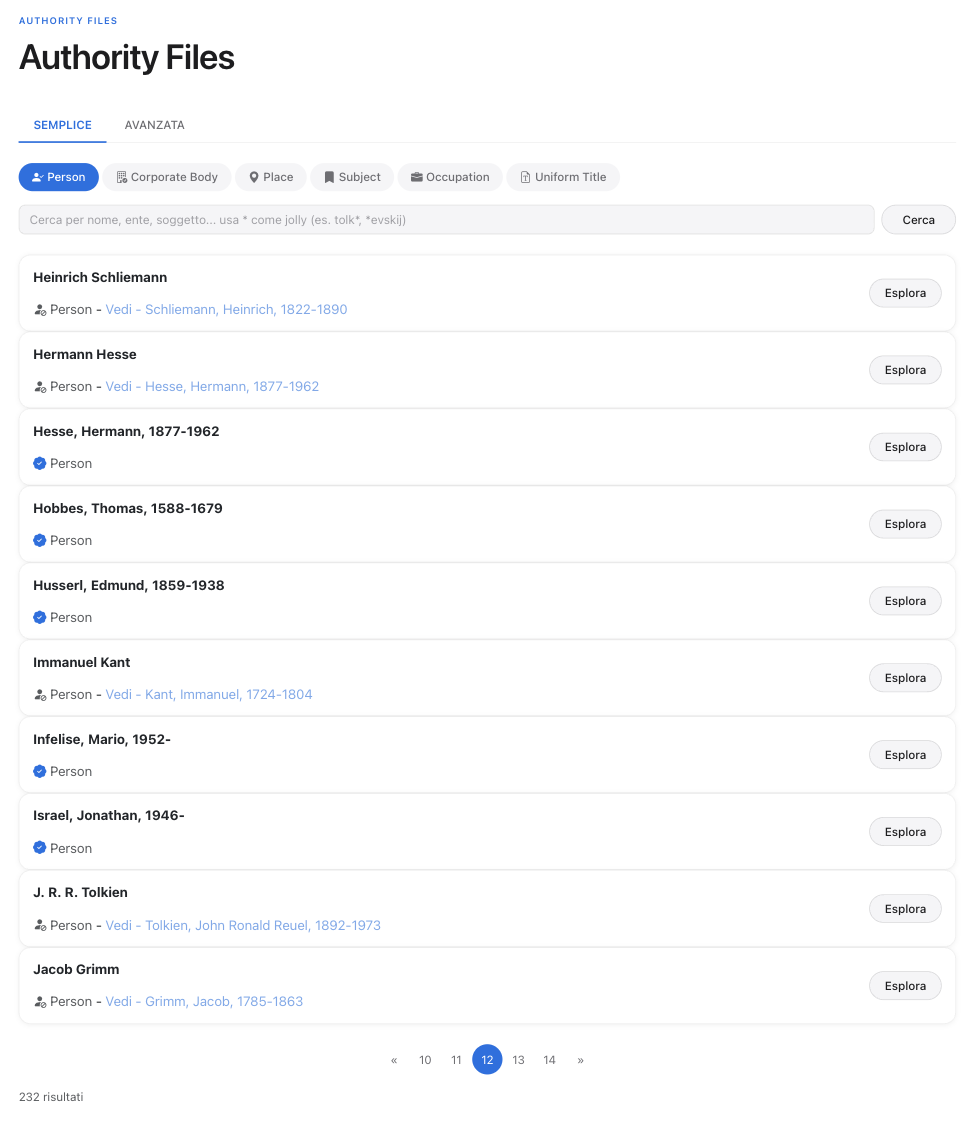
自律した実体としての人物と、実体種別ごとの専用検索
問い合わせ可能なデータグラフ
目録に記述されるすべての実体 — 著作、表現形、体現形、個別資料、行為主体、場所、主題、期間 — は、同時に RDF トリプル(セマンティック・ウェブの基本単位で、それぞれ主語・述語・目的語から成る)の集合として公開されます。用いられるプロパティは局所的に定義されたものではなく、国際コミュニティが採用した標準語彙 — BIBFRAME、FOAF など — から取り入れられます。
この構造こそが、データがアプリケーションの境界の外へ出ることを可能にします。これらの語彙を知っている外部システムは、事前の取り決めなしに MYLODLibrary の記述を解釈でき、目録もまた、共有された識別子を通じて外部資源とつながることができます。その結果生まれるのは閉じた書庫ではなく、より広い文献ネットワークの中の一つのノードです。MARC21 形式から RDF へのデータ変換は(MARCXML のような利用可能なデータ形式や、いくつかの生成段階を経て)、目録作成者が MARC21 形式を離れることなく RDF データの意味論を学べるように設計されています。これは二つのデータベースの並行的な共存によって実現されます。すなわち、MARC21 が動作するリレーショナルなデータベースと、セマンティック・ウェブ向けに公開されるデータを収めるために構築された開かれたデータベースです。
トリプルからなるグラフ全体は、読み取り専用のエンドポイントを通じて、RDF データの探索のためのネイティブ言語である SPARQL で公開的に問い合わせできます。参入の敷居を下げ、検索を容易にするため、インターフェースはあらかじめ用意された問い合わせ — 言語の分布、ある世紀に活動した著者、最も頻出する主題など — のコレクションを提供します。これらは即座に実行し、その後に編集することができます。事前の知識がなくても、その効果を観察しながら言語を学ぶための方法です。
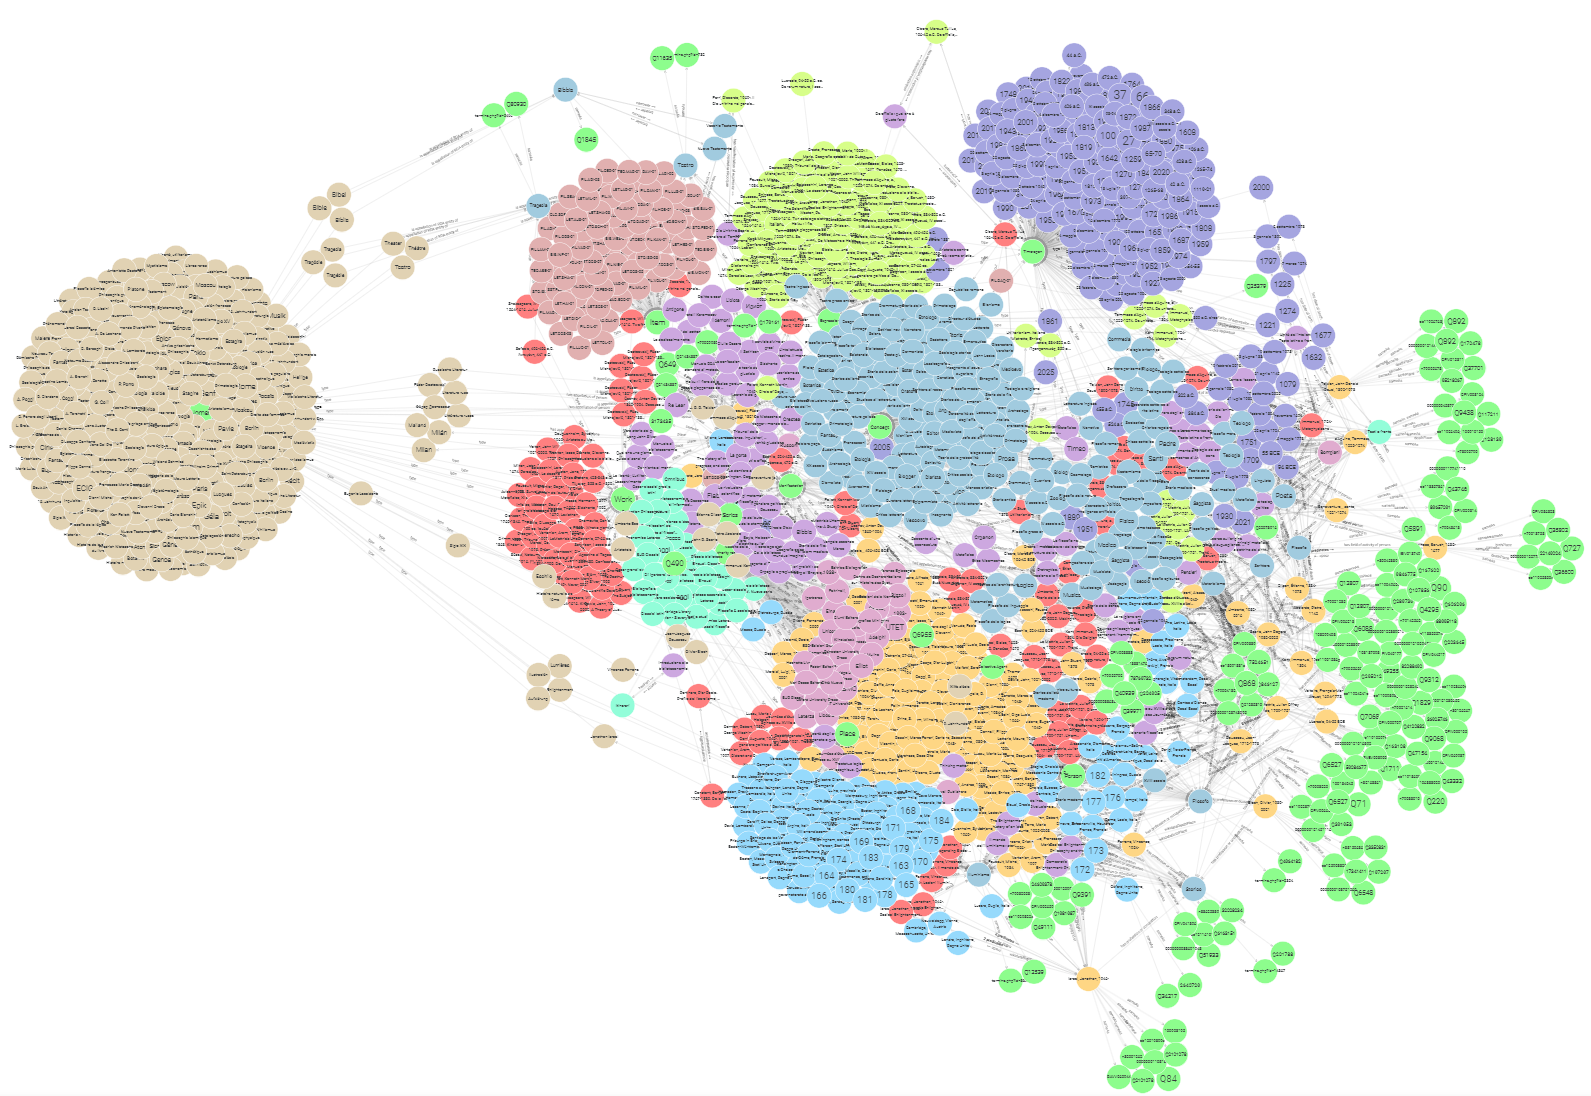
目録の RDF グラフの一部。各ノードが実体、各辺が関係
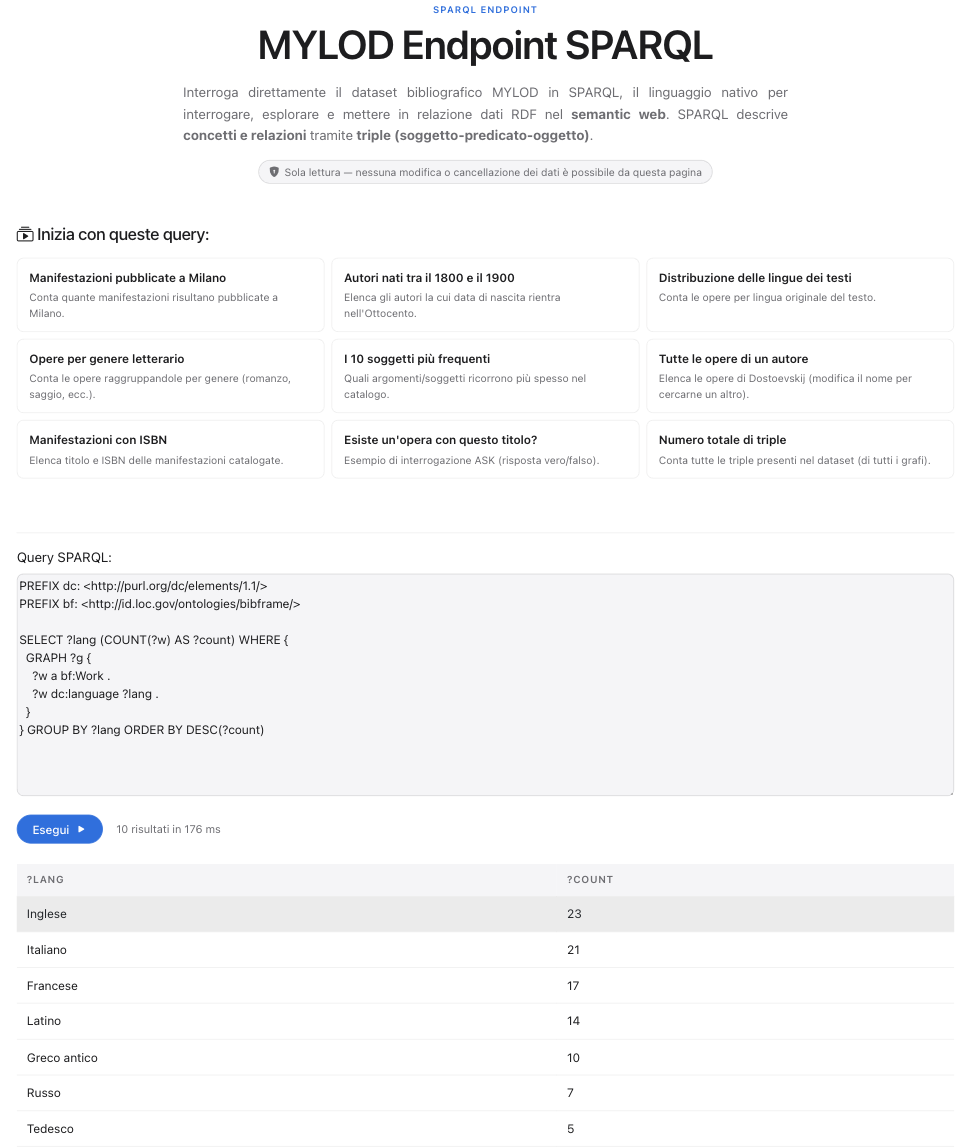
公開 SPARQL エンドポイント。すぐに使えるサンプルクエリ付き
MARC21、ネイティブ RDF、そしてあなたの個人スペース
データ生成の面では、MYLODLibrary は一つの方法を押しつけるのではなく、二つの道を並行して用意しています。第一の道は伝統的な図書館用フォーマットから出発します。確立された実務に従って MARC21 レコードを作成すると、自動処理がそこからフィールドごとに対応する LRM 実体を導き出し、著作−表現形−体現形−個別資料の連鎖と、それに伴う典拠リンクを生成します。第二の道は、モデルの各実体に対応した一連の入力画面を通じて、RDA および IFLA LRM の各モデルによる直接的なネイティブ目録作成を可能にします。
二つの道は互いに択一的なものではなく、異なる必要への答えです。第一の道はすでに MARC21 で作業している人々の教育投資と業務の流れを守り、第二の道は別の技術的時代に構想されたフォーマットの制約を受けずに LRM モデルの表現力を活かすことを可能にします。いずれも同一の目録、同一の RDF グラフへと合流します。つまり、各実体は、選ばれたフォーマットにかかわらず目録作成上の要求に応えます。ネイティブ RDF を生成する場合でも、MARC21 から出発する場合でも、いずれにせよ WEMI システムへのカスケード的な公開に到達します。
さらに登録利用者にはそれぞれ 個人用の目録作成スペース が用意されています。ゼロから、あるいは記入済みのサンプルレコードから、自分の記述を練習し組み立てるための実験室です。この領域で扱われるデータは厳密に非公開のまま保たれます。公開目録には現れず、他の利用者からも見えず、問い合わせ可能なグラフにも入りません。これは、誤り — および場合によってはプラットフォームの保守に関する報告 — が成長と学習の過程の一部である教育的な場面でもこの道具を用いることができるための、不可欠な条件です。
ただし、個人スペースは目録全体から隔離された区画ではない。目録作成者は、すでに公開されている典拠エンティティ——行為主体、場所、主題、職業——を、経験豊富な目録作成者と同様に自由に再利用でき、不要な重複を避けられる。一方、表現形・体現形・個別資料は常に自分自身の独立したエンティティであり続け、一般目録にすでに存在する著作を記述する場合でも、既存のレコードと統合されたり重ね合わされたりすることはない。これは意図的な区別である:典拠は共有財産であり、詳細な書誌記述は個人のものにとどまる。
記述モデルは印刷図書だけに限られない。写本と古版本には専用のセクション——支持体、折丁構成、書体、装丁、活字の跡、印刷者標——が用意されており、写本については、すでに目録化されたメタデータから自動生成できる、あるいは他所で作成されたファイルを取り込み公式TEIスキーマで検証できる TEI/XML 翻字モジュールも備えている。さらに、各体現形には独自のデジタルコピーを持たせることができる——プラットフォームに直接アップロードされたPDFで、外部ソフトウェアを必要とせず公開ページから閲覧できる。
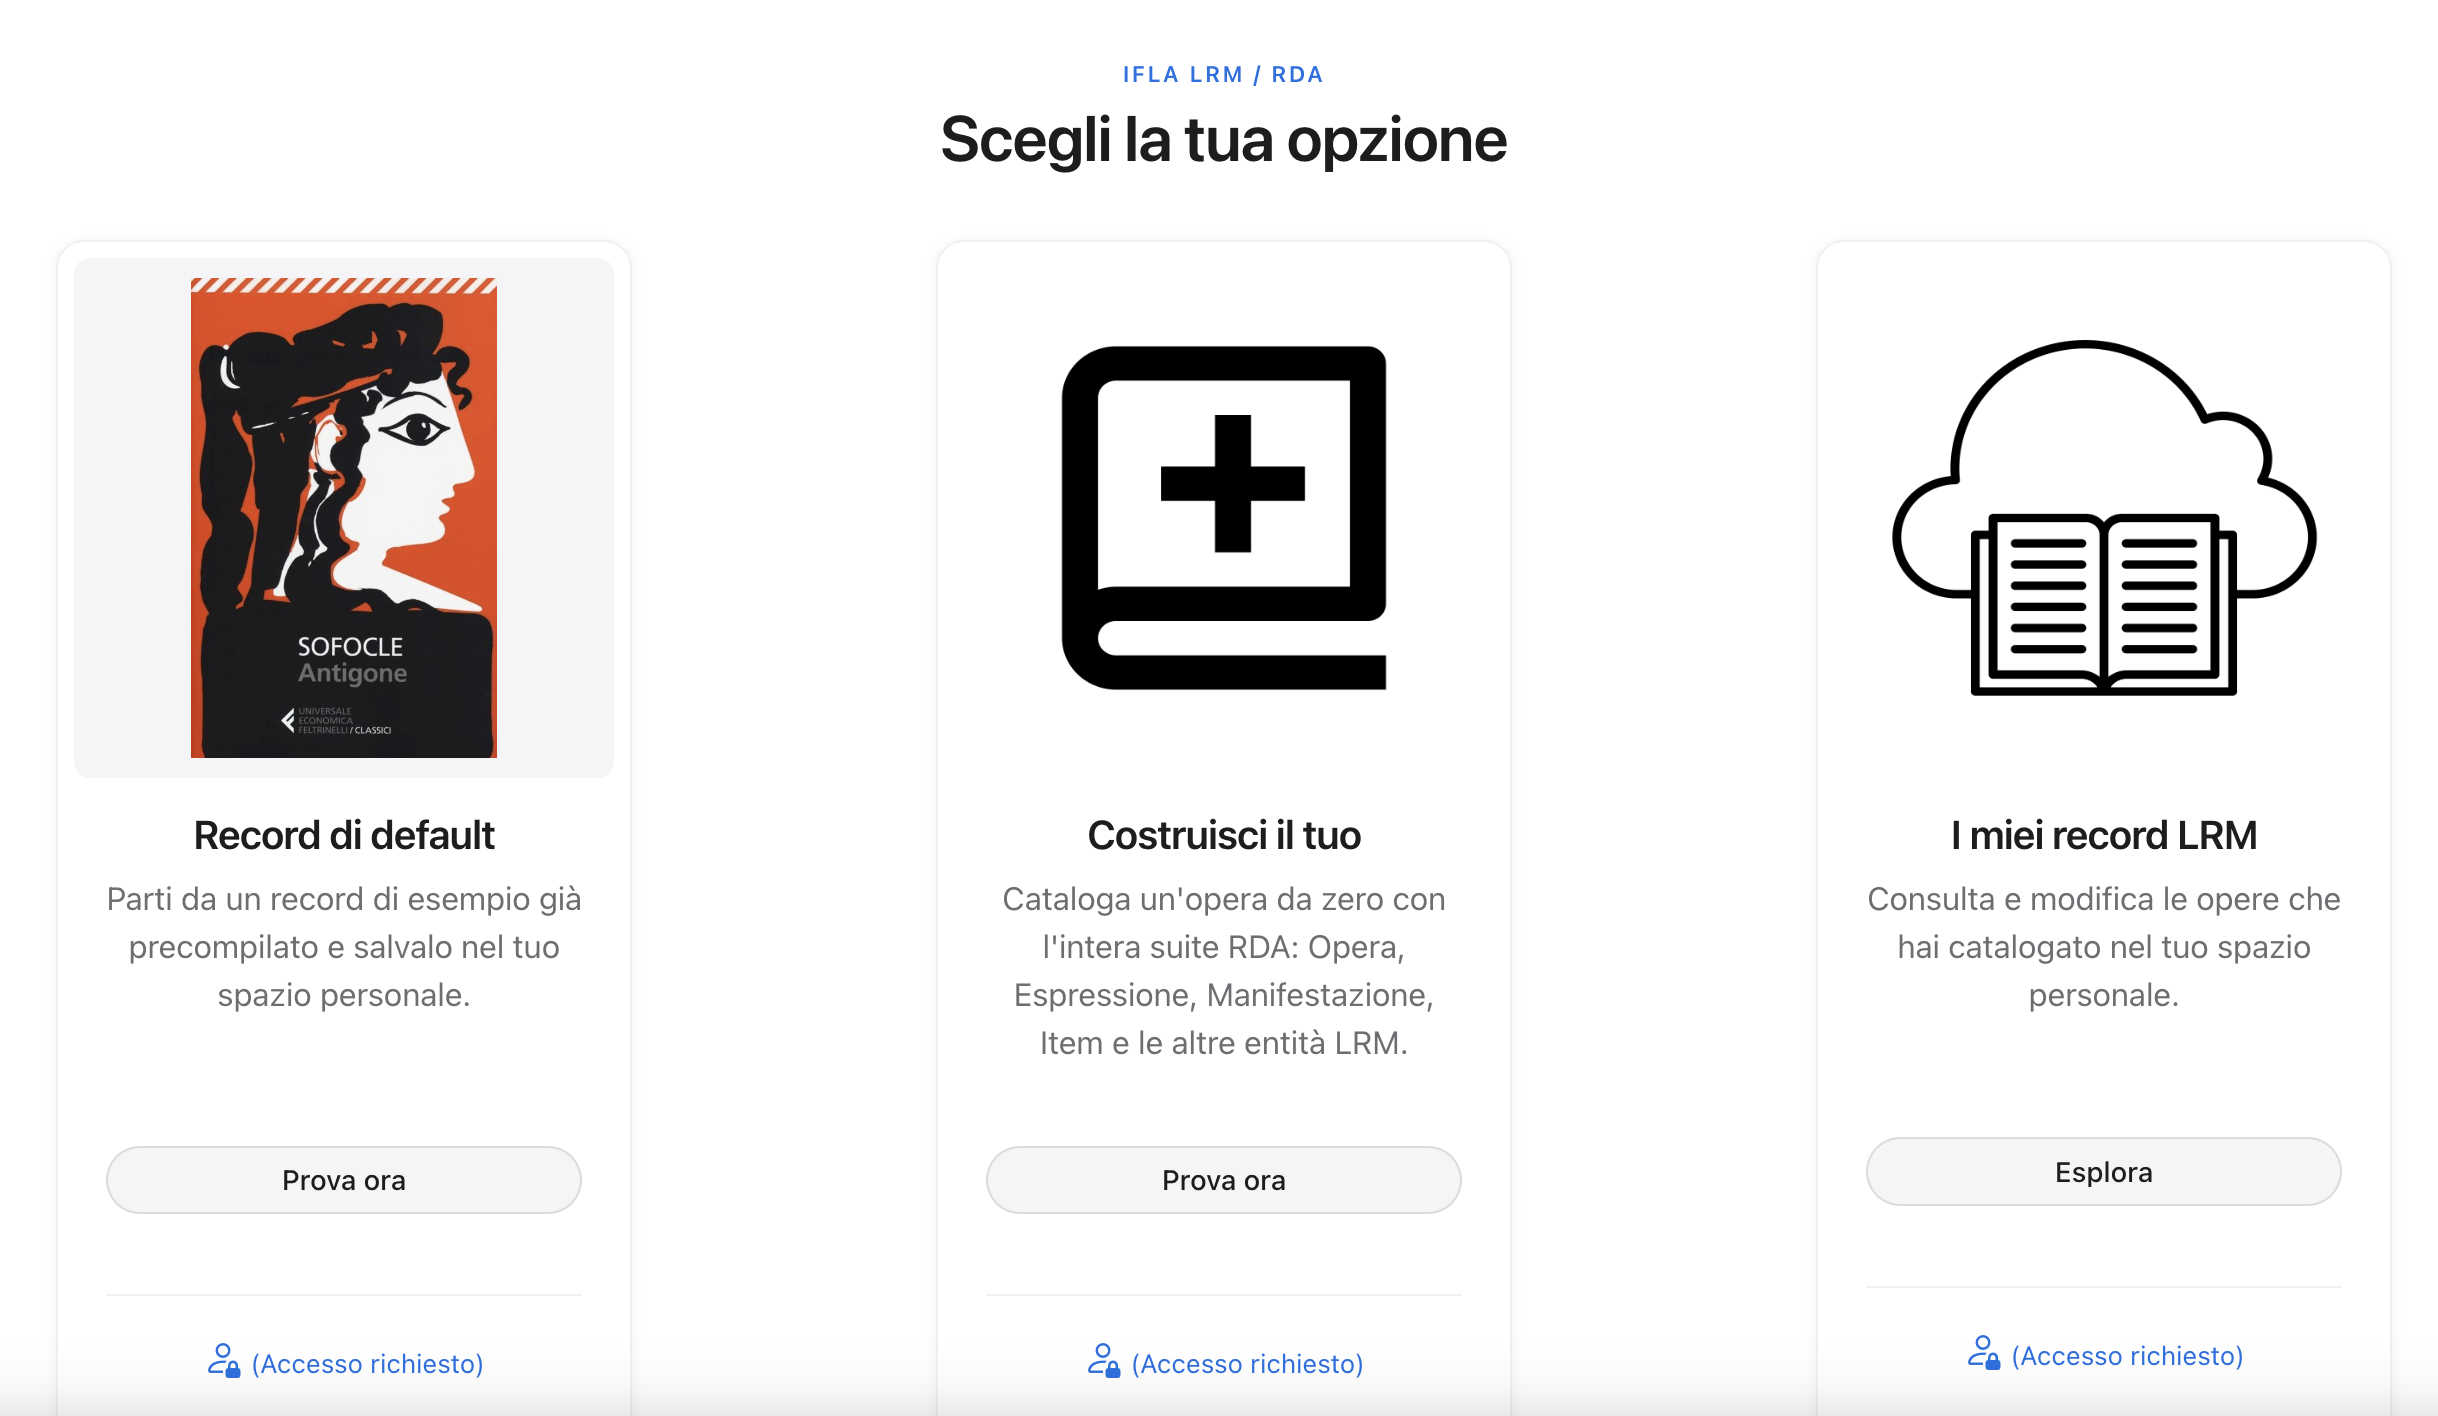
ネイティブ IFLA LRM/RDA 目録作成のハブ。目録作成者の個人スペース付き
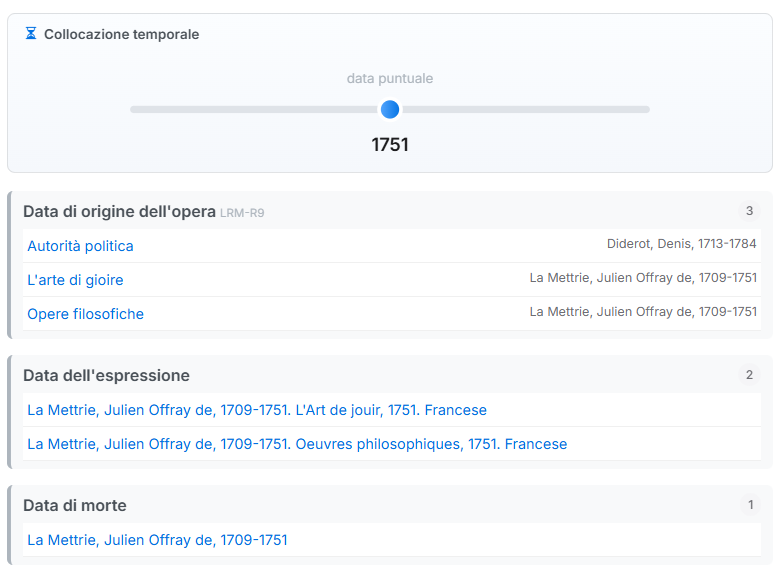
時間範囲エンティティを通じてリソース間の関係をたどる