MYLODLibrary es un catálogo bibliográfico que describe recursos no como registros aislados y autosuficientes, sino como una red de entidades relacionadas entre sí según la lógica de los Linked Open Data, el modelo conceptual IFLA LRM y la norma de catalogación RDA.
El presupuesto es que un catálogo no debe limitarse a constatar la existencia de un documento, sino que debe explicitar las relaciones que lo atraviesan: el vínculo entre una obra y sus traducciones, entre una edición y el ejemplar conservado, entre un autor y el conjunto de sus escritos, entre un texto y los temas que aborda, y muchas más. Una descripción bibliográfica tradicional enuncia estas relaciones de forma discursiva y cerrada, comprensible para el lector humano pero opaca para cualquier procesamiento automático; aquí, en cambio, están codificadas en una estructura formal y, por tanto, son consultables, verificables y reutilizables por sistemas de terceros.
El proyecto integra dos vías de catalogación — el formato bibliotecario tradicional, el MARC21, y la descripción nativa en IFLA LRM — que convergen en el mismo catálogo público y alimentan un único grafo de datos RDF, libremente consultable, también a través de un endpoint SPARQL. Las secciones que siguen recorren sus componentes principales, desde la interfaz de consulta hasta las herramientas de producción y publicación de los datos.
Nota para los lectores: los recursos incluidos en el catálogo MYLODLibrary pertenecen a una colección de libros privada y personal, en constante actualización, publicada con el fin de ponerse a disposición para el estudio y la evolución del proyecto. Por este motivo es importante señalar que, a nivel de descripción del Item, los datos tienen como único objetivo validar las investigaciones y la producción MYLOD y ofrecer herramientas de estudio para la introducción de datos y la construcción de los Linked Open Data.
Buscar y explorar
El catálogo general es la puerta de acceso al fondo descrito en MYLODLibrary y constituye el punto de observación privilegiado para quien lo consulta. La consulta puede realizarse de forma sencilla — por título, autor o materia, con soporte de comodines para las búsquedas parciales — o de forma avanzada, combinando varios criterios mediante operadores booleanos (AND, OR, NOT) que permiten acotar progresivamente el conjunto de resultados hasta aislar exactamente lo que interesa.
La interfaz de consulta ofrece una restitución analítica del contexto: junto a la lista de resultados, un panel de estadísticas calculadas dinámicamente describe la porción del catálogo que se está consultando, articulándola por lengua del texto, lugar y fecha de publicación, agentes, etc. La posibilidad de filtrar los resultados por modalidad de registro ofrece a los usuarios una panorámica de lo que se ha publicado en formato RDF nativo o, en su caso, a partir del MARC21. La búsqueda deja así de ser una mera recuperación de registros y se convierte en un instrumento de análisis: quien consulta no obtiene solo una lista, sino un resumen cuantitativo del subconjunto que ha aislado.
Cada resultado declara además su propia procedencia indicando el número total de tripletas generadas, haciendo inmediatamente perceptible la densidad informativa que hay detrás de la descripción. Desde aquí se accede al registro completo de la obra y a todos los formatos en que está disponible.
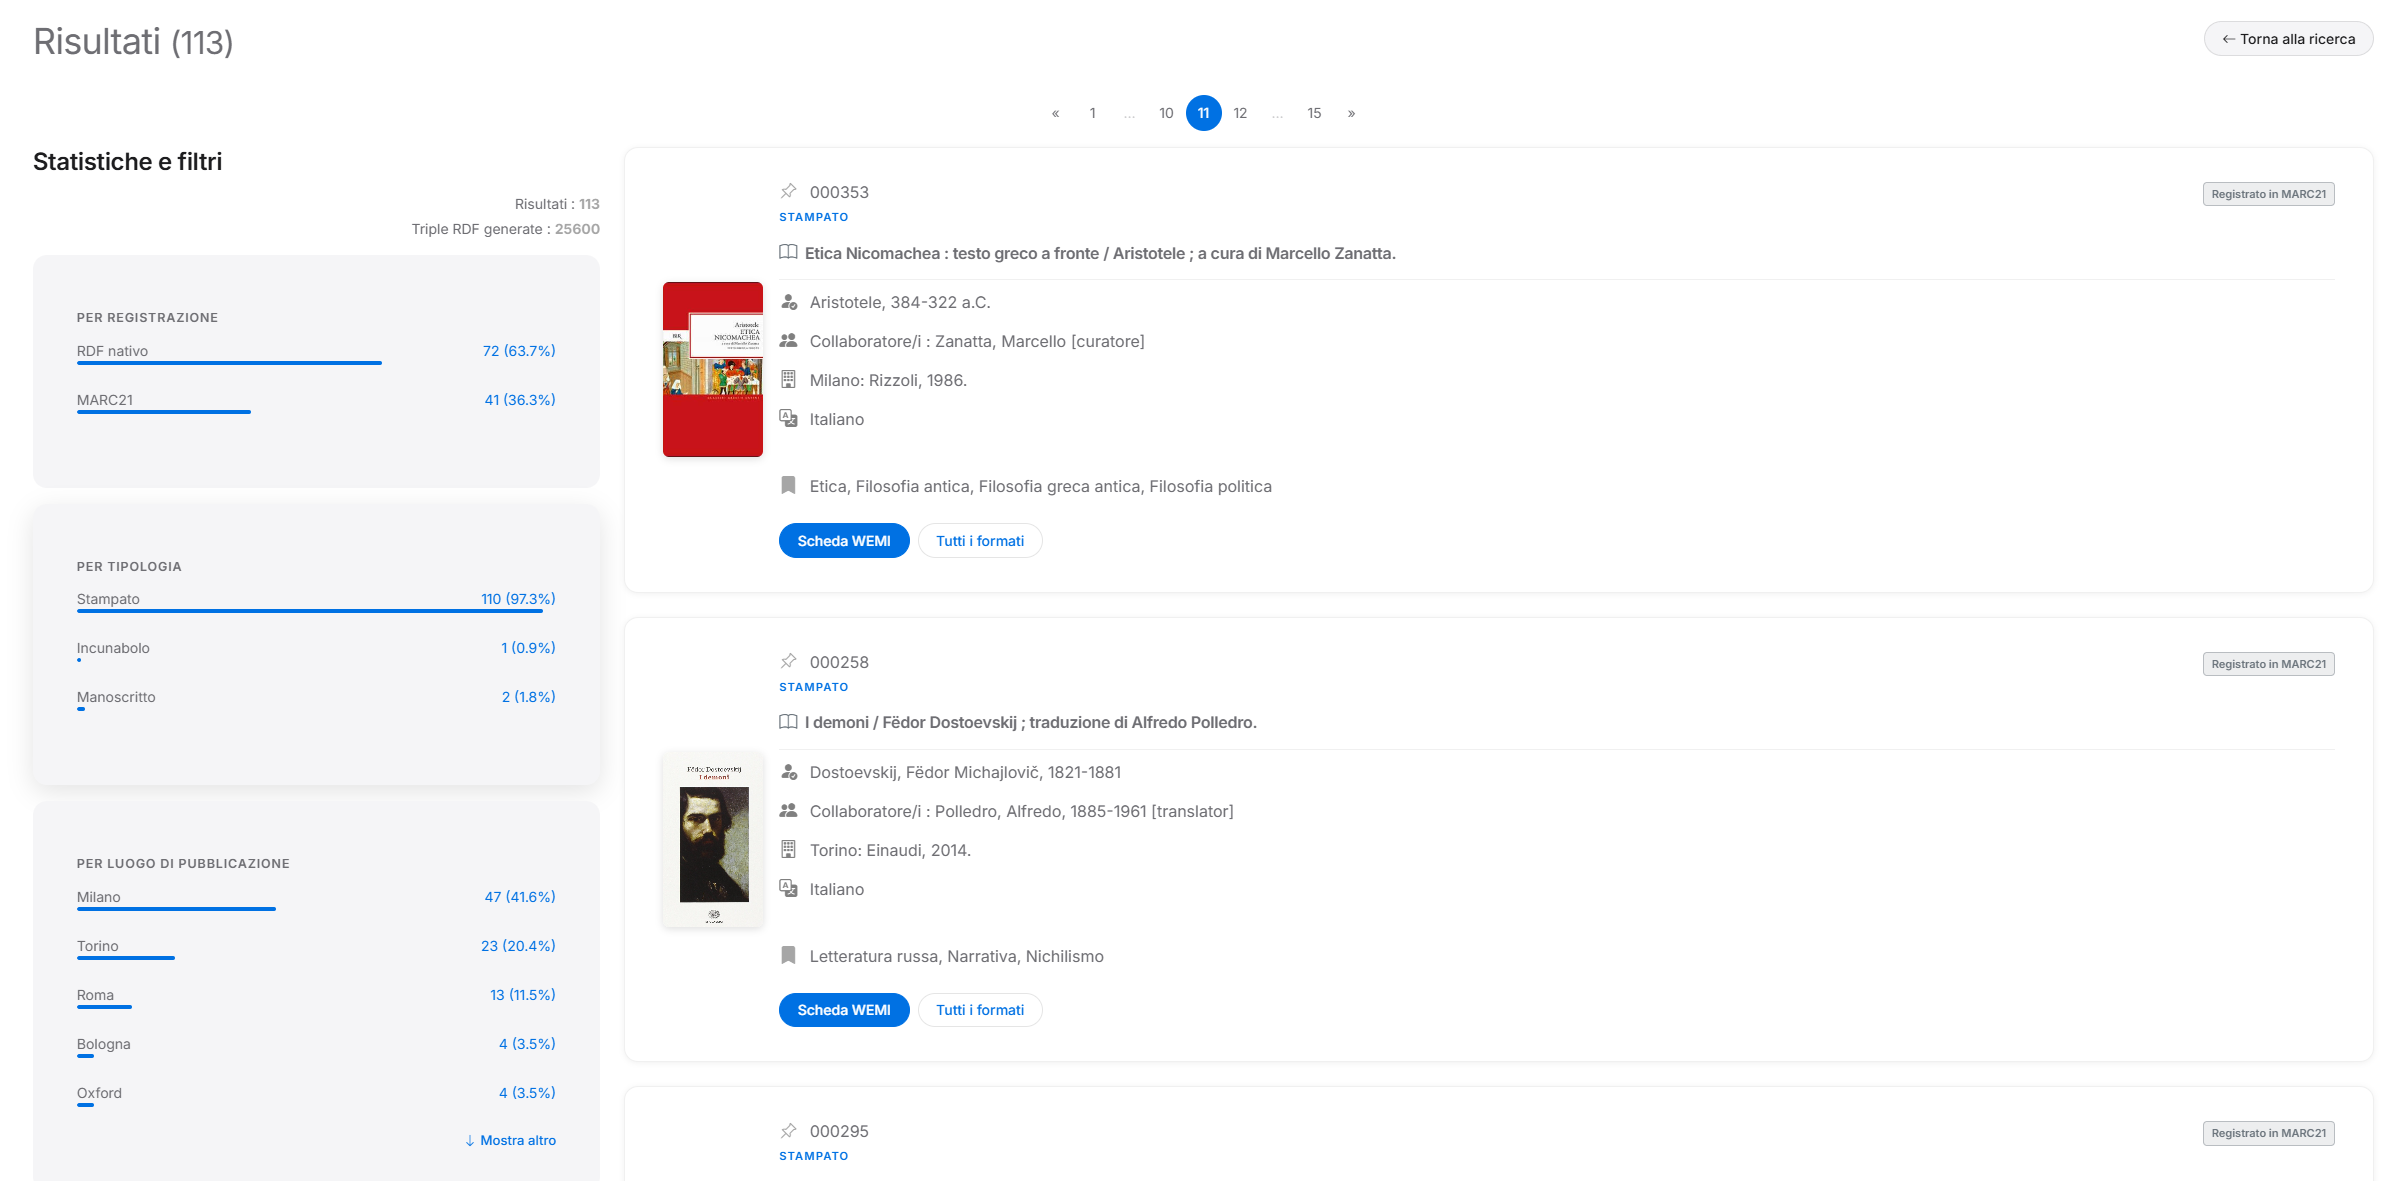
Búsqueda en el catálogo general, con filtros y estadísticas en tiempo real
Obra, Expresión, Manifestación, Ítem
En el centro del armazón conceptual del proyecto se sitúa el modelo IFLA Library Reference Model, el marco de referencia con el que la comunidad bibliotecaria internacional ha repensado la descripción de los recursos. El principio es que lo que comúnmente llamamos «un libro» no es en realidad un objeto único, sino la superposición de cuatro entidades distintas y jerárquicamente vinculadas.
La Obra es el contenido intelectual en su abstracción — la Divina Comedia como creación del ingenio, con independencia de cómo se lea. La Expresión es una realización concreta de ella: una determinada traducción, una revisión crítica, una versión en una lengua dada. La Manifestación corresponde a la edición materialmente producida y publicada, con su editorial, su año, su ISBN. El Ítem, por último, es el ejemplar concreto físicamente conservado y colocado en un estante.
Describir por separado estos cuatro niveles, en lugar de comprimirlos en un registro único, permite al catálogo responder a preguntas que una descripción plana no es capaz de formular: cuántas traducciones existen de una obra dada, en qué ediciones se publicaron, qué ejemplares se conservan. Cada entidad se pone además en relación con los agentes que la produjeron, con las materias que trata, con los lugares y los periodos a los que se refiere.
Toda la trama de estas relaciones puede inspeccionarse como grafo interactivo, generado automáticamente desde el registro de cada obra: una herramienta que hace visible — y didácticamente legible — la arquitectura semántica que sostiene la descripción bibliográfica. Este esquema facilita además el sistema informático que produce los datos, ya que permite a la máquina generar, gestionar y conservar automáticamente todas las relaciones que el catalogador es capaz de describir, dando así a quienes consultan el catálogo la libertad de moverse por los distintos escenarios que los recursos abarcan o a los que pueden conducir, tanto dentro del catálogo como fuera de él.
La misma lógica relacional se extiende también a los agentes entre sí: una persona puede declararse miembro de un ente colectivo, un ente colectivo puede preceder o suceder a otro —por fusiones, escisiones, cambios de denominación— y dos agentes pueden, de forma más genérica, aparecer asociados. Estos vínculos también, modelados según los tipos de relación definidos por IFLA LRM, se publican como tripletas RDF y se muestran en la ficha pública de cada agente.
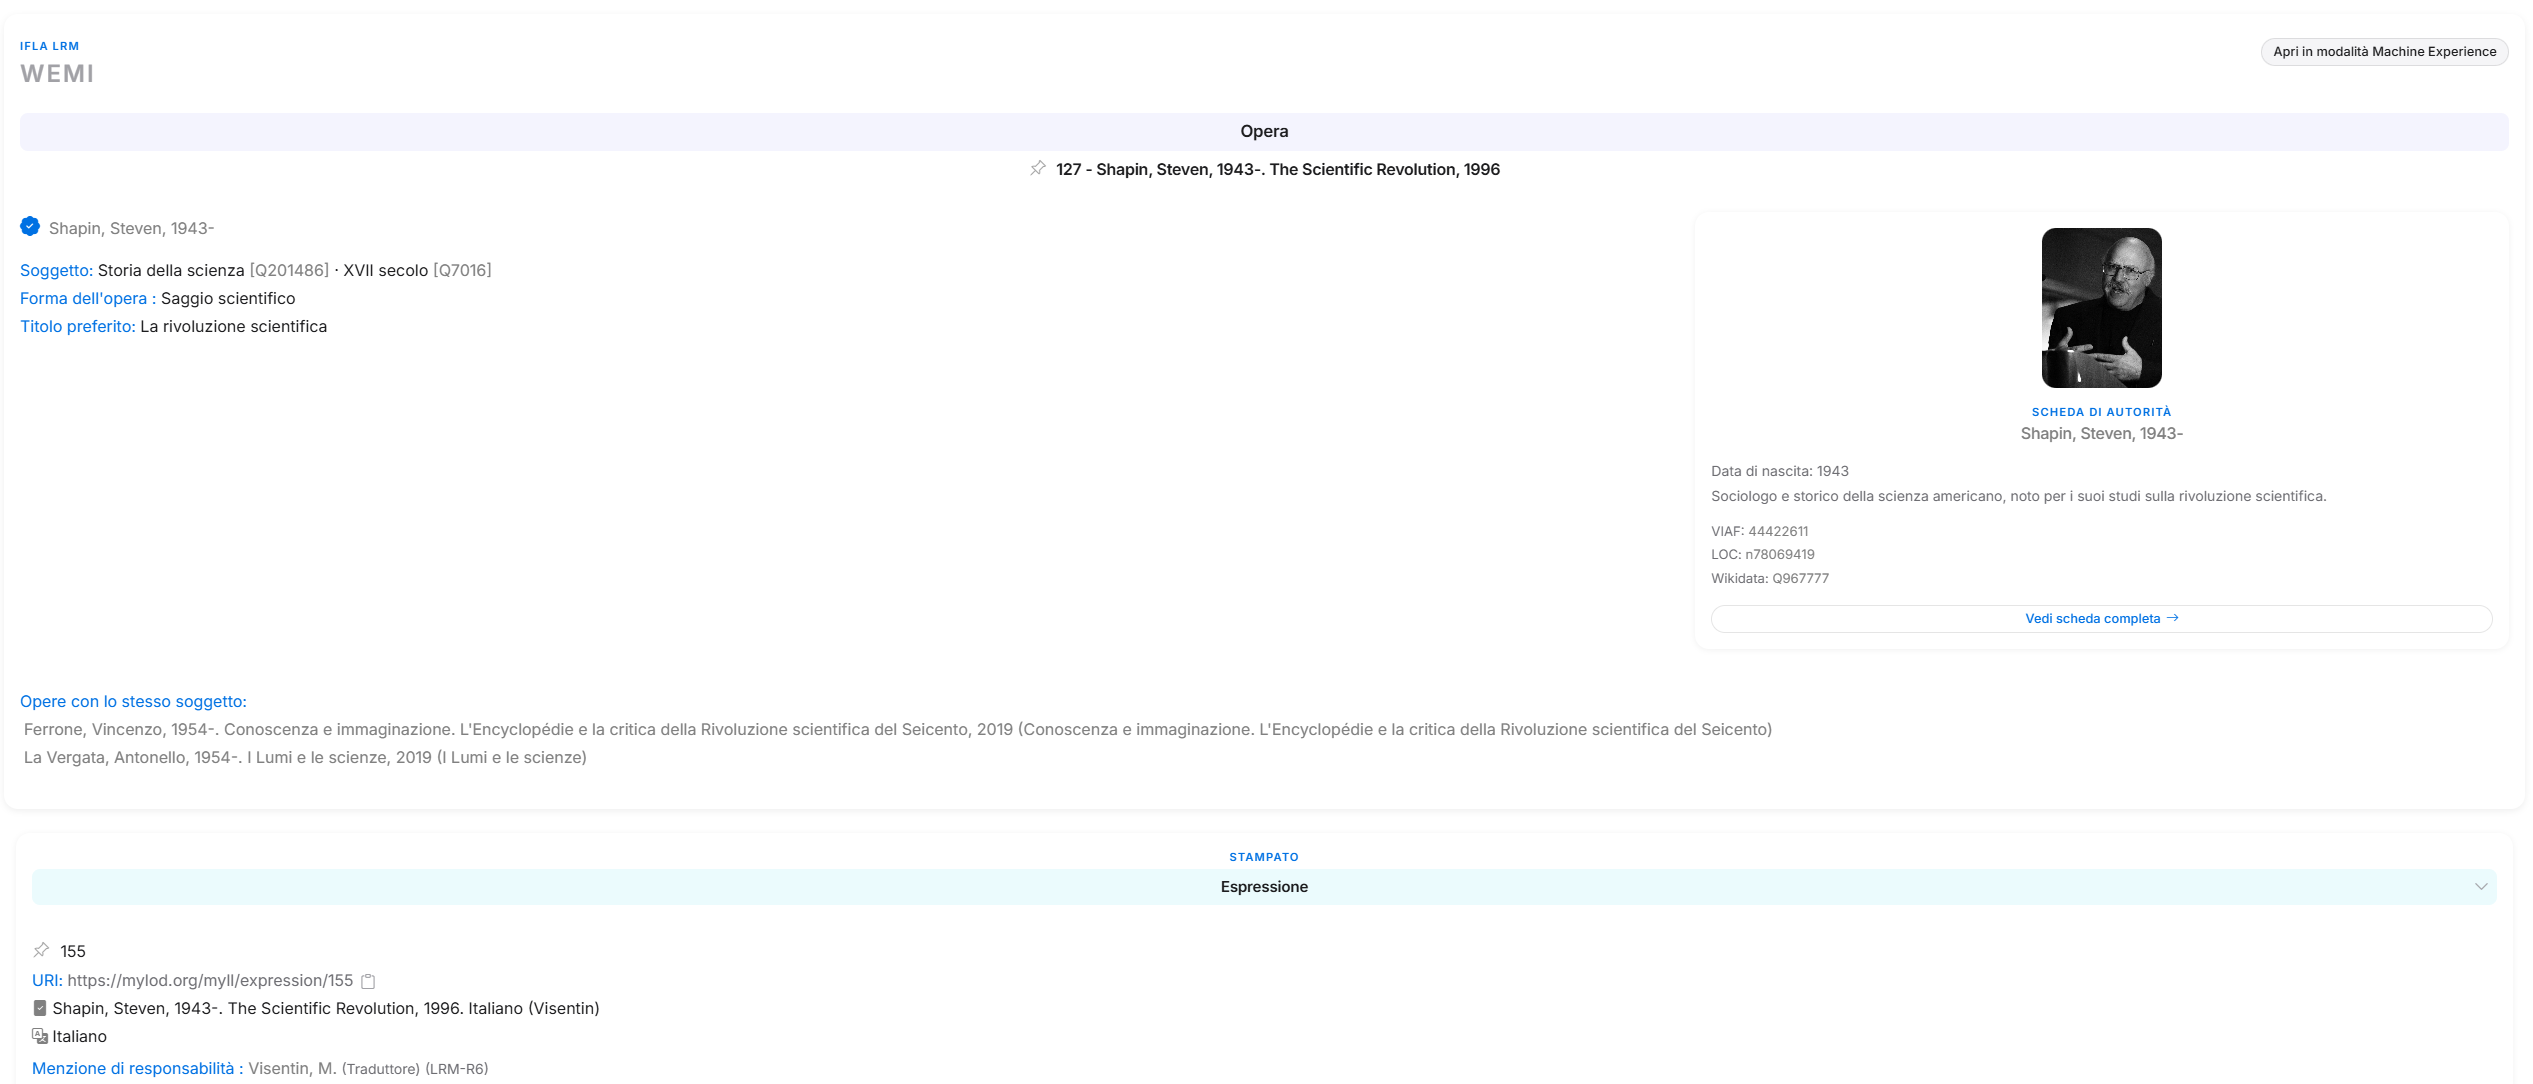
La cascada Obra → Expresión → Manifestación, con el registro de autoridad del agente al lado
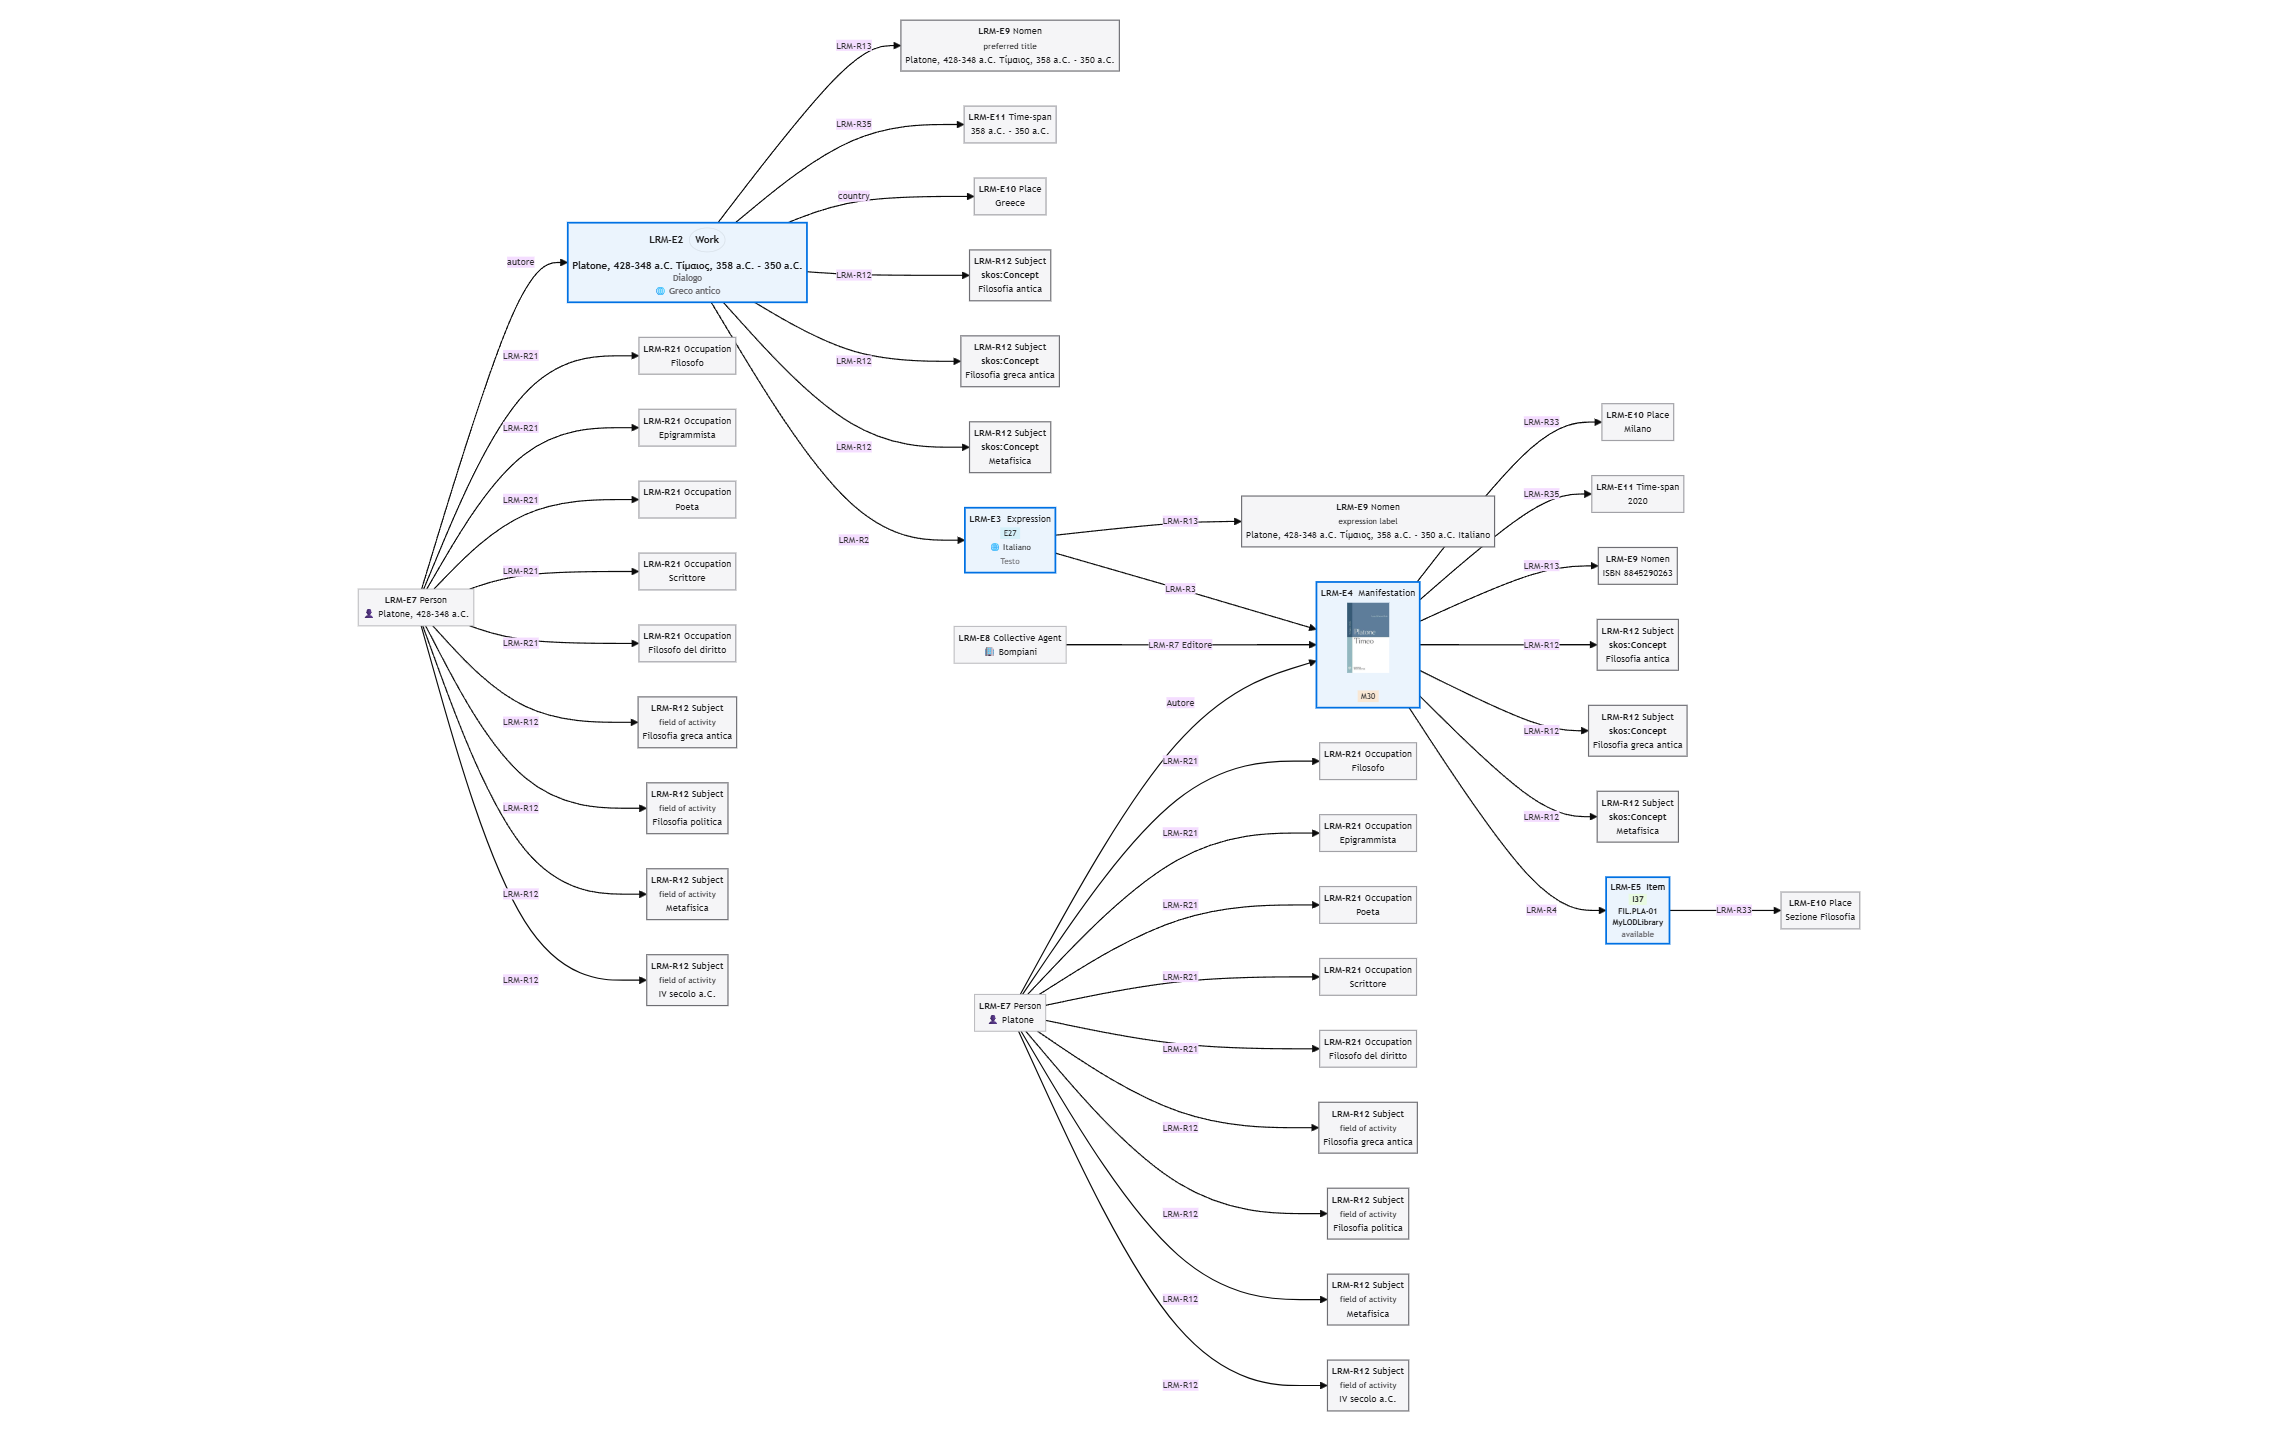
El grafo de las relaciones LRM, generado automáticamente para cada obra
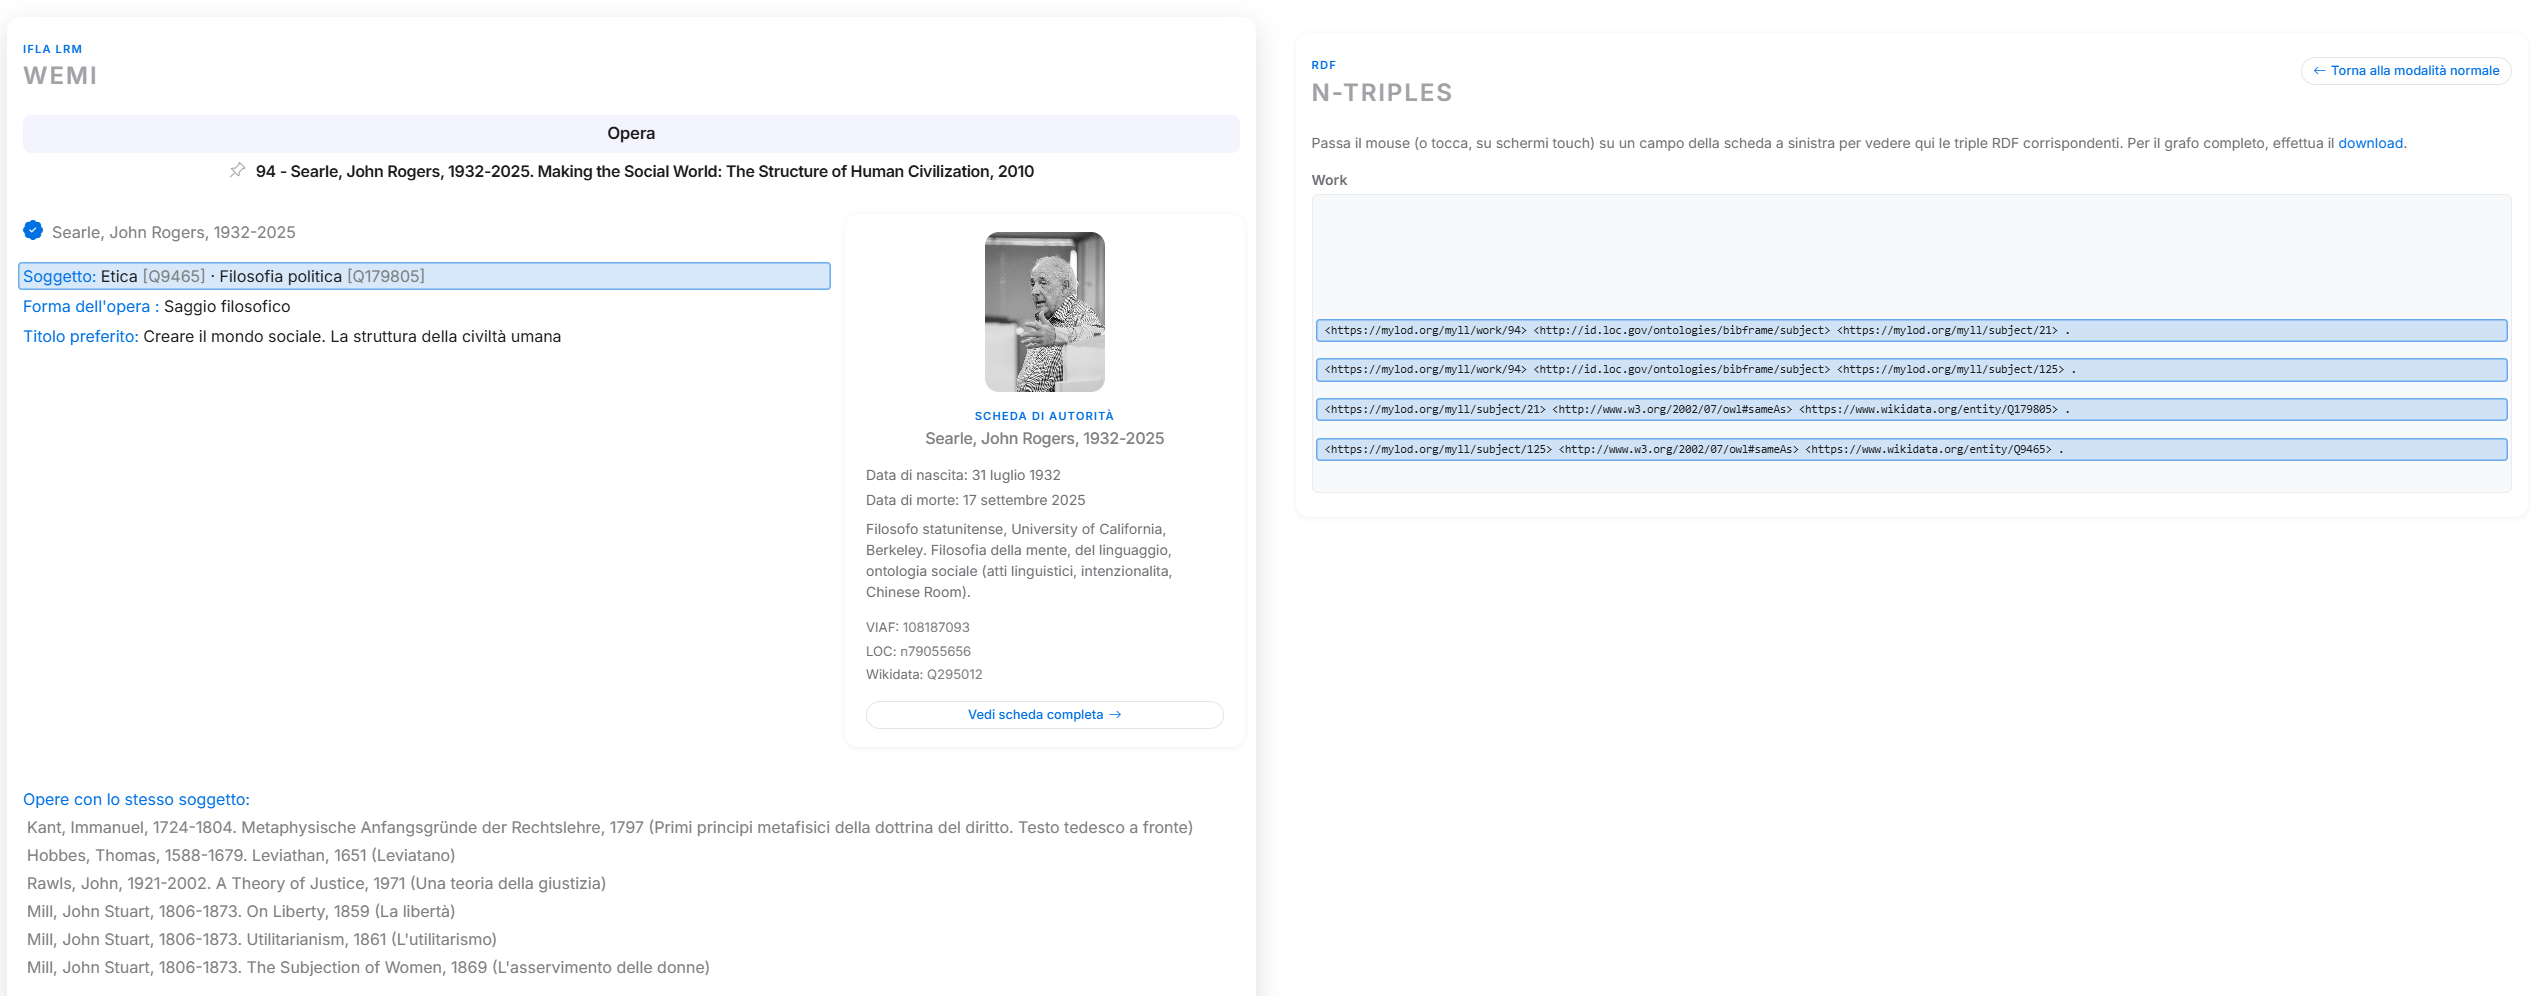
Haz que el lenguaje natural y el de la máquina convivan, explorando tus triples RDF
Agentes, lugares y materias como entidades
Autores, entidades corporativas, lugares, materias, ocupaciones y títulos uniformes no figuran en el catálogo como cadenas de texto replicadas en cada registro, sino como entidades de autoridad autónomas: descritas una sola vez, dotadas de un identificador persistente propio y llamadas por referencia dondequiera que aparezcan. Es el principio del control de autoridades, aplicado aquí de manera sistemática a todas las clases de entidad previstas por el modelo.
De ello se derivan consecuencias concretas. Una corrección aplicada a la forma del nombre de un autor se propaga instantáneamente a cada obra que la referencia, sin necesidad de intervenciones repetidas; las variantes onomásticas, los seudónimos y las formas en escrituras distintas convergen en la misma entidad, garantizando que una búsqueda realizada sobre cualquiera de ellas conduzca igualmente al mismo resultado.
Cada registro de autoridad reúne la forma preferida del nombre, las formas variantes registradas, una nota biográfica o descriptiva y — elemento decisivo para la interoperabilidad — los enlaces a los identificadores de las principales agencias internacionales: VIAF, Library of Congress, ISNI, Bibliothèque nationale de France, SBN y Wikidata, por citar algunos. A través de estas alineaciones la entidad deja de ser un dato local y se inserta en la red global de las autoridades bibliográficas, donde los datos biográficos y geográficos pueden enriquecerse automáticamente desde las fuentes enlazadas.
Cada descripción es finalmente exportable en los principales formatos RDF — Turtle, JSON-LD, N-Triples, RDF/XML, N-Quads — o explorable directamente en un entorno de consulta de grafos.
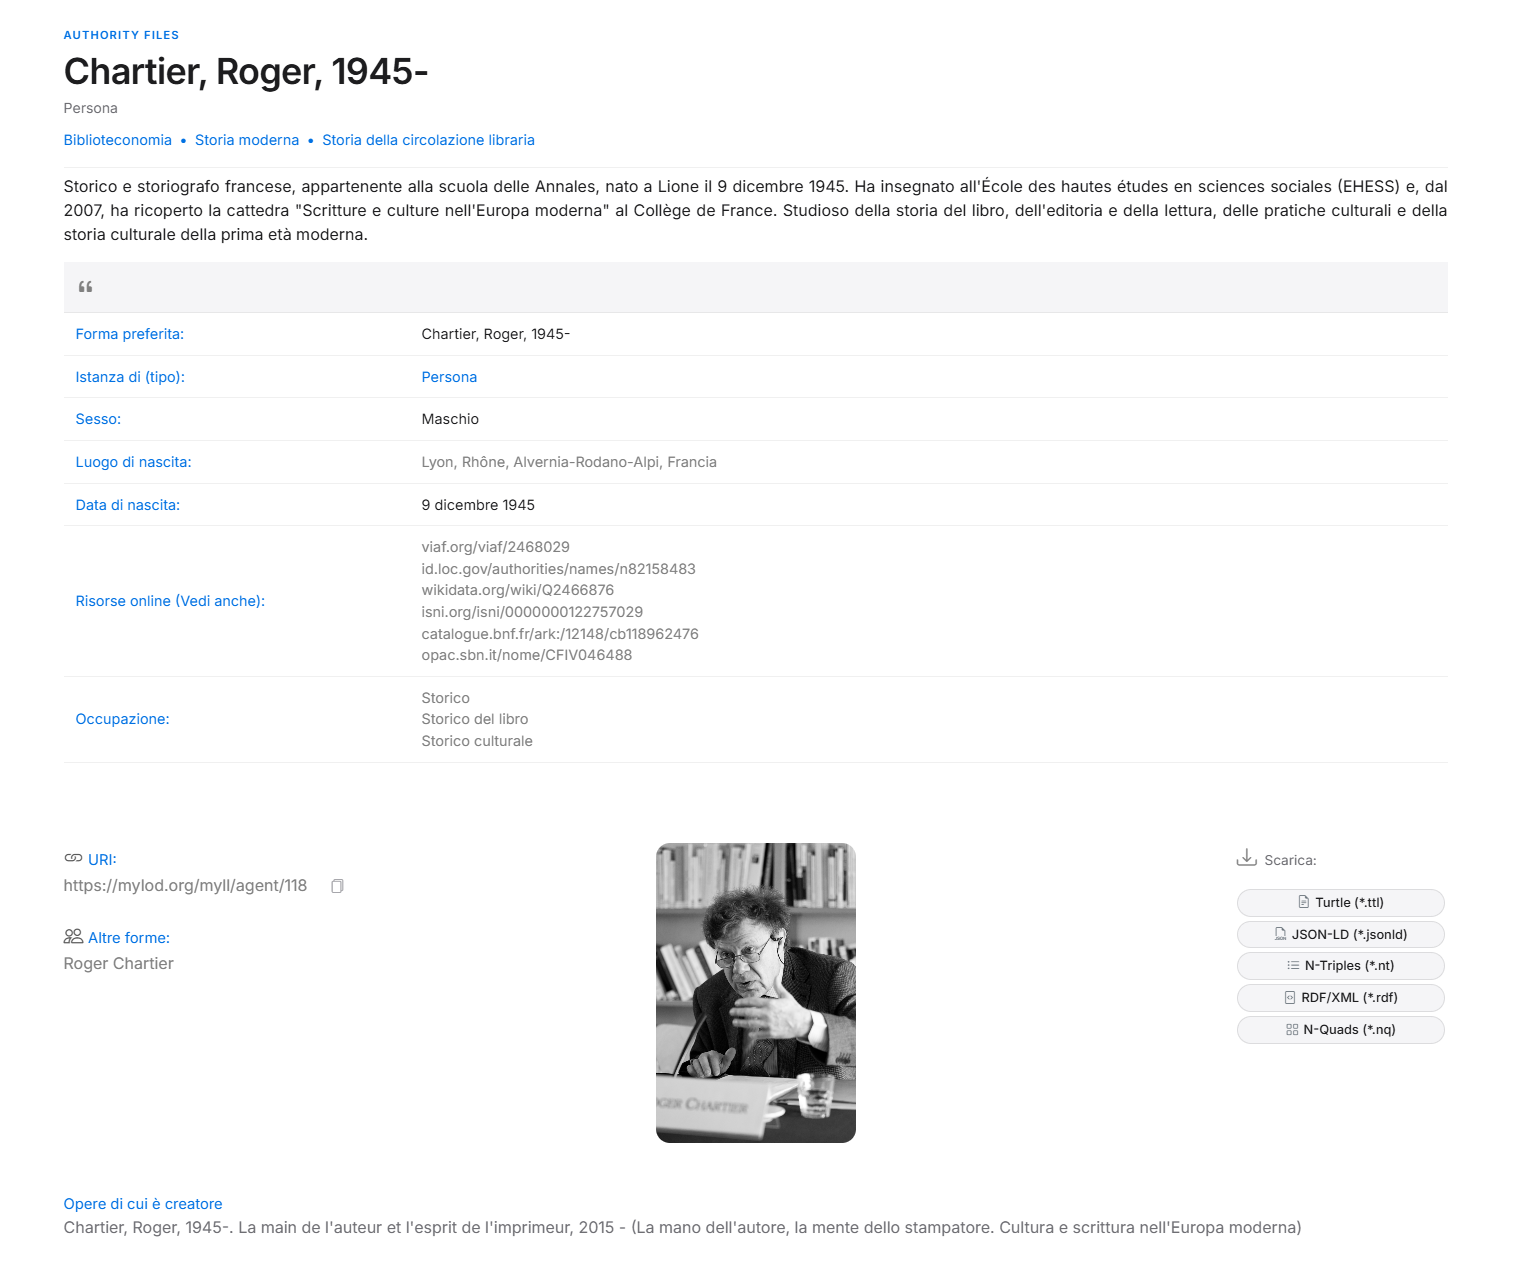
Registro de autoridad con exportación RDF, enriquecido automáticamente desde Wikidata
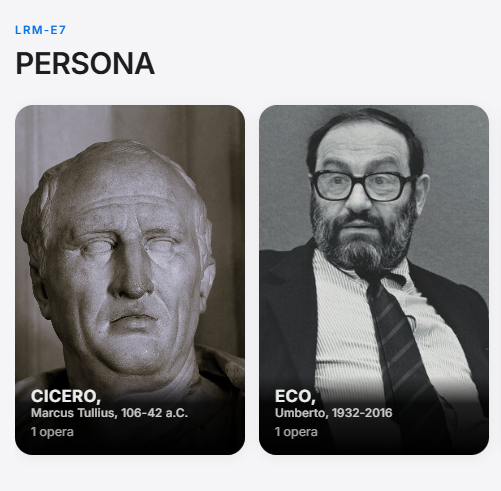
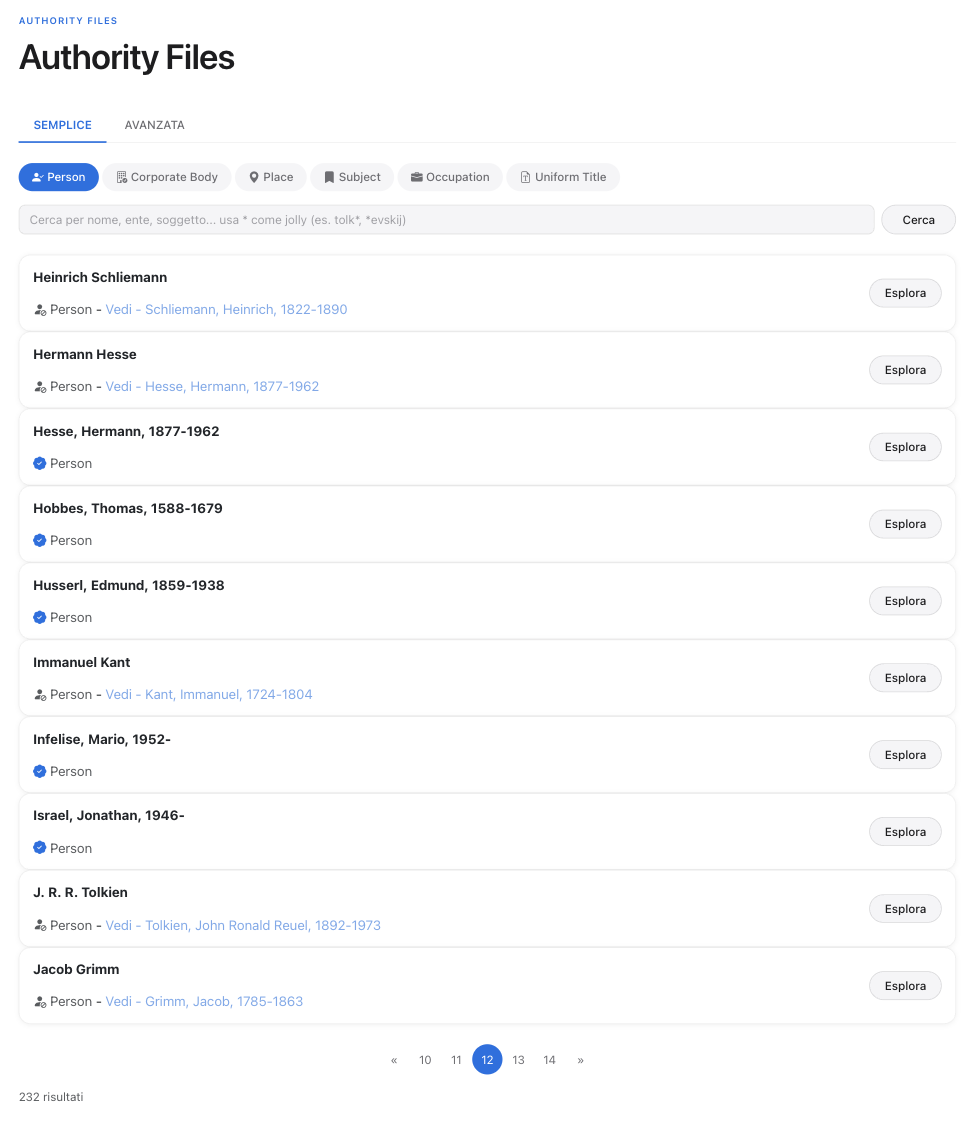
Las Personas como entidades autónomas, y la búsqueda dedicada por tipo de entidad
Un grafo de datos consultable
Cada entidad descrita en el catálogo — obras, expresiones, manifestaciones, ejemplares, agentes, lugares, materias y periodos — se publica simultáneamente como un conjunto de tripletas RDF, la unidad elemental de la web semántica, compuestas cada una por un sujeto, un predicado y un objeto. Las propiedades empleadas no se definen localmente, sino que se toman de los vocabularios estándar adoptados por la comunidad internacional: BIBFRAME, FOAF, y muchos otros.
Esta estructura es lo que permite a los datos salir de los confines de la aplicación. Un sistema externo que conozca esos vocabularios es capaz de interpretar las descripciones de MYLODLibrary sin acuerdo previo alguno, del mismo modo que el catálogo puede a su vez engancharse a recursos externos mediante los identificadores compartidos. El resultado no es un archivo cerrado, sino un nodo dentro de una red documental más amplia. La conversión de los datos del formato MARC21 a RDF (a través de varias etapas de producción así como de formato del dato disponible, como el MARCXML) está pensada para ofrecer al catalogador la posibilidad de aprender la semántica de los datos RDF sin abandonar el formato MARC21. Esto es posible gracias a la coexistencia paralela de dos bases de datos: la relacional, sobre la que opera MARC21, y la abierta, construida para alojar datos publicados para la web semántica.
Todo el grafo de tripletas es consultable públicamente en SPARQL, el lenguaje nativo para la exploración de datos RDF, a través de un endpoint de solo lectura. Para rebajar el umbral de entrada y facilitar la búsqueda, la interfaz propone una colección de consultas ya preparadas — la distribución de las lenguas, los autores activos en un siglo dado, las materias más recurrentes — que pueden ejecutarse de inmediato y modificarse después: un modo de aprender el lenguaje observando sus efectos, sin competencia previa alguna.
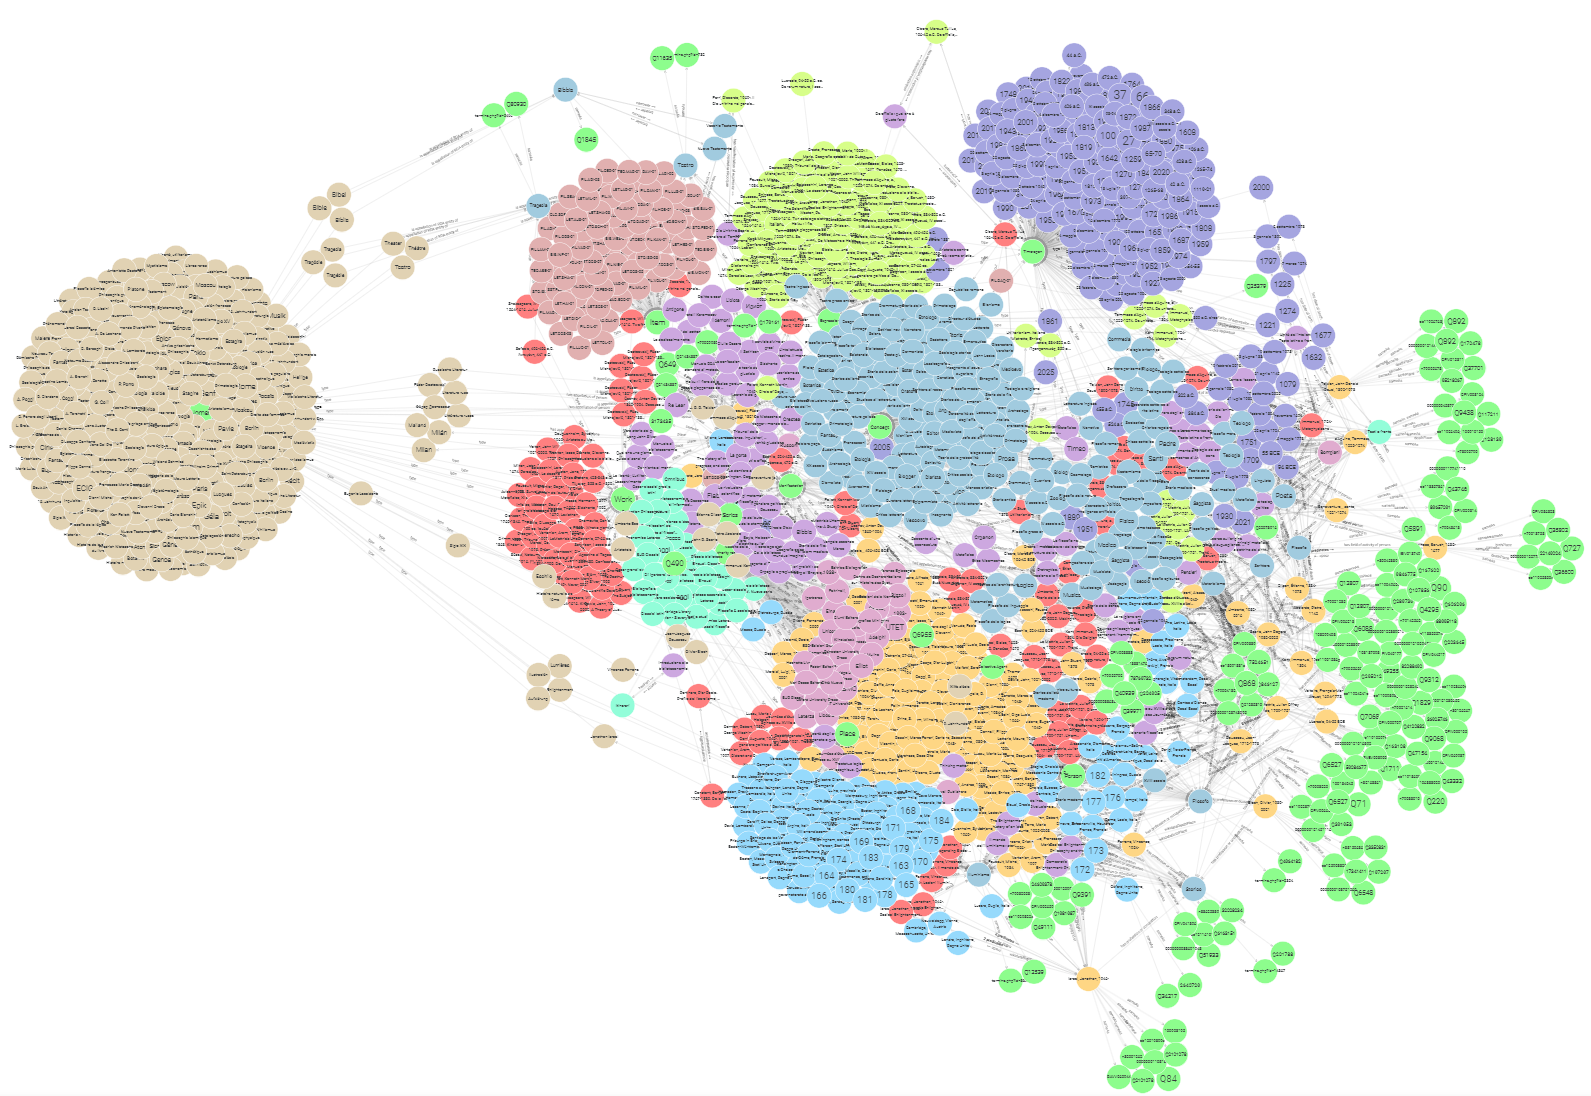
Una porción del grafo RDF del catálogo: cada nodo es una entidad, cada arista una relación
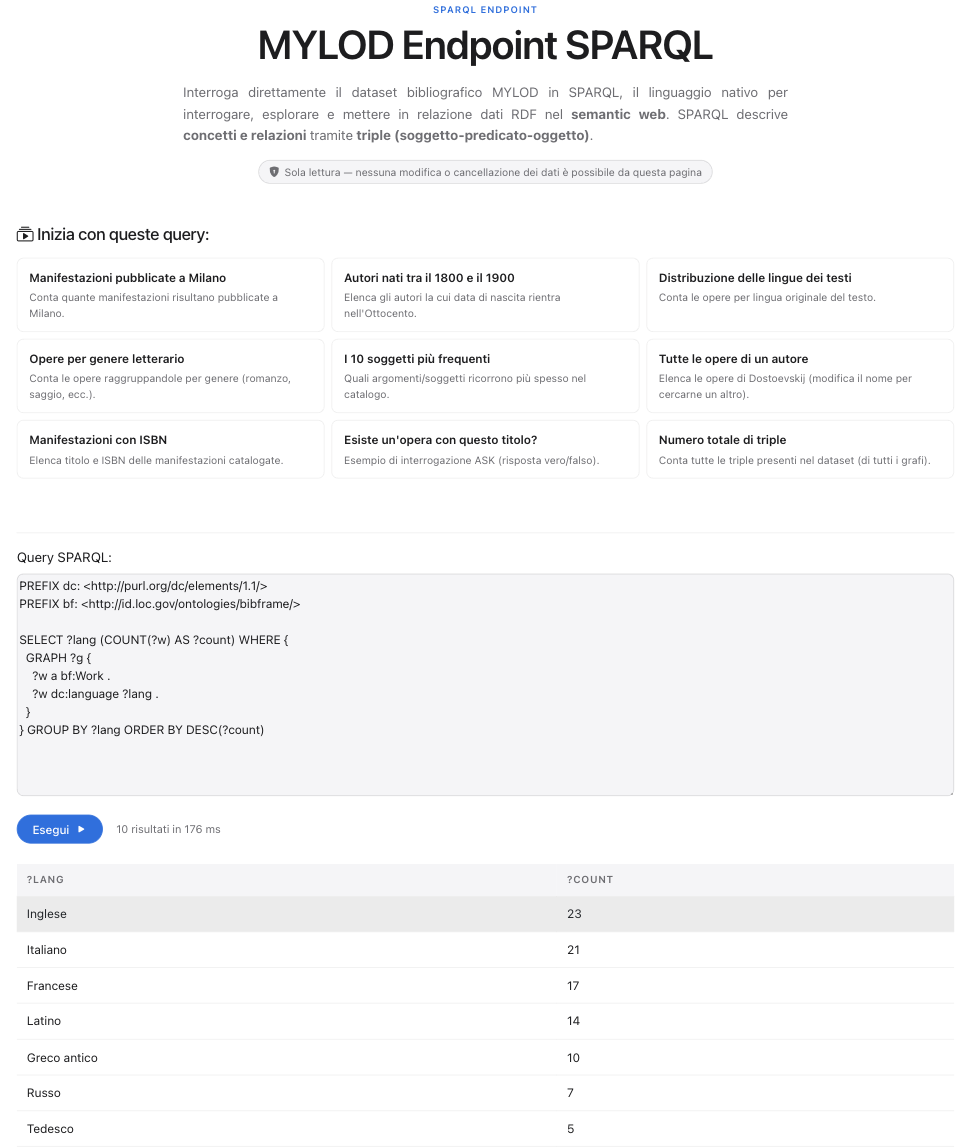
El endpoint SPARQL público, con consultas de ejemplo listas para usar
MARC21, RDF nativo y tu espacio personal
En el ámbito de la producción de los datos, MYLODLibrary recorre dos caminos paralelos en lugar de imponer uno solo. El primero parte del formato bibliotecario tradicional: se cumplimenta un registro MARC21 según la práctica consolidada y un procedimiento automático deriva de él, campo por campo, las entidades LRM correspondientes, generando la cadena Obra-Expresión-Manifestación-Ítem y los correspondientes enlaces de autoridad. El segundo permite la catalogación nativa directa según los modelos RDA e IFLA LRM, mediante un conjunto de formularios dedicados a cada entidad del modelo.
Las dos vías no son alternativas entre sí, sino respuestas a necesidades distintas: la primera salvaguarda la inversión formativa y los flujos de trabajo de quien ya opera en MARC21, la segunda permite aprovechar la expresividad del modelo LRM sin las constricciones de un formato concebido en otra época tecnológica. Ambas convergen en el mismo catálogo y en el mismo grafo RDF. Esto significa que cada entidad responde a las exigencias de catalogación con independencia del formato elegido. Ya se produzca RDF nativo o se parta del MARC21, se llega en cualquier caso a la publicación en cascada del sistema WEMI.
A cada usuario registrado se le reserva además un espacio de catalogación personal — un laboratorio en el que ejercitarse y construir las propias descripciones, partiendo de cero o de un registro de ejemplo ya cumplimentado. Los datos elaborados en esta área permanecen rigurosamente privados: no aparecen en el catálogo público, no son visibles para los demás usuarios y no entran en el grafo consultable. Es una condición esencial para que la herramienta pueda emplearse también en contextos didácticos, donde el error — y, en su caso, la notificación de tareas de mantenimiento de la plataforma — forma parte del recorrido de crecimiento y aprendizaje.
El espacio personal no es, sin embargo, un compartimento aislado del resto del catálogo: quien cataloga puede reutilizar libremente las entidades de autoridad ya públicas —un agente, un lugar, un tema, una ocupación— exactamente como lo haría un catalogador experimentado, evitando duplicaciones innecesarias. Las Expresiones, las Manifestaciones y los Ejemplares, en cambio, permanecen siempre como entidades propias y distintas: incluso cuando describen una obra ya presente en el catálogo general, nunca se fusionan ni se superponen a los registros existentes. Es una distinción deliberada: las autoridades son patrimonio compartido, la descripción bibliográfica detallada sigue siendo personal.
El modelo descriptivo no se limita al libro impreso: los manuscritos y los libros antiguos disponen de secciones dedicadas —soporte, encuadernación en cuadernillos, escritura, encuadernación, impronta, marca tipográfica— y, para los manuscritos, de un módulo de transcripción en TEI/XML, generable automáticamente a partir de los metadatos ya catalogados o importado desde un archivo producido en otro lugar y validado según el esquema oficial TEI. Para completar el panorama, cada Manifestación puede alojar su propia copia digital —un PDF cargado directamente en la plataforma, consultable desde la ficha pública sin necesidad de software externo.
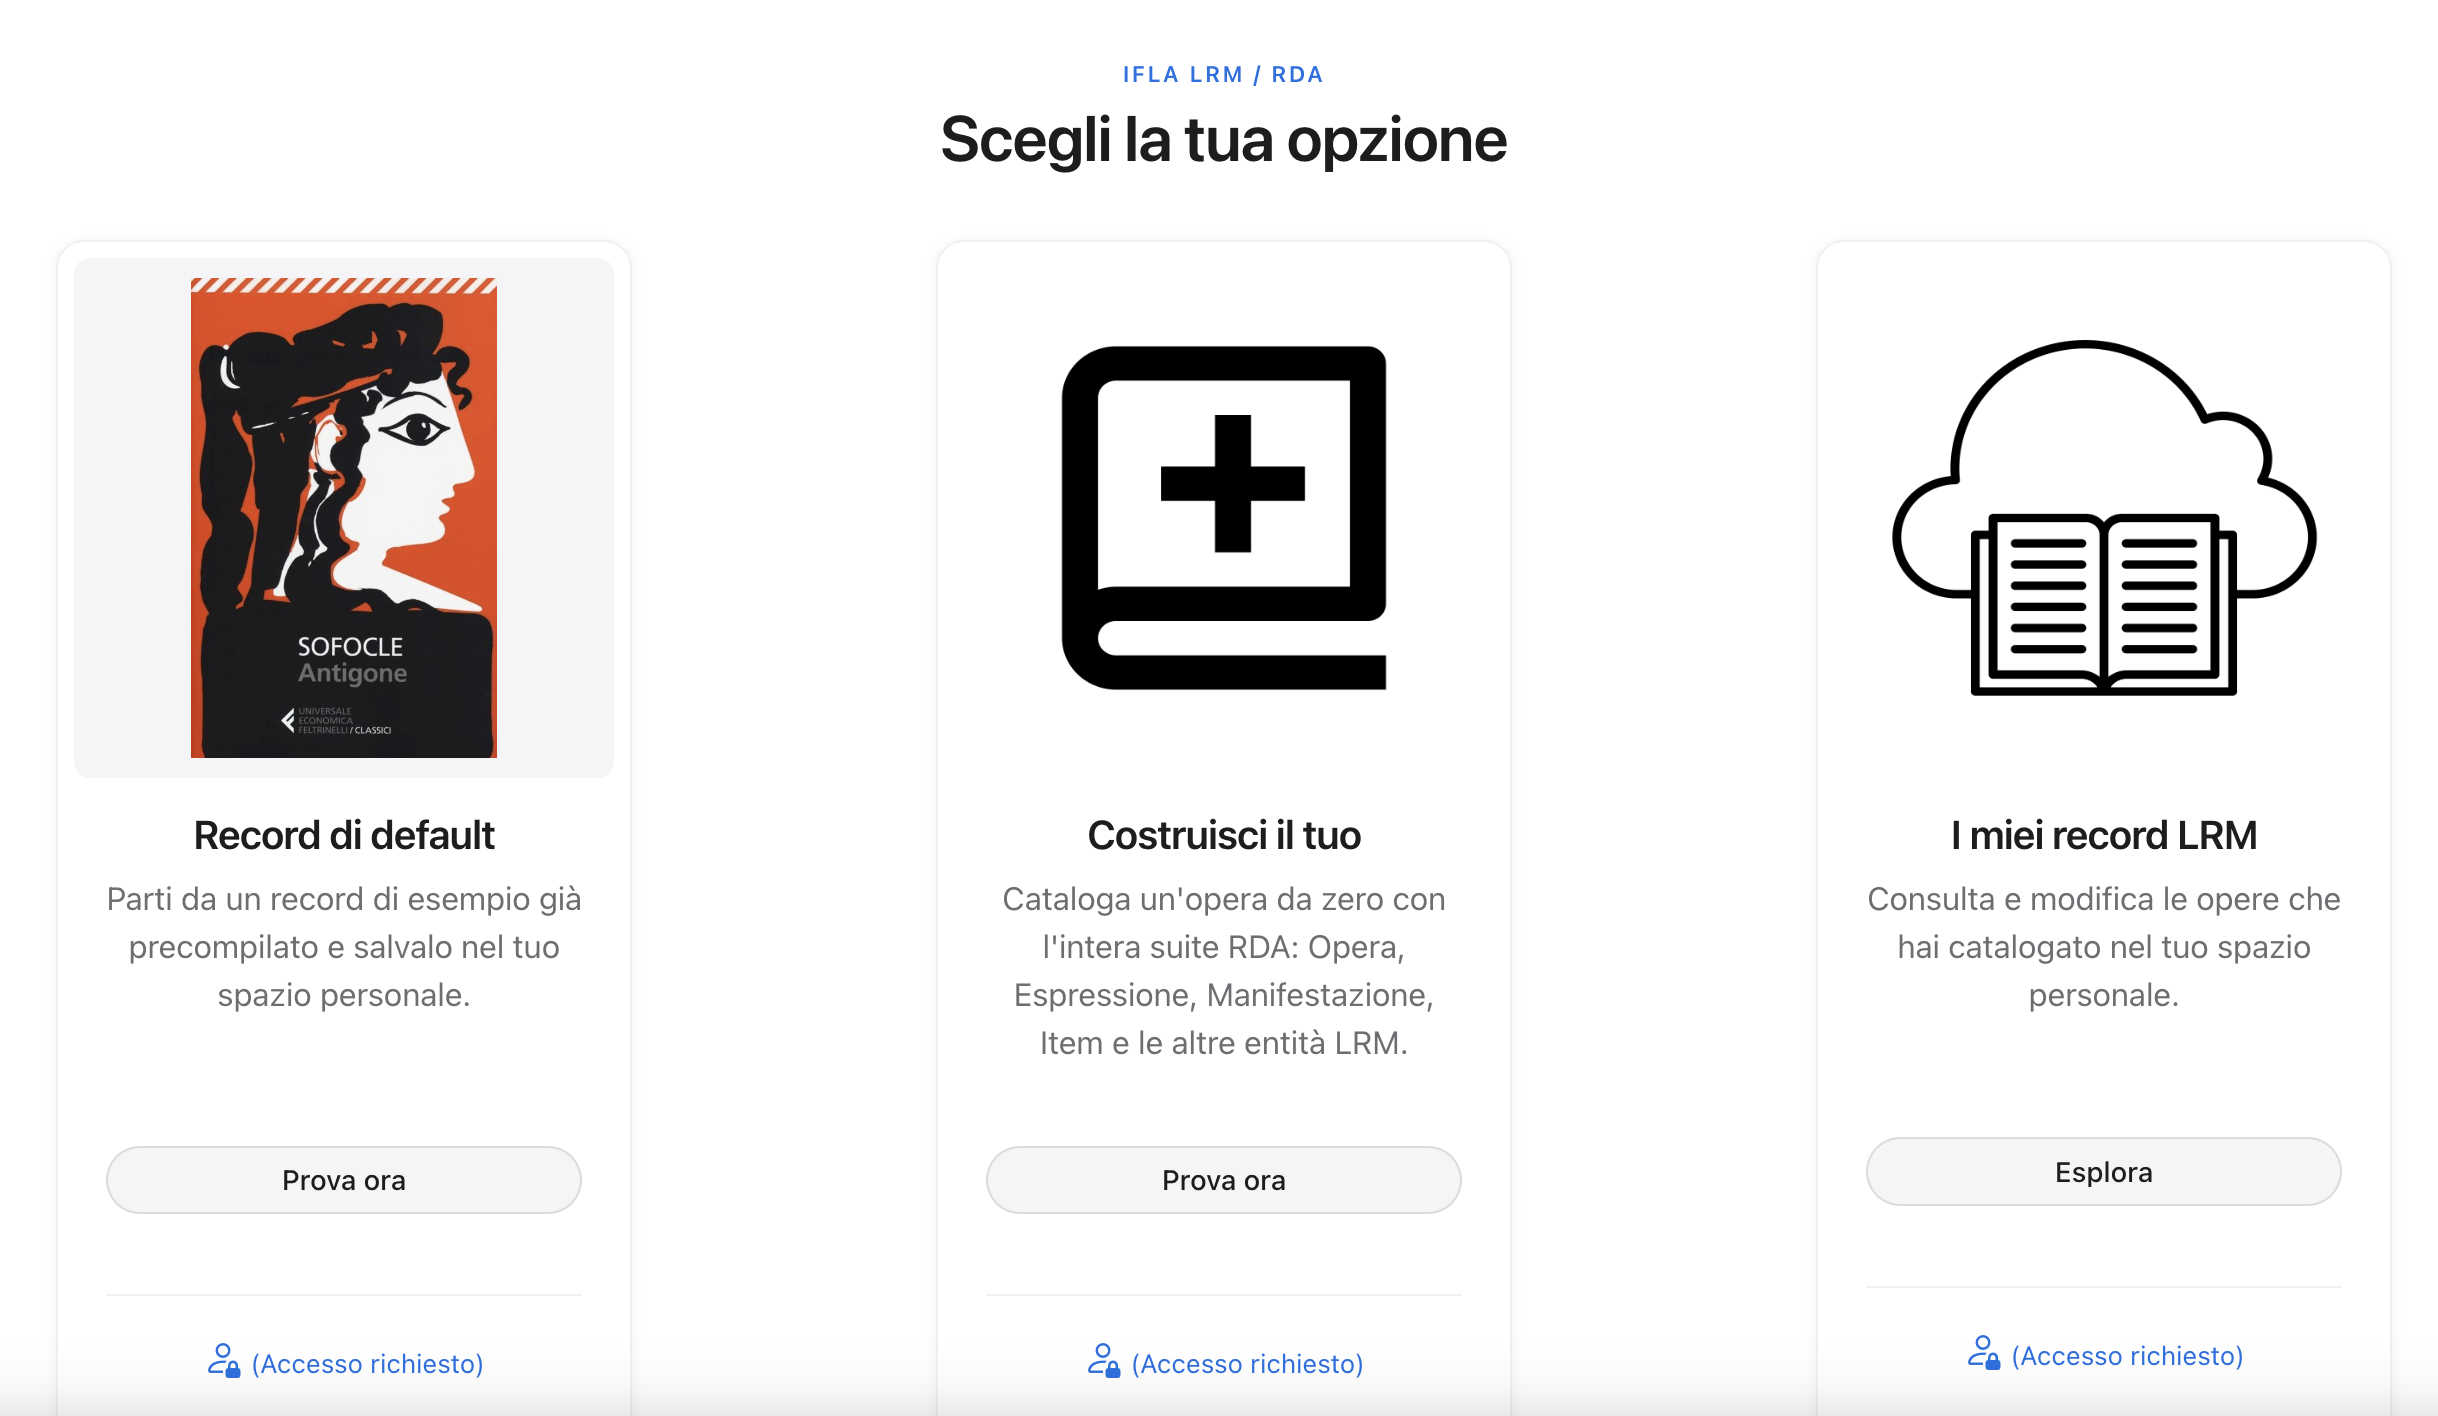
El hub de catalogación nativa IFLA LRM/RDA, con el espacio personal del catalogador
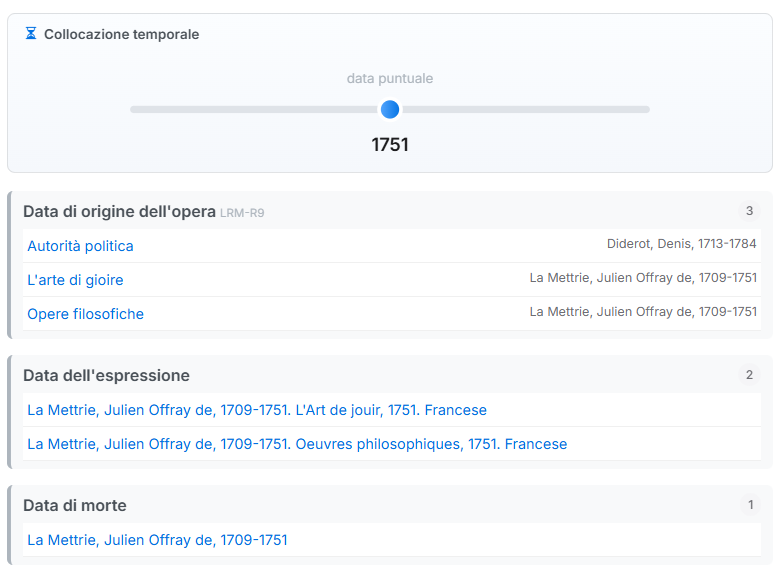
Navega las relaciones entre los recursos a través de la entidad Periodo temporal