MYLODLibrary est un catalogue bibliographique qui décrit des ressources non pas comme des notices isolées et autonomes, mais comme un réseau d'entités mises en relation les unes avec les autres selon la logique des Linked Open Data, le modèle conceptuel IFLA LRM et la norme de catalogage RDA.
Le présupposé est qu'un catalogue ne doit pas se borner à attester l'existence d'un document, mais doit expliciter les relations qui le traversent : le lien entre une œuvre et ses traductions, entre une édition et l'exemplaire conservé, entre un auteur et l'ensemble de ses écrits, entre un texte et les thèmes qu'il aborde, et bien d'autres encore. Une description bibliographique traditionnelle énonce ces rapports sous une forme discursive et fermée, intelligible au lecteur humain mais opaque à tout traitement automatique ; ici, ils sont en revanche codés dans une structure formelle, et donc interrogeables, vérifiables et réutilisables par des systèmes tiers.
Le projet intègre deux parcours de catalogage — le format bibliothéconomique traditionnel, le MARC21, et la description native en IFLA LRM — qui convergent vers le même catalogue public et alimentent un unique graphe de données RDF, librement interrogeable, y compris via un point d'accès SPARQL. Les sections qui suivent en retracent les principales composantes, de l'interface de consultation jusqu'aux outils de production et de publication des données.
Note aux lecteurs : les ressources contenues dans le catalogue MYLODLibrary appartiennent à une collection de livres privée et personnelle, en constante mise à jour, publiée dans le but d'être mise à disposition pour l'étude et l'évolution du projet. C'est pourquoi il importe de signaler qu'au niveau de la description de l'Item, les données ont pour seul objectif de valider les recherches et la production MYLOD et de fournir des outils d'étude pour la saisie des données et la construction des Linked Open Data.
Chercher et explorer
Le catalogue général est la porte d'accès au fonds décrit dans MYLODLibrary et constitue le point d'observation privilégié pour qui le consulte. L'interrogation peut se faire sous une forme simple — par titre, auteur ou sujet, avec la prise en charge de caractères joker pour les recherches partielles — ou sous une forme avancée, en combinant plusieurs critères au moyen d'opérateurs booléens (AND, OR, NOT) qui permettent de circonscrire progressivement l'ensemble des résultats jusqu'à isoler exactement ce qui intéresse.
L'interface de consultation offre une restitution analytique du contexte : à côté de la liste des résultats, un panneau de statistiques calculées dynamiquement décrit la portion du catalogue que l'on consulte, en l'articulant par langue du texte, lieu et date de publication, agents, etc. La possibilité de filtrer les résultats par mode d'enregistrement donne aux utilisateurs un aperçu de ce qui a été publié en format RDF natif ou, le cas échéant, à partir du MARC21. La recherche cesse ainsi d'être une simple récupération de notices et devient un instrument d'analyse : celui qui consulte n'obtient pas seulement une liste, mais un tableau quantitatif du sous-ensemble qu'il a isolé.
Chaque résultat déclare en outre sa propre provenance en indiquant le nombre total de triplets générés, rendant immédiatement perceptible la densité informationnelle qui sous-tend la description. De là, on accède à la notice complète de l'œuvre et à tous les formats sous lesquels elle est disponible.
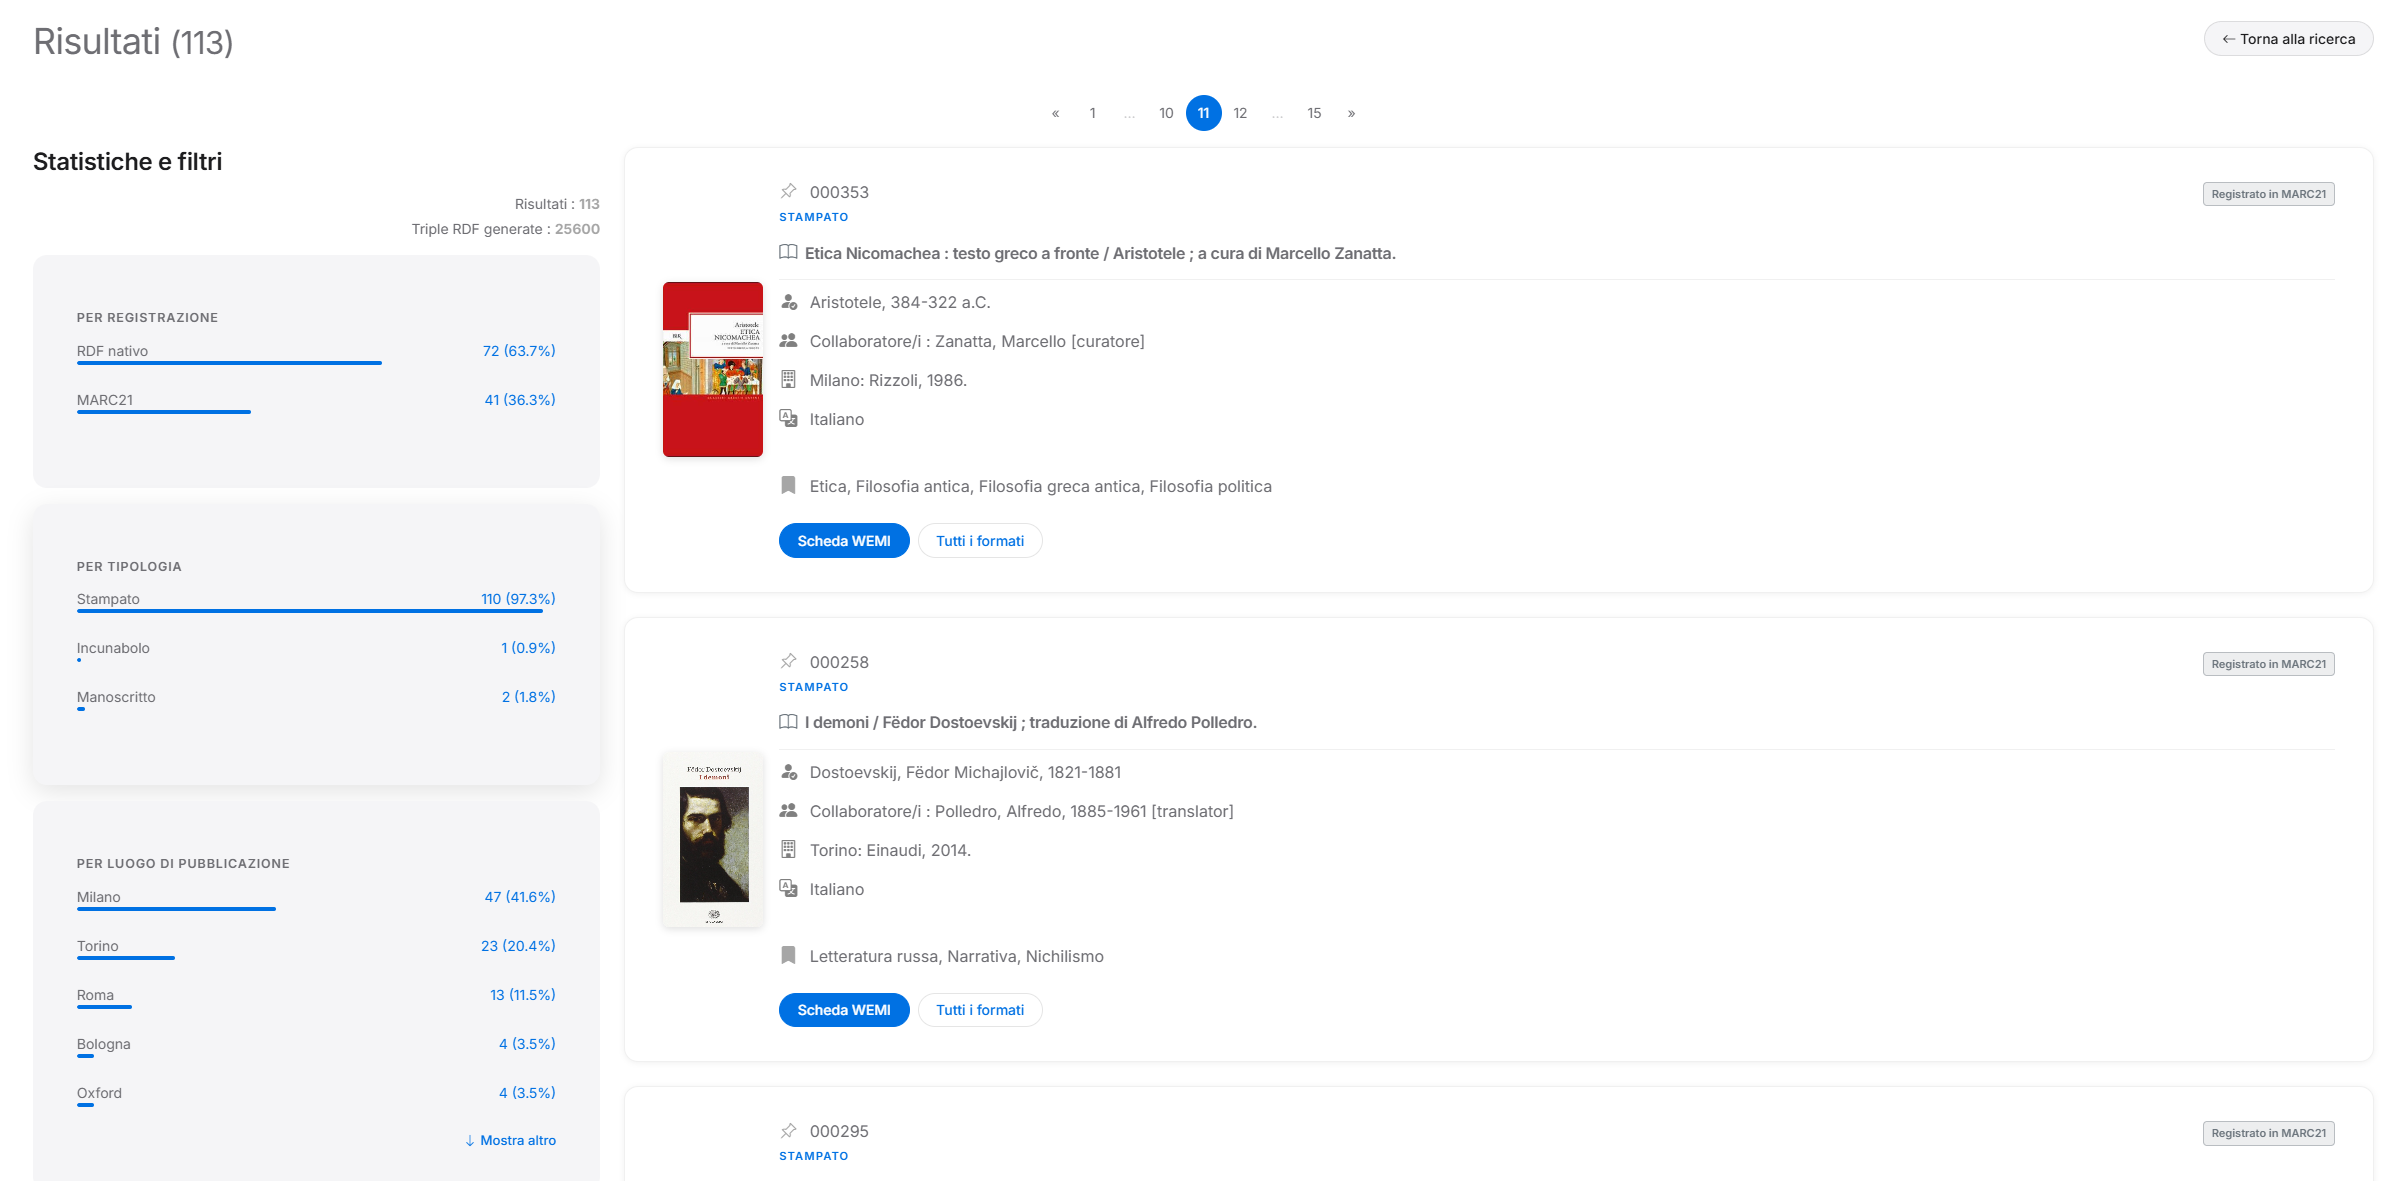
Recherche dans le catalogue général, avec filtres et statistiques en temps réel
Œuvre, Expression, Manifestation, Item
Au cœur de l'architecture conceptuelle du projet se place le modèle IFLA Library Reference Model, le cadre de référence par lequel la communauté bibliothéconomique internationale a repensé la description des ressources. Le principe est que ce que l'on appelle communément « un livre » n'est en réalité pas un objet unique, mais la superposition de quatre entités distinctes et hiérarchiquement liées.
L'Œuvre est le contenu intellectuel dans son abstraction — la Divine Comédie comme création de l'esprit, indépendamment de la manière dont on la lit. L'Expression en est une réalisation concrète : une traduction déterminée, une révision critique, une version dans une langue donnée. La Manifestation correspond à l'édition matériellement produite et publiée, avec son éditeur, son année, son ISBN. L'Item, enfin, est l'exemplaire unique physiquement conservé et rangé sur un rayon.
Décrire séparément ces quatre niveaux, plutôt que de les comprimer en une notice unique, permet au catalogue de répondre à des questions qu'une description plate n'est pas en mesure de formuler : combien de traductions existent d'une œuvre donnée, dans quelles éditions elles ont été publiées, quels exemplaires en sont conservés. Chaque entité est en outre mise en relation avec les agents qui l'ont produite, avec les sujets qu'elle traite, avec les lieux et les périodes auxquels elle se réfère.
Toute la trame de ces relations est inspectable sous forme de graphe interactif, généré automatiquement depuis la notice de chaque enregistrement : un outil qui rend visible — et pédagogiquement lisible — l'architecture sémantique qui soutient la description bibliographique. Ce schéma facilite également le système informatique qui produit les données, car il permet à la machine de générer, gérer et conserver automatiquement toutes les relations que le catalogueur est en mesure de décrire, offrant ainsi à ceux qui consultent le catalogue la liberté de se déplacer parmi les différents scénarios que les ressources englobent ou vers lesquels elles peuvent conduire, aussi bien à l'intérieur du catalogue qu'à l'extérieur.
La même logique relationnelle s'étend aux agents entre eux : une personne peut être déclarée membre d'une collectivité, une collectivité peut précéder ou succéder à une autre — fusions, scissions, changements de dénomination — et deux agents peuvent plus généralement être associés. Ces liens aussi, modélisés sur les types de relation définis par IFLA LRM, sont publiés comme triplets RDF et affichés sur la fiche publique de chaque agent.
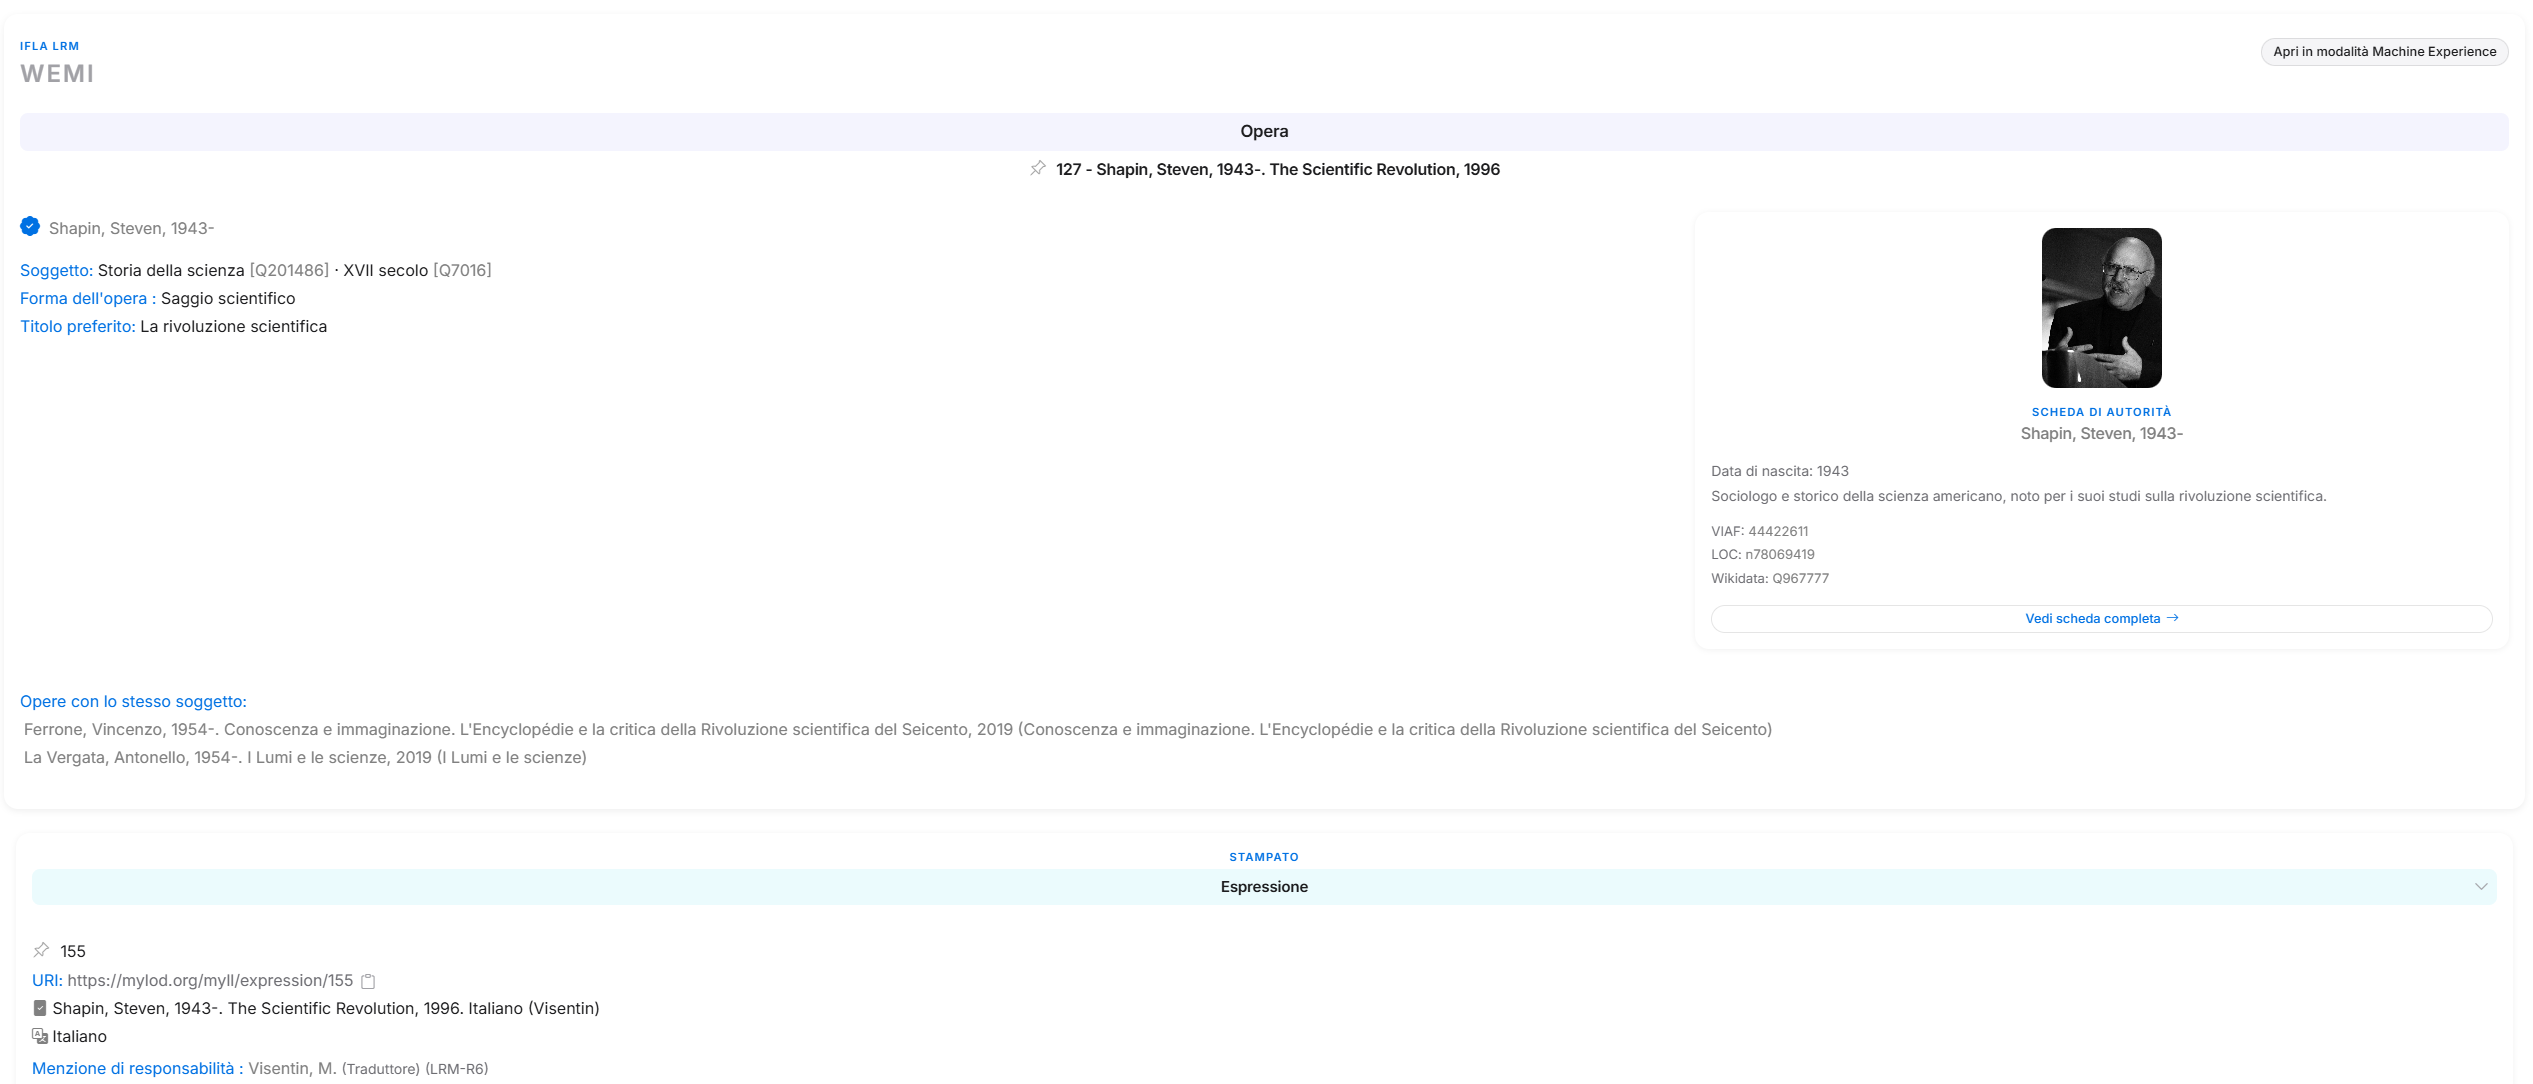
La cascade Œuvre → Expression → Manifestation, avec la notice d'autorité de l'agent à côté
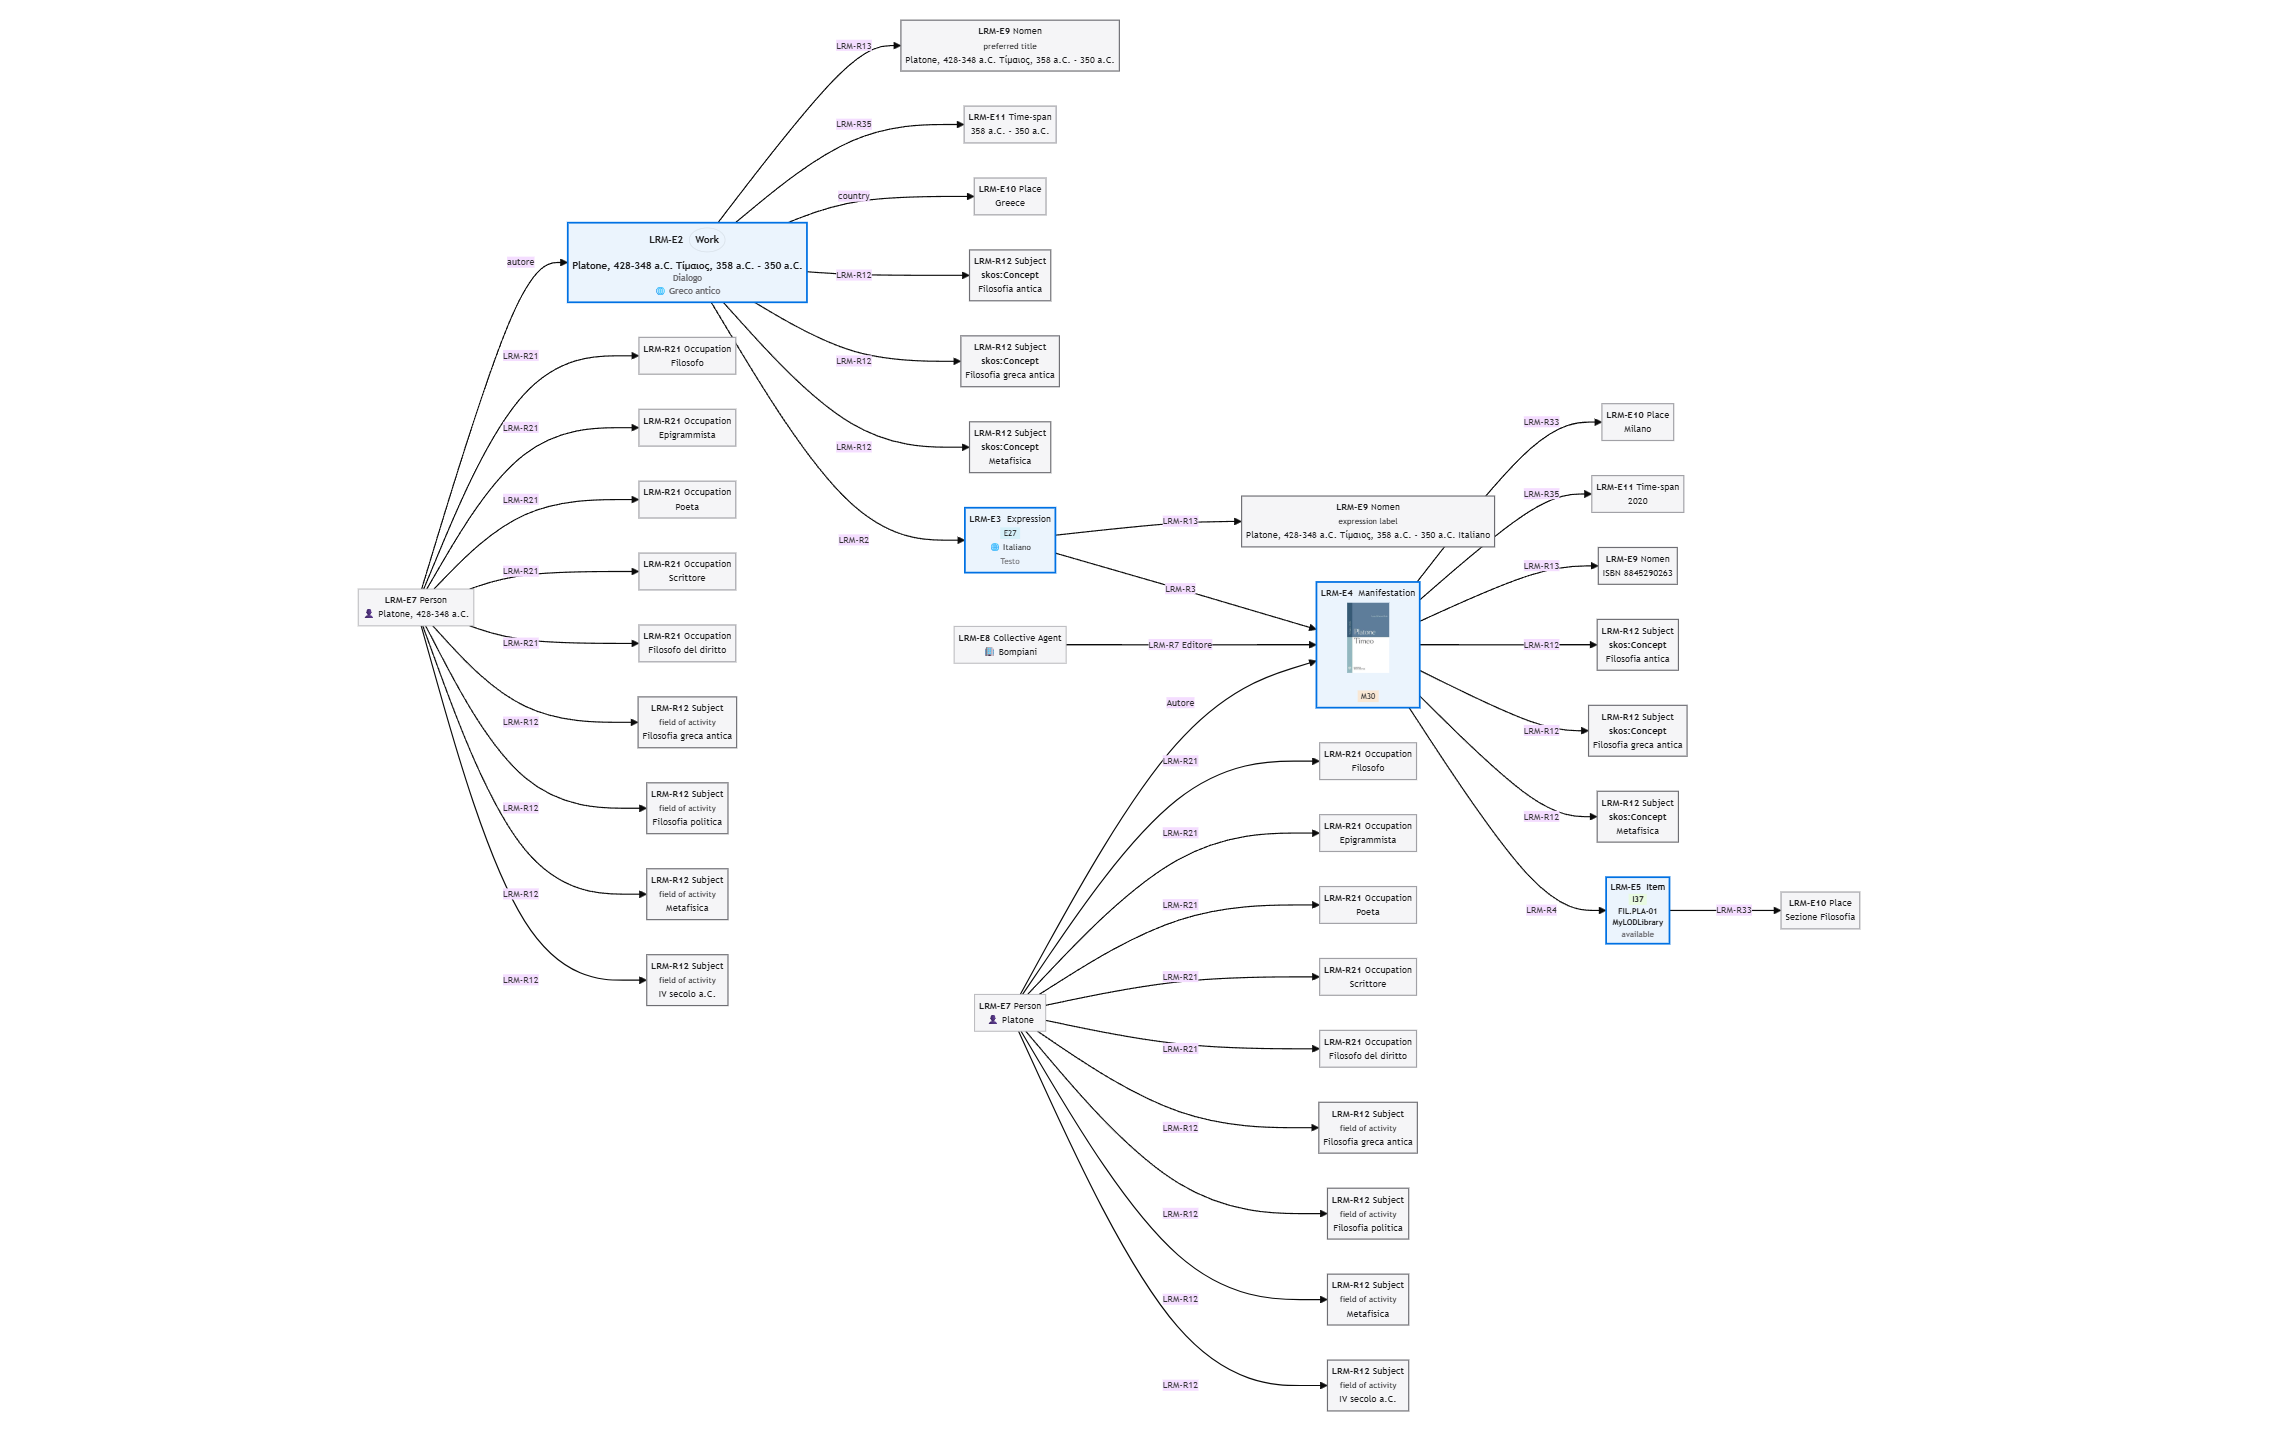
Le graphe des relations LRM, généré automatiquement pour chaque œuvre
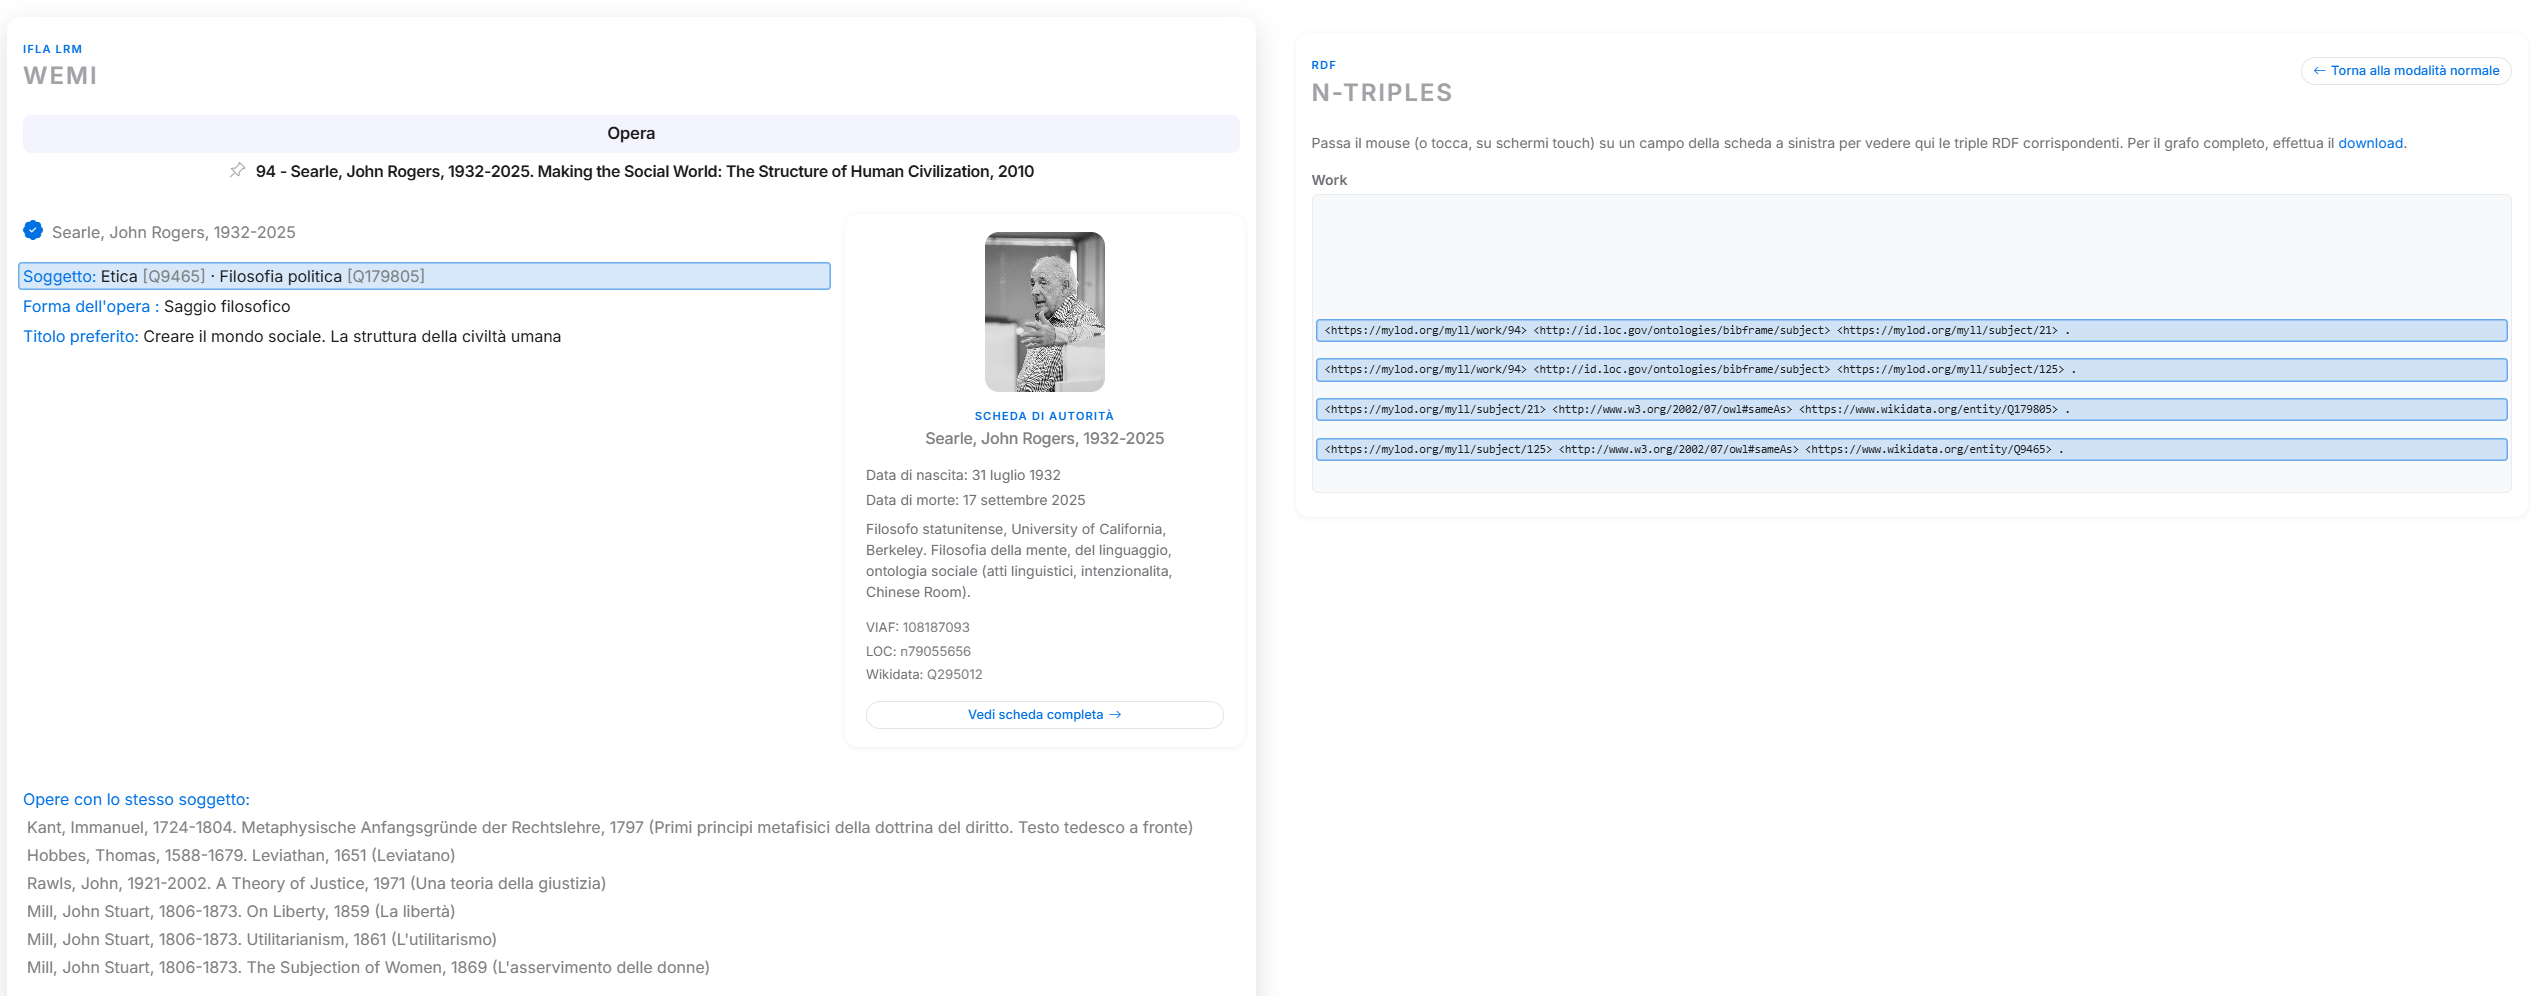
Faites cohabiter le langage naturel et celui de la machine, en explorant vos triplets RDF
Agents, lieux et sujets comme entités
Les auteurs, les collectivités, les lieux, les sujets, les professions et les titres uniformes ne figurent pas dans le catalogue comme des chaînes de texte répliquées dans chaque notice, mais comme des entités d'autorité autonomes : décrites une seule fois, dotées d'un identifiant pérenne propre et appelées par référence partout où elles apparaissent. C'est le principe du contrôle d'autorité, appliqué ici de manière systématique à toutes les classes d'entités prévues par le modèle.
Il en découle des conséquences concrètes. Une correction apportée à la forme du nom d'un auteur se propage instantanément à chaque œuvre qui y fait référence, sans nécessiter d'interventions répétées ; les variantes onomastiques, les pseudonymes et les formes en écritures différentes convergent vers la même entité, garantissant qu'une recherche menée sur l'une quelconque d'entre elles conduise malgré tout au même résultat.
Chaque notice d'autorité rassemble la forme préférée du nom, les formes variantes enregistrées, une note biographique ou descriptive et — élément décisif pour l'interopérabilité — les liens vers les identifiants des principales agences internationales : VIAF, Library of Congress, ISNI, Bibliothèque nationale de France, SBN et Wikidata, pour n'en citer que quelques-uns. Grâce à ces alignements, l'entité cesse d'être une donnée locale et s'insère dans le réseau mondial des autorités bibliographiques, où les données biographiques et géographiques peuvent être enrichies automatiquement depuis les sources liées.
Chaque description est enfin exportable dans les principaux formats RDF — Turtle, JSON-LD, N-Triples, RDF/XML, N-Quads — ou explorable directement dans un environnement d'interrogation de graphe.
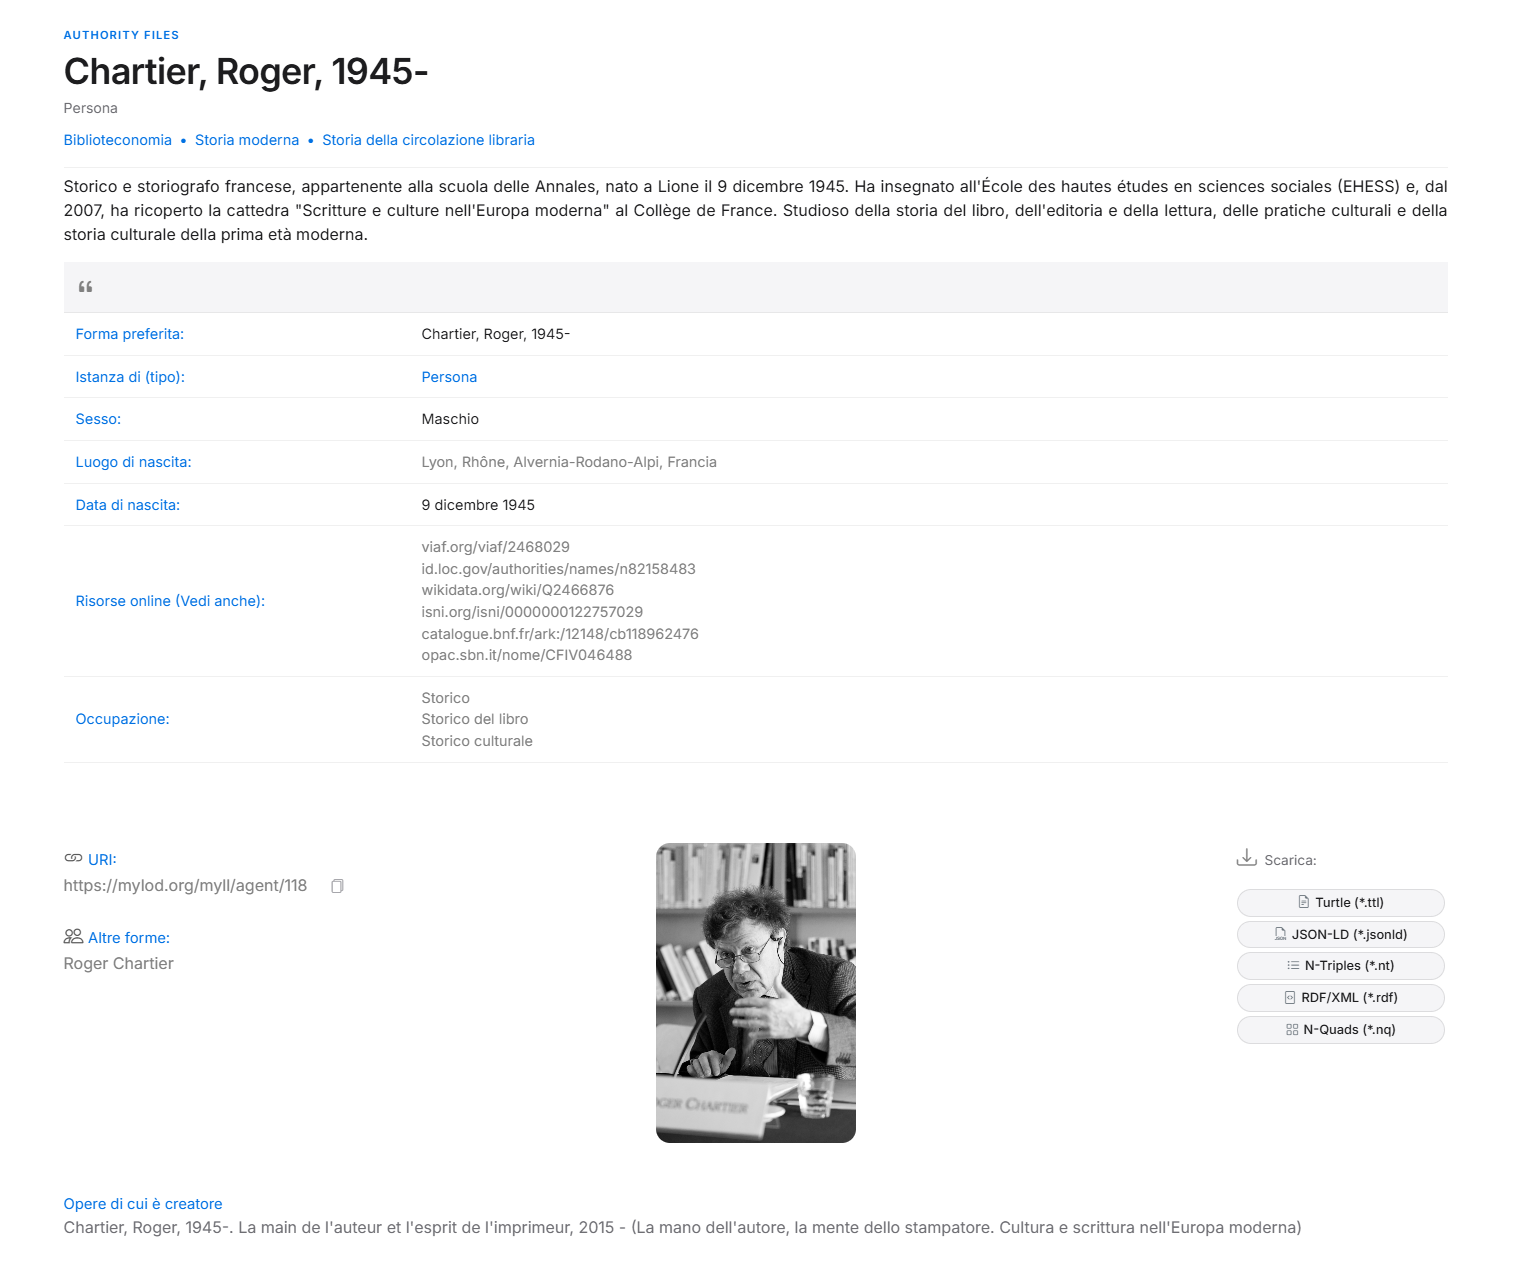
Notice d'autorité avec export RDF, enrichie automatiquement depuis Wikidata
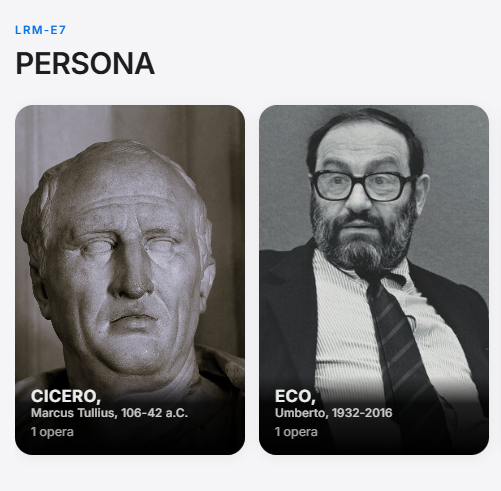
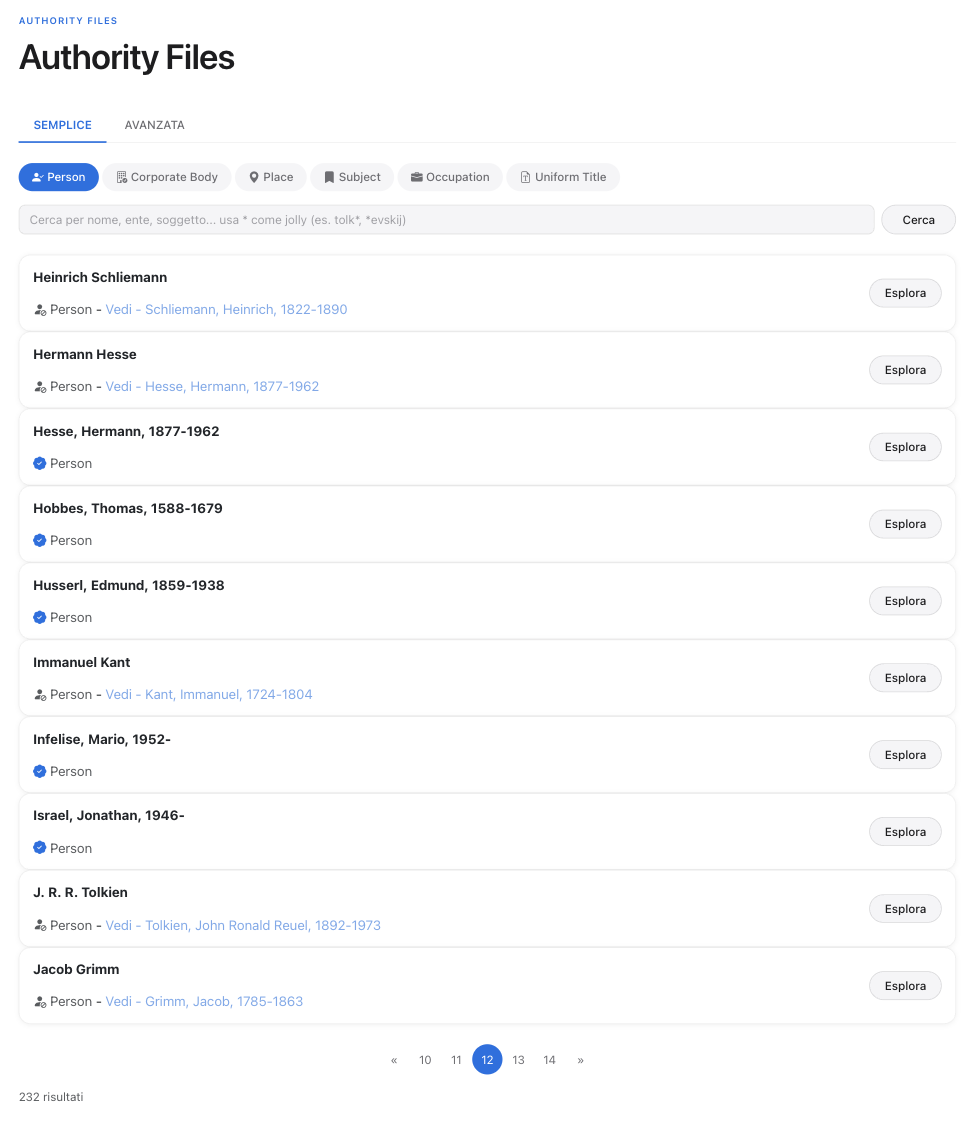
Les Personnes comme entités autonomes, et la recherche dédiée par type d'entité
Un graphe de données interrogeable
Chaque entité décrite dans le catalogue — œuvres, expressions, manifestations, exemplaires, agents, lieux, sujets et périodes — est simultanément publiée sous forme d'ensemble de triplets RDF, l'unité élémentaire du web sémantique, composés chacun d'un sujet, d'un prédicat et d'un objet. Les propriétés employées ne sont pas définies localement mais puisées dans les vocabulaires standards adoptés par la communauté internationale : BIBFRAME, FOAF, et bien d'autres.
Cette structure est ce qui permet aux données de sortir des frontières de l'application. Un système externe qui connaît ces vocabulaires est en mesure d'interpréter les descriptions de MYLODLibrary sans aucun accord préalable, de même que le catalogue peut à son tour se raccrocher à des ressources externes au moyen des identifiants partagés. Le résultat n'est pas une archive fermée, mais un nœud au sein d'un réseau documentaire plus vaste. La conversion des données du format MARC21 vers RDF (à travers diverses étapes de production ainsi que de format de la donnée disponible, comme le MARCXML) est conçue pour offrir au catalogueur la possibilité d'apprendre la sémantique des données RDF sans quitter le format MARC21. Cela est rendu possible par la coexistence parallèle de deux bases de données : la base relationnelle, sur laquelle opère le MARC21, et la base ouverte, construite pour héberger les données publiées pour le web sémantique.
L'ensemble du graphe de triplets est interrogeable publiquement en SPARQL, le langage natif pour l'exploration des données RDF, au moyen d'un point d'accès en lecture seule. Pour abaisser le seuil d'entrée et faciliter la recherche, l'interface propose un recueil de requêtes déjà prêtes — la répartition des langues, les auteurs actifs à un siècle donné, les sujets les plus récurrents — qui peuvent être exécutées immédiatement puis modifiées : une manière d'apprendre le langage en en observant les effets, sans aucune compétence préalable.
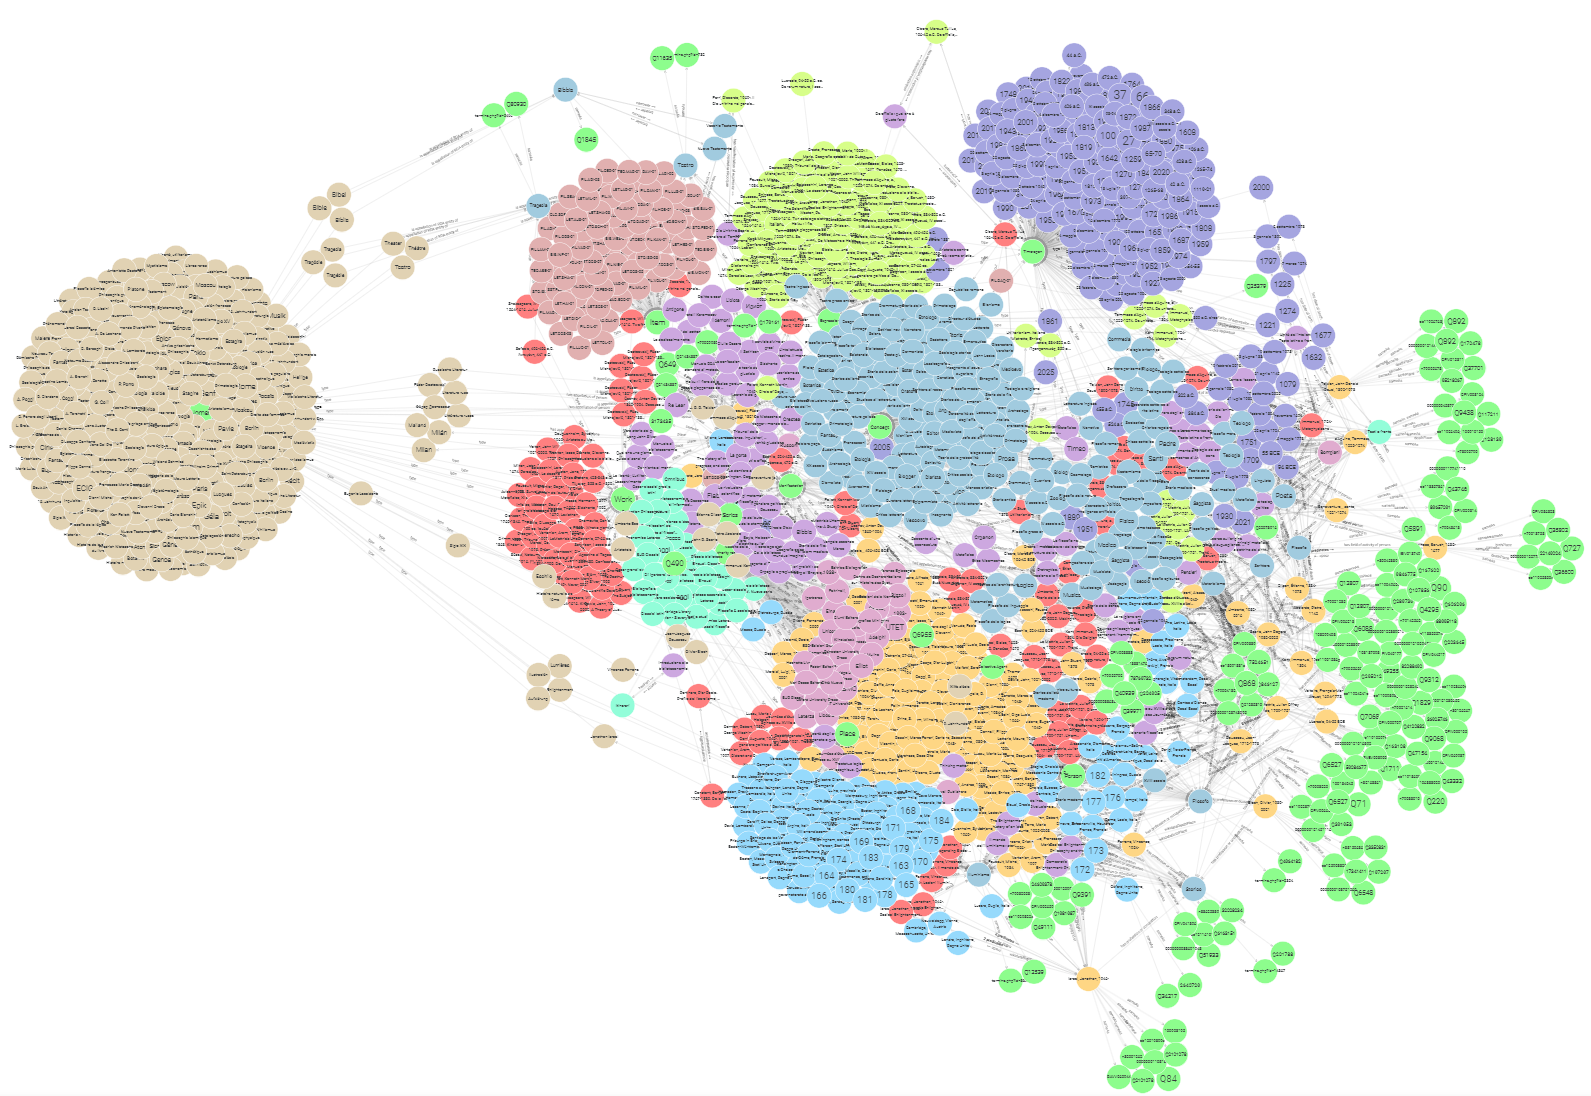
Une portion du graphe RDF du catalogue : chaque nœud est une entité, chaque arête une relation
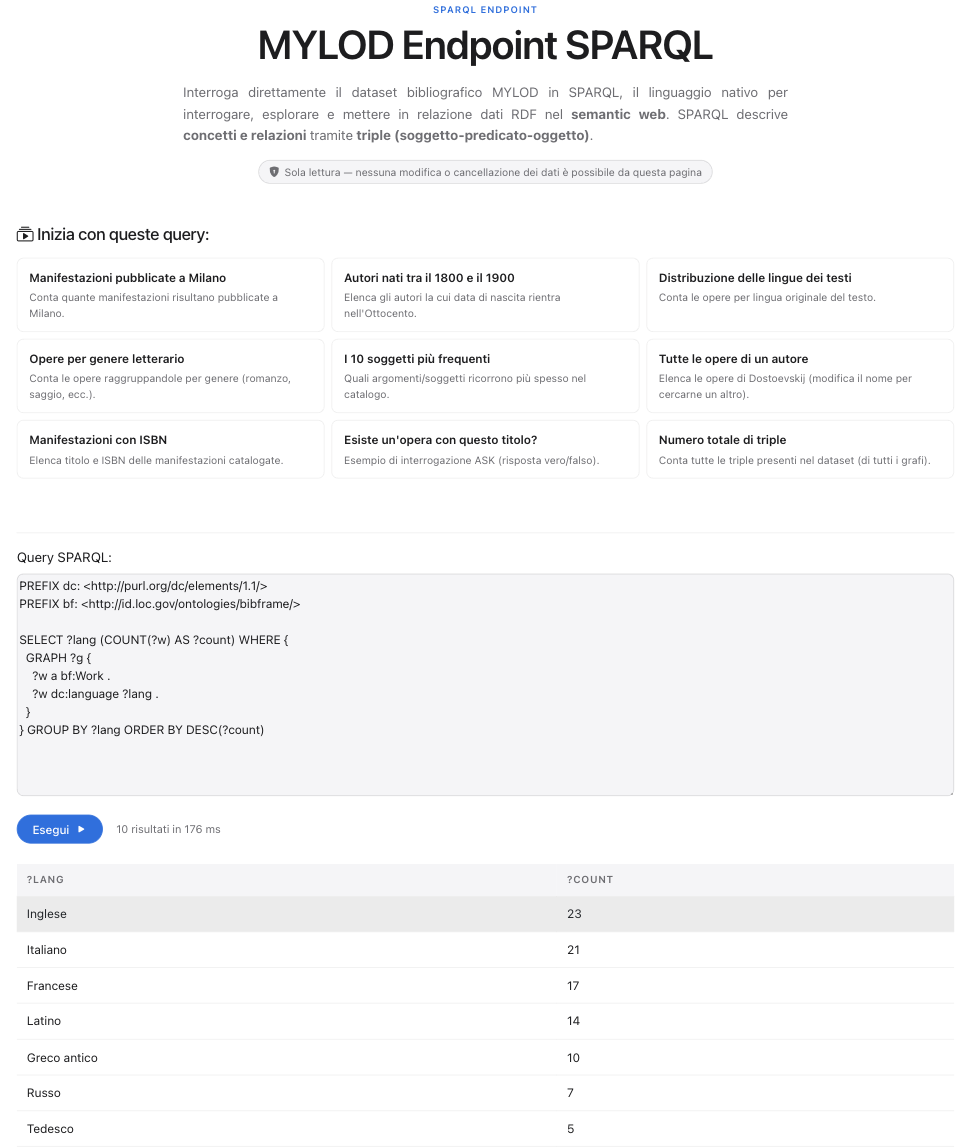
Le point d'accès SPARQL public, avec des requêtes d'exemple prêtes à l'emploi
MARC21, RDF natif et votre espace personnel
Du côté de la production des données, MYLODLibrary emprunte deux voies parallèles plutôt que d'en imposer une seule. La première part du format bibliothéconomique traditionnel : on rédige une notice MARC21 selon la pratique établie et une procédure automatique en dérive, champ par champ, les entités LRM correspondantes, en générant la chaîne Œuvre-Expression-Manifestation-Item et les liens d'autorité associés. La seconde permet le catalogage natif direct selon les modèles RDA et IFLA LRM, au moyen d'une suite de formulaires dédiés à chaque entité du modèle.
Les deux voies ne sont pas des alternatives l'une à l'autre, mais des réponses à des besoins différents : la première préserve l'investissement en formation et les flux de travail de ceux qui opèrent déjà en MARC21, la seconde permet d'exploiter l'expressivité du modèle LRM sans les contraintes d'un format conçu à une autre époque technologique. Toutes deux convergent vers le même catalogue et le même graphe RDF. Cela signifie que chaque entité répond aux exigences de catalogage indépendamment du format choisi. Que l'on produise du RDF natif ou que l'on parte du MARC21, on aboutit dans tous les cas à la publication en cascade du système WEMI.
À chaque utilisateur inscrit est en outre réservé un espace de catalogage personnel — un laboratoire où s'exercer et construire ses propres descriptions, en partant de zéro ou d'une notice d'exemple déjà remplie. Les données traitées dans cet espace restent rigoureusement privées : elles n'apparaissent pas dans le catalogue public, ne sont pas visibles par les autres utilisateurs et n'entrent pas dans le graphe interrogeable. C'est une condition essentielle pour que l'outil puisse être employé également dans des contextes pédagogiques, où l'erreur — et, le cas échéant, le signalement d'opérations de maintenance de la plateforme — fait partie du parcours de croissance et d'apprentissage.
L'espace personnel n'est cependant pas un compartiment isolé du reste du catalogue : le catalogueur peut librement réutiliser les entités d'autorité déjà publiques — un agent, un lieu, un sujet, une profession — exactement comme le ferait un catalogueur expérimenté, évitant ainsi toute duplication inutile. Les Expressions, les Manifestations et les Exemplaires restent en revanche toujours des entités propres et distinctes : même lorsqu'ils décrivent une œuvre déjà présente dans le catalogue général, ils ne sont jamais fusionnés ni superposés aux notices existantes. Cette distinction est délibérée : les autorités sont un patrimoine partagé, la description bibliographique détaillée reste personnelle.
Le modèle descriptif ne se limite pas au livre imprimé : les manuscrits et les livres anciens disposent de sections dédiées — support, foliotation, écriture, reliure, empreinte, marque typographique — et, pour les manuscrits, d'un module de transcription en TEI/XML, généré automatiquement à partir des métadonnées déjà cataloguées ou importé depuis un fichier produit ailleurs et validé selon le schéma officiel TEI. Pour compléter le tableau, chaque Manifestation peut héberger sa propre copie numérique — un PDF déposé directement sur la plateforme, consultable depuis la fiche publique sans logiciel externe.
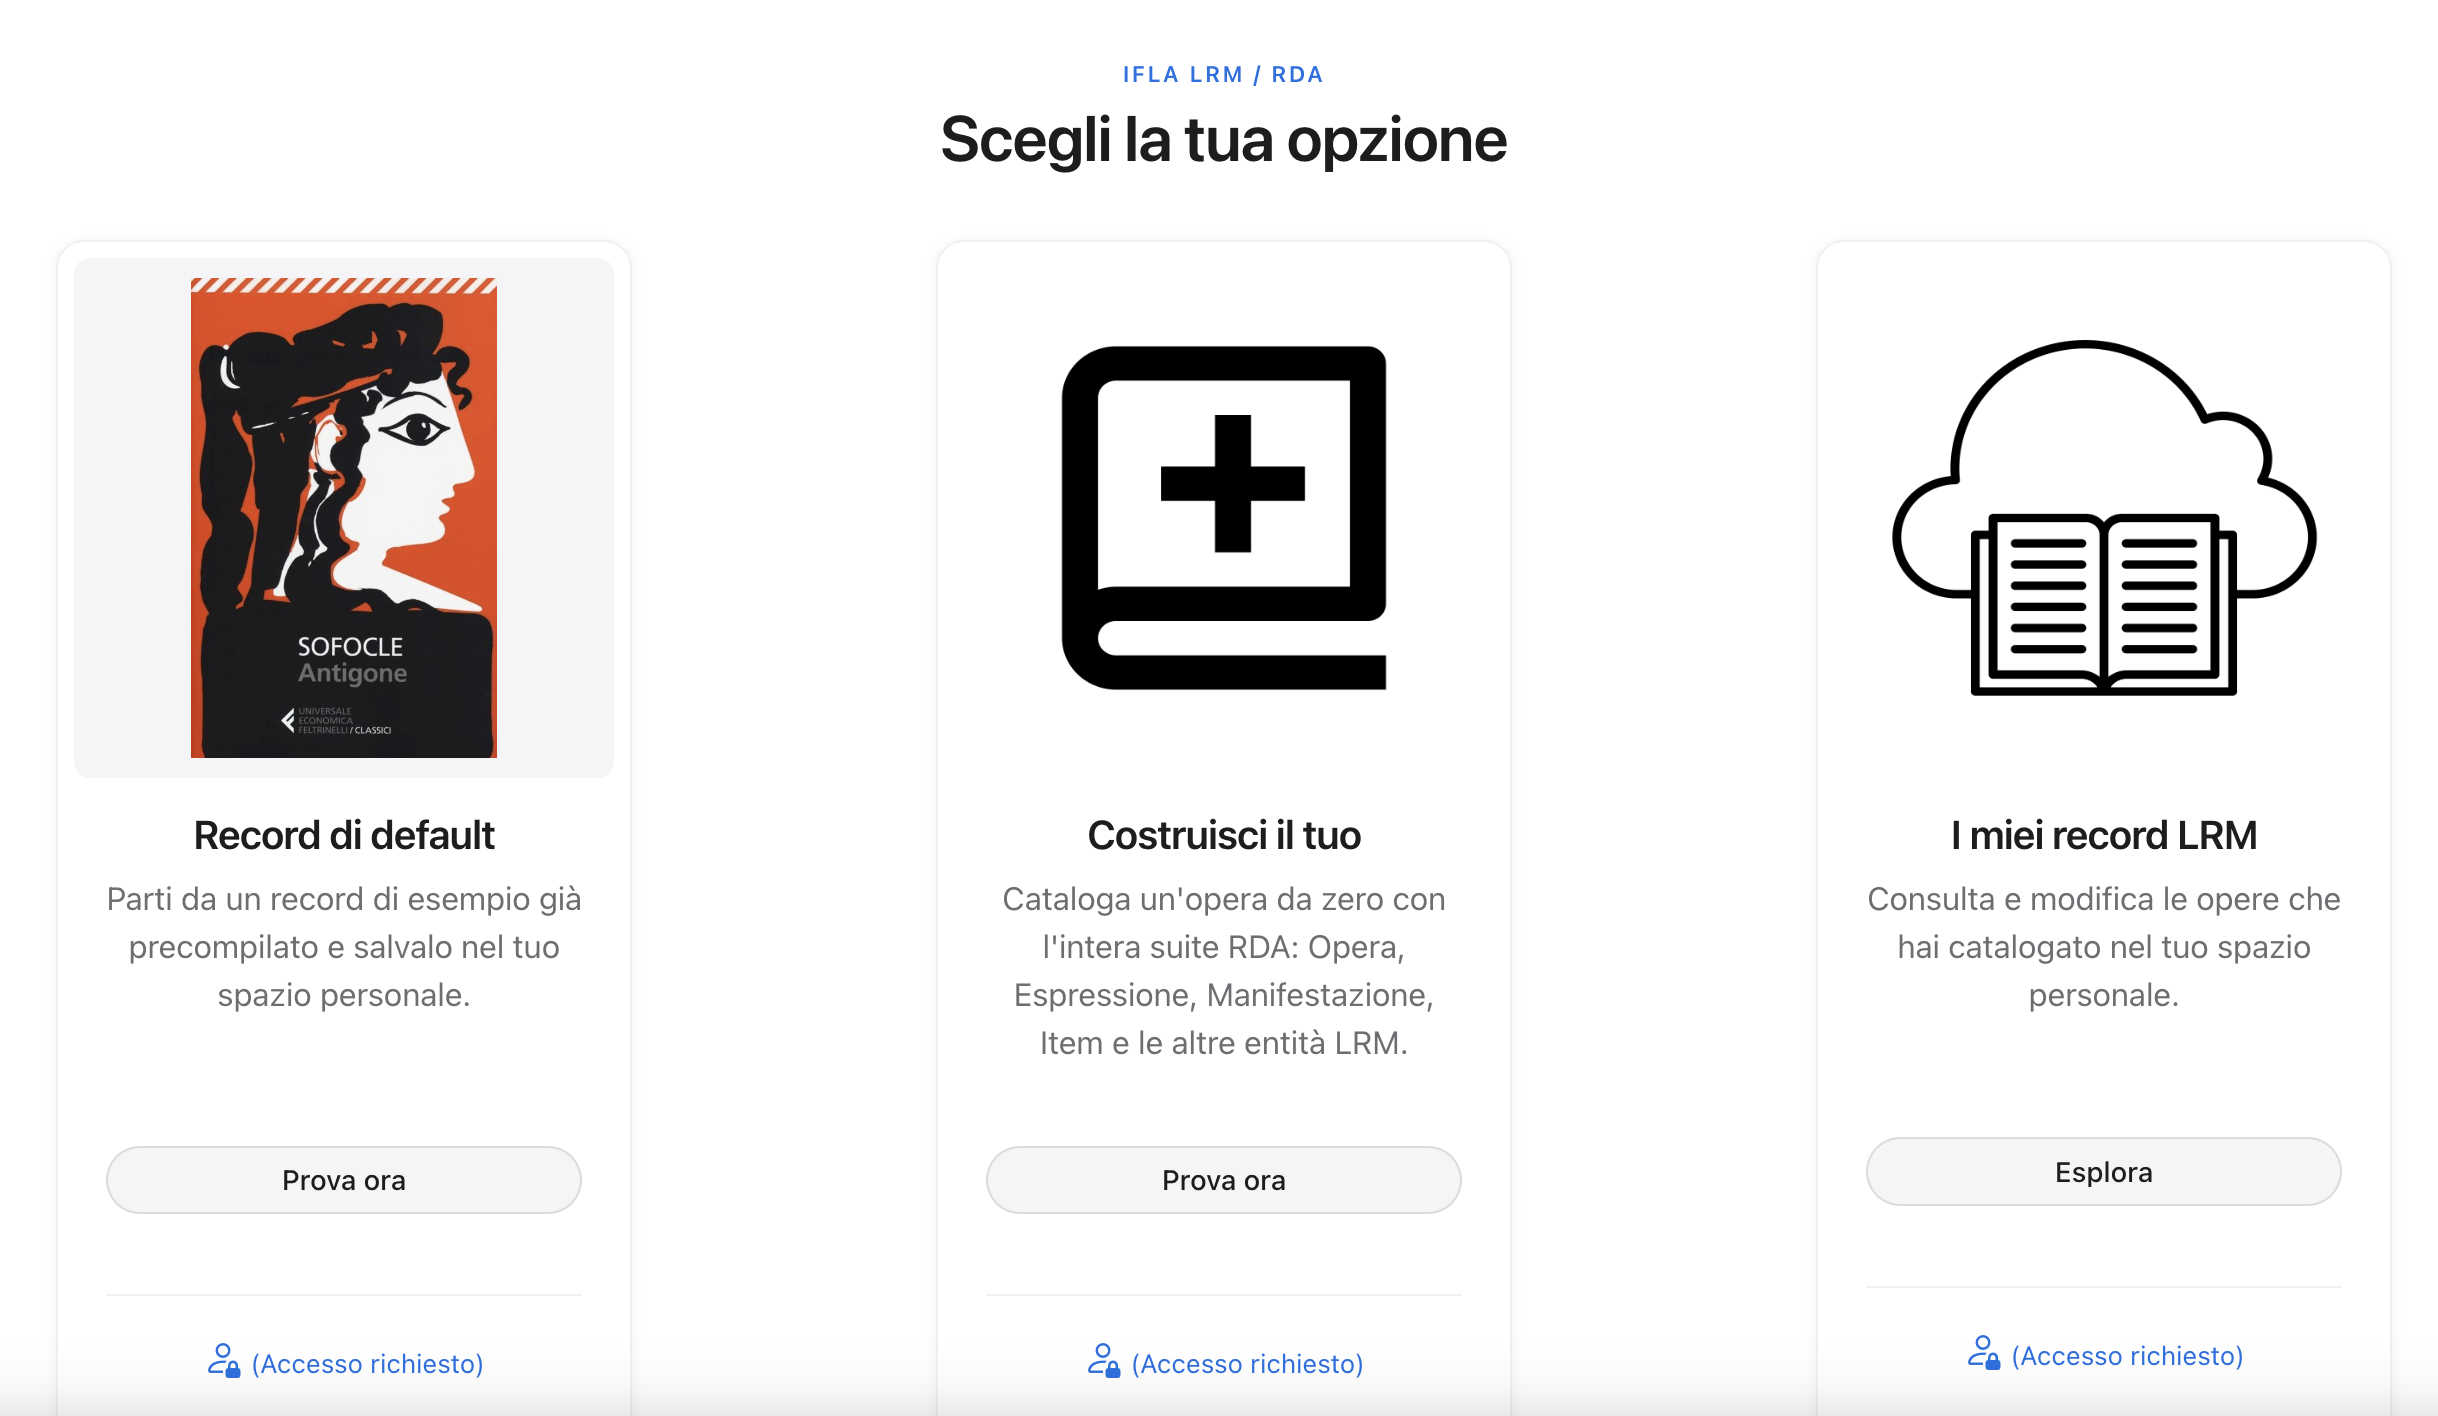
Le hub de catalogage natif IFLA LRM/RDA, avec l'espace personnel du catalogueur
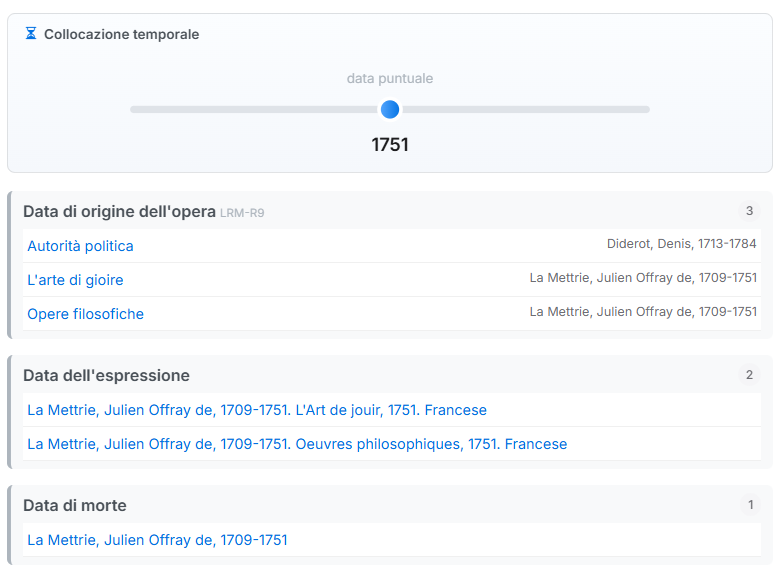
Naviguer dans les relations entre les ressources grâce à l'entité Période temporelle