MYLODLibrary ist ein bibliographischer Katalog, der Ressourcen nicht als isolierte, in sich geschlossene Datensätze beschreibt, sondern als ein Netz von Entitäten, die nach der Logik der Linked Open Data, dem konzeptionellen Modell IFLA LRM und dem Katalogisierungsstandard RDA miteinander in Beziehung gesetzt werden.
Die Voraussetzung ist, dass ein Katalog sich nicht darauf beschränken darf, die Existenz eines Dokuments zu bezeugen, sondern die Beziehungen sichtbar machen muss, die es durchziehen: die Verbindung zwischen einem Werk und seinen Übersetzungen, zwischen einer Ausgabe und dem aufbewahrten Exemplar, zwischen einem Autor und der Gesamtheit seiner Schriften, zwischen einem Text und den Themen, die er behandelt, und vieles mehr. Eine herkömmliche bibliographische Beschreibung formuliert diese Zusammenhänge in einer diskursiven und geschlossenen Form, verständlich für den menschlichen Leser, aber undurchsichtig für jede automatische Verarbeitung; hier hingegen sind sie in einer formalen Struktur kodiert und damit abfragbar, überprüfbar und von Drittsystemen nachnutzbar.
Das Projekt vereint zwei Katalogisierungswege — das traditionelle bibliothekarische Format, MARC21, und die native Beschreibung in IFLA LRM —, die im selben öffentlichen Katalog zusammenlaufen und einen einzigen RDF-Datengraphen speisen, der frei abfragbar ist, auch über einen SPARQL-Endpunkt. Die folgenden Abschnitte zeichnen die wichtigsten Komponenten nach, von der Rechercheoberfläche bis zu den Werkzeugen für Erzeugung und Veröffentlichung der Daten.
Hinweis für die Leser: Die im Katalog MYLODLibrary enthaltenen Ressourcen gehören zu einer privaten, persönlichen Büchersammlung, die ständig erweitert und mit dem Ziel veröffentlicht wird, für das Studium und die Weiterentwicklung des Projekts zur Verfügung gestellt zu werden. Aus diesem Grund ist darauf hinzuweisen, dass die Daten auf der Ebene der Item-Beschreibung ausschließlich dazu dienen, die Recherchen und die Produktion von MYLOD zu validieren und Studienwerkzeuge für die Dateneingabe und den Aufbau der Linked Open Data bereitzustellen.
Suchen und erkunden
Der allgemeine Katalog ist das Zugangstor zu den in MYLODLibrary beschriebenen Beständen und bildet den bevorzugten Beobachtungspunkt für alle, die ihn nutzen. Die Abfrage kann in einfacher Form erfolgen — nach Titel, Autor oder Thema, mit Unterstützung von Platzhaltern für Teilsuchen — oder in erweiterter Form, indem mehrere Kriterien über boolesche Operatoren (AND, OR, NOT) kombiniert werden, die es erlauben, die Treffermenge schrittweise einzugrenzen, bis genau das Gesuchte isoliert ist.
Die Rechercheoberfläche bietet eine analytische Wiedergabe des Kontexts: neben der Trefferliste beschreibt ein Panel dynamisch berechneter Statistiken den Ausschnitt des Katalogs, der gerade betrachtet wird, aufgegliedert nach Sprache des Textes, Ort und Datum der Veröffentlichung, Akteuren und so weiter. Die Möglichkeit, die Treffer nach Erfassungsart zu filtern, gibt den Nutzenden einen Überblick darüber, was im nativen RDF-Format oder gegebenenfalls ausgehend von MARC21 veröffentlicht wurde. Die Suche ist damit nicht länger ein bloßes Abrufen von Datensätzen, sondern wird zu einem Analyseinstrument: Nutzende erhalten nicht nur eine Liste, sondern eine quantitative Übersicht der von ihnen isolierten Teilmenge.
Jeder Treffer weist zudem seine eigene Herkunft aus, indem er die Gesamtzahl der erzeugten Tripel nennt, wodurch die Informationsdichte hinter der Beschreibung unmittelbar wahrnehmbar wird. Von hier gelangt man zur vollständigen Beschreibung des Werks und zu allen Formaten, in denen es vorliegt.
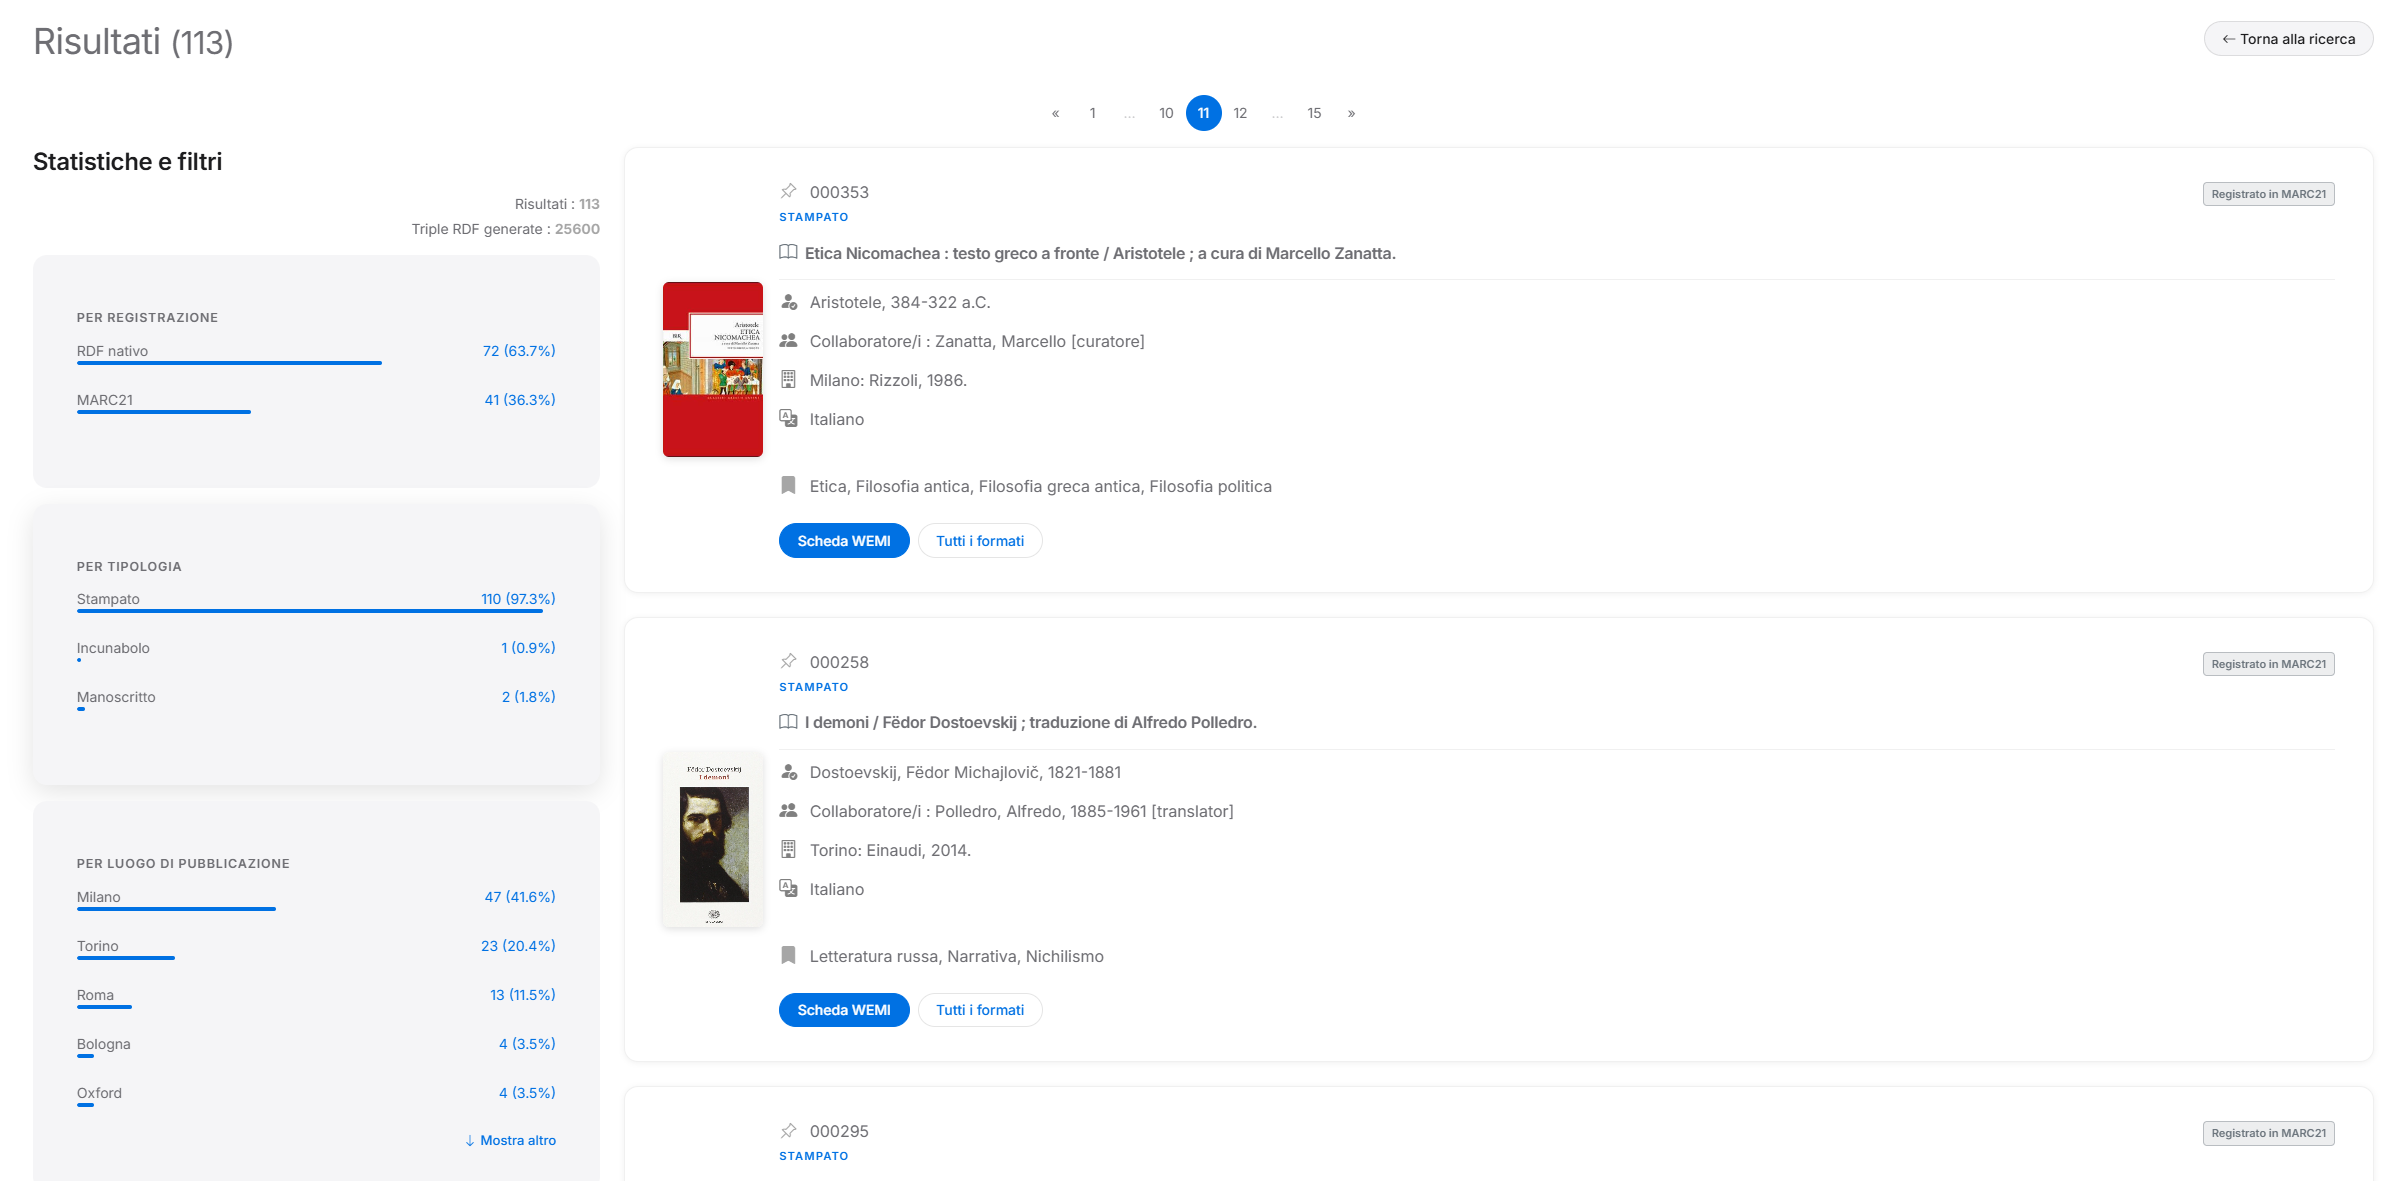
Suche im allgemeinen Katalog, mit Filtern und Echtzeitstatistiken
Werk, Expression, Manifestation, Exemplar
Im Zentrum des konzeptionellen Gerüsts des Projekts steht das IFLA Library Reference Model, jener Bezugsrahmen, mit dem die internationale Bibliotheksgemeinschaft die Beschreibung von Ressourcen neu gedacht hat. Der Grundsatz lautet, dass das, was wir gemeinhin „ein Buch" nennen, in Wirklichkeit kein einzelnes Objekt ist, sondern die Überlagerung von vier unterschiedlichen, hierarchisch verbundenen Entitäten.
Das Werk ist der geistige Inhalt in seiner Abstraktion — die Göttliche Komödie als Schöpfung des Geistes, unabhängig davon, wie man sie liest. Die Expression ist eine konkrete Realisierung davon: eine bestimmte Übersetzung, eine kritische Revision, eine Fassung in einer bestimmten Sprache. Die Manifestation entspricht der materiell hergestellten und veröffentlichten Ausgabe, mit ihrem Verlag, ihrem Jahr, ihrer ISBN. Das Exemplar schließlich ist das einzelne physisch vorhandene und im Regal aufgestellte Stück.
Diese vier Ebenen getrennt zu beschreiben, statt sie in einem einzigen Datensatz zusammenzupressen, erlaubt es dem Katalog, Fragen zu beantworten, die eine flache Beschreibung nicht einmal formulieren kann: wie viele Übersetzungen eines bestimmten Werks existieren, in welchen Ausgaben sie erschienen sind, welche Exemplare davon aufbewahrt werden. Jede Entität wird zudem in Beziehung gesetzt zu den Akteuren, die sie hervorgebracht haben, zu den Themen, die sie behandelt, sowie zu den Orten und Zeiträumen, auf die sie sich bezieht.
Das gesamte Geflecht dieser Beziehungen lässt sich als interaktiver Graph betrachten, der automatisch aus der Beschreibung jedes Datensatzes erzeugt wird: ein Werkzeug, das die semantische Architektur hinter der bibliographischen Beschreibung sichtbar — und didaktisch lesbar — macht. Dieses Schema erleichtert zudem dem Softwaresystem die Erzeugung der Daten, da es der Maschine erlaubt, alle Beziehungen, die der Katalogisierende zu beschreiben vermag, automatisch zu erzeugen, zu verwalten und zu bewahren, und so denjenigen, die den Katalog nutzen, die Freiheit gibt, sich durch die verschiedenen Szenarien zu bewegen, die die Ressourcen umfassen oder zu denen sie führen können, sowohl innerhalb des Katalogs als auch außerhalb.
Dieselbe Beziehungslogik erstreckt sich auch auf die Handelnden selbst: Eine Person kann als Mitglied einer Körperschaft ausgewiesen werden, eine Körperschaft kann einer anderen vorausgehen oder nachfolgen — durch Fusionen, Abspaltungen, Namensänderungen —, und zwei Akteure können allgemeiner als assoziiert erfasst werden. Auch diese Verknüpfungen, modelliert nach den von IFLA LRM definierten Beziehungstypen, werden als RDF-Tripel veröffentlicht und im öffentlichen Datensatz jedes Akteurs angezeigt.
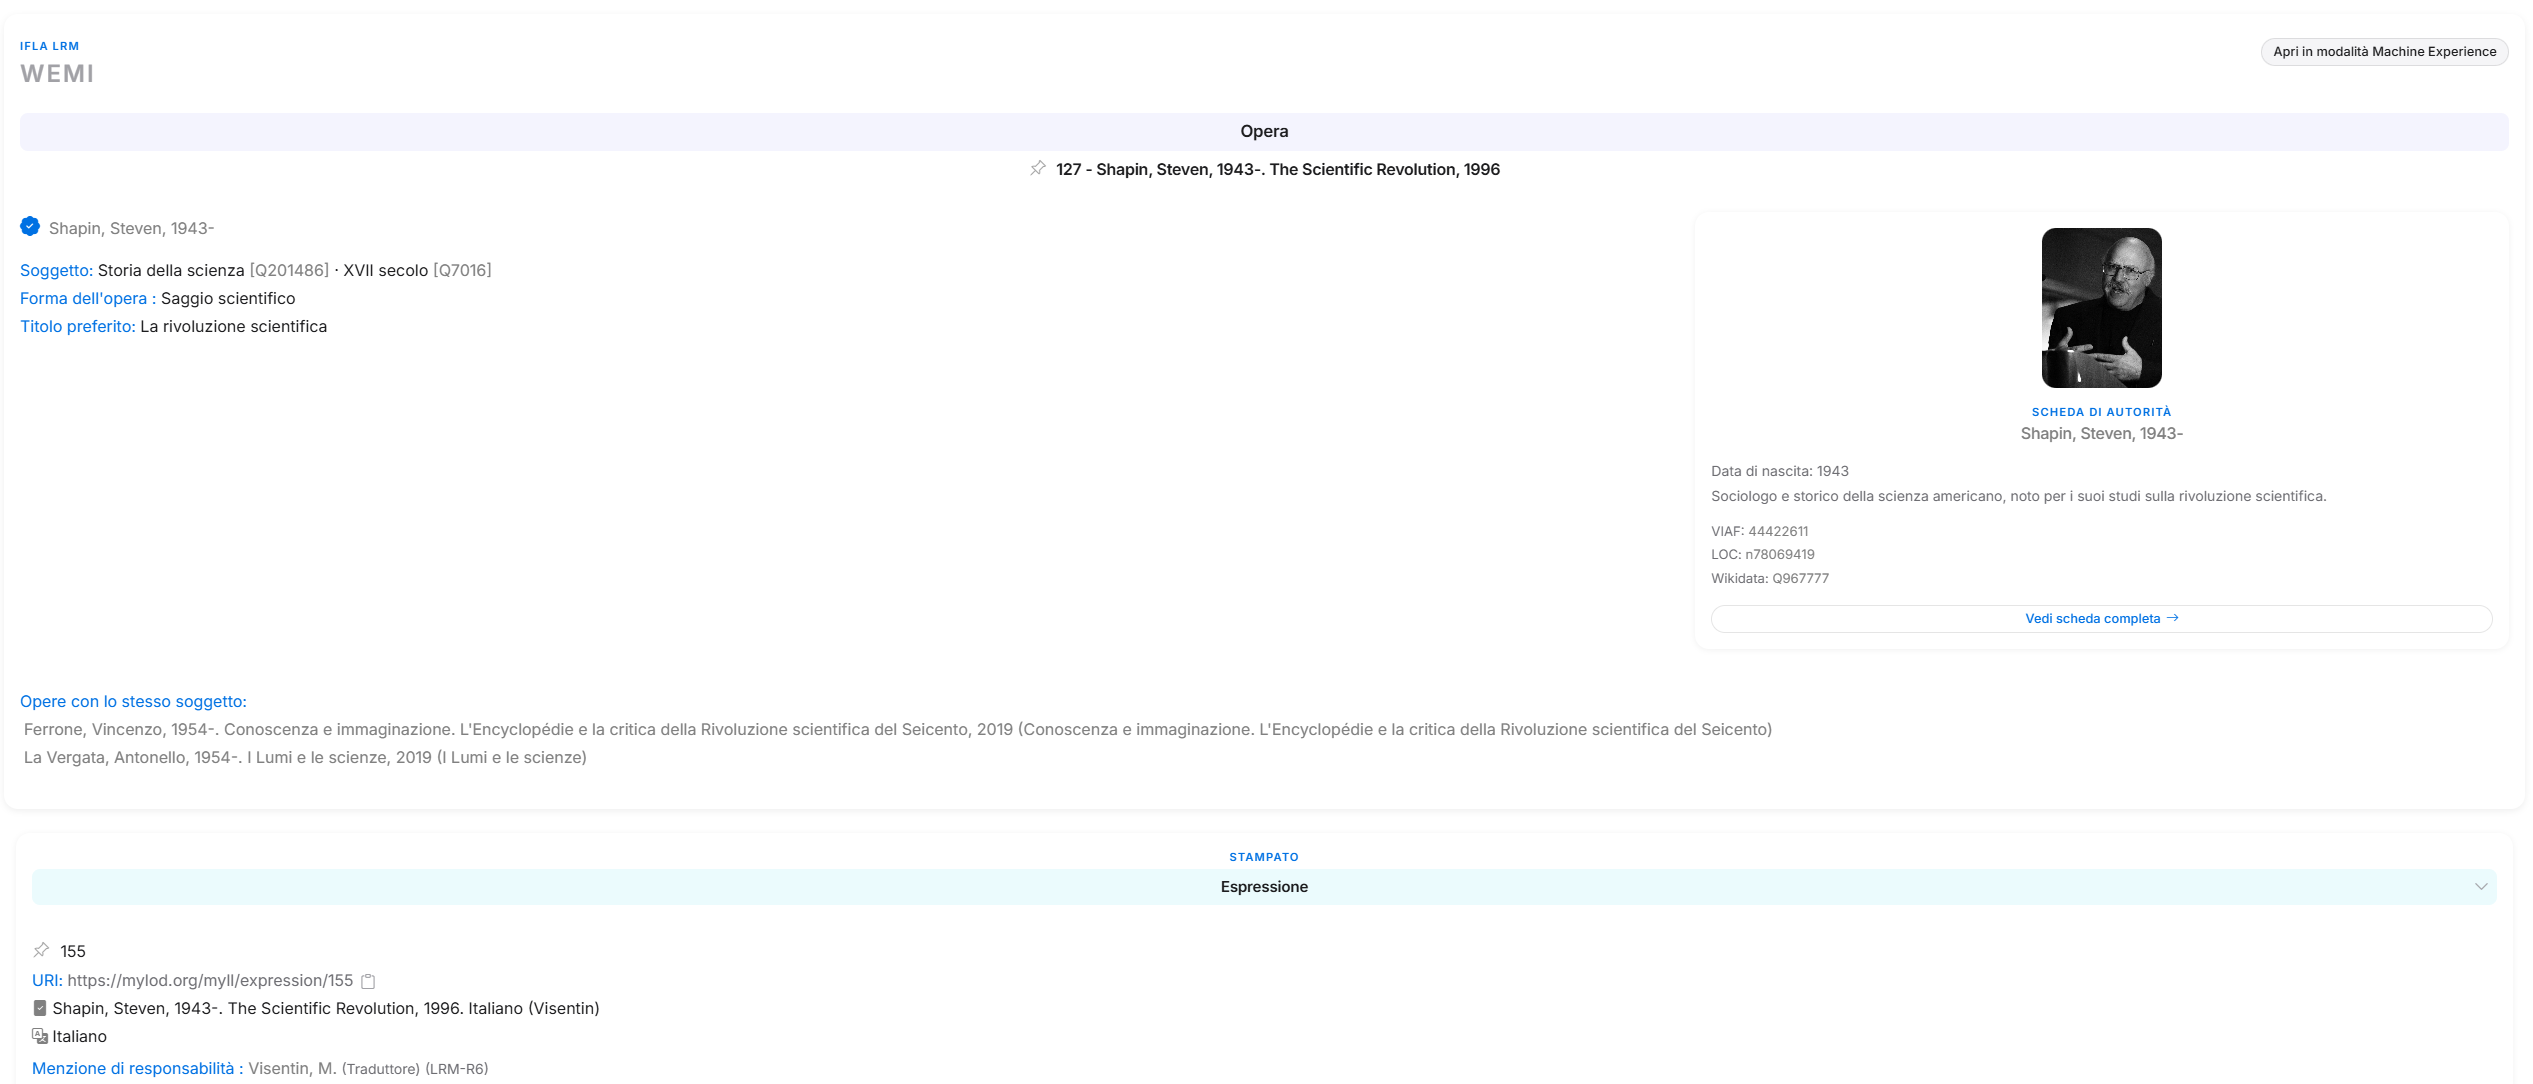
Die Kaskade Werk → Expression → Manifestation, mit dem Normdatensatz des Akteurs daneben
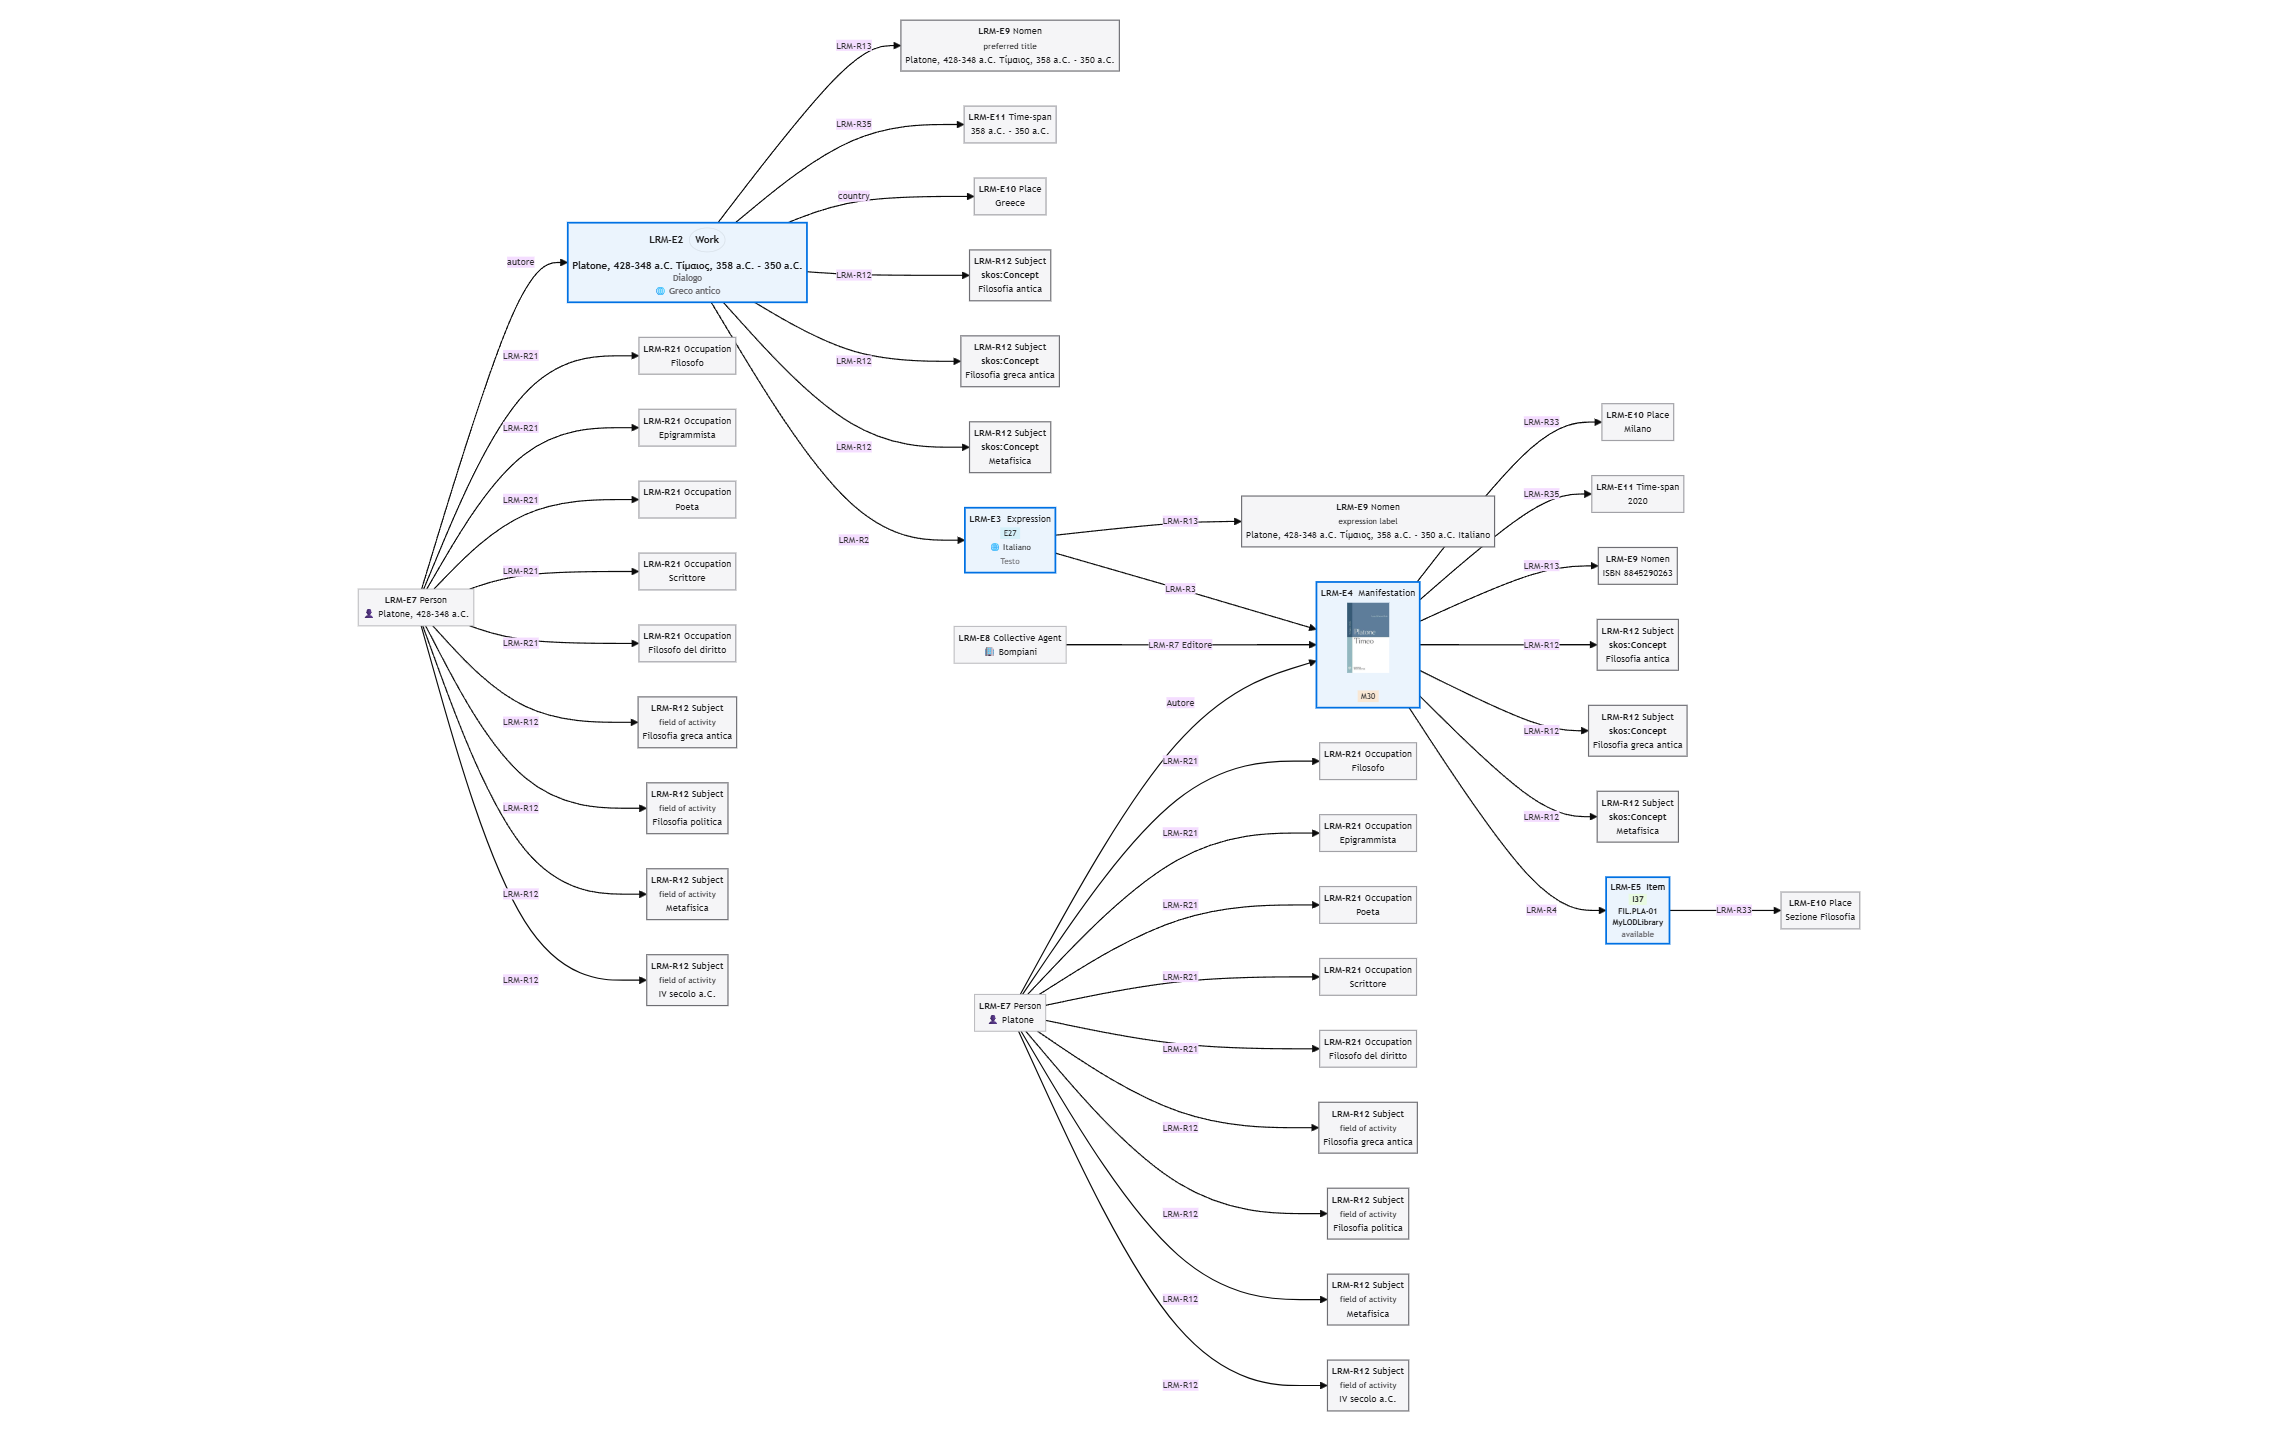
Der Graph der LRM-Beziehungen, automatisch für jedes Werk erzeugt
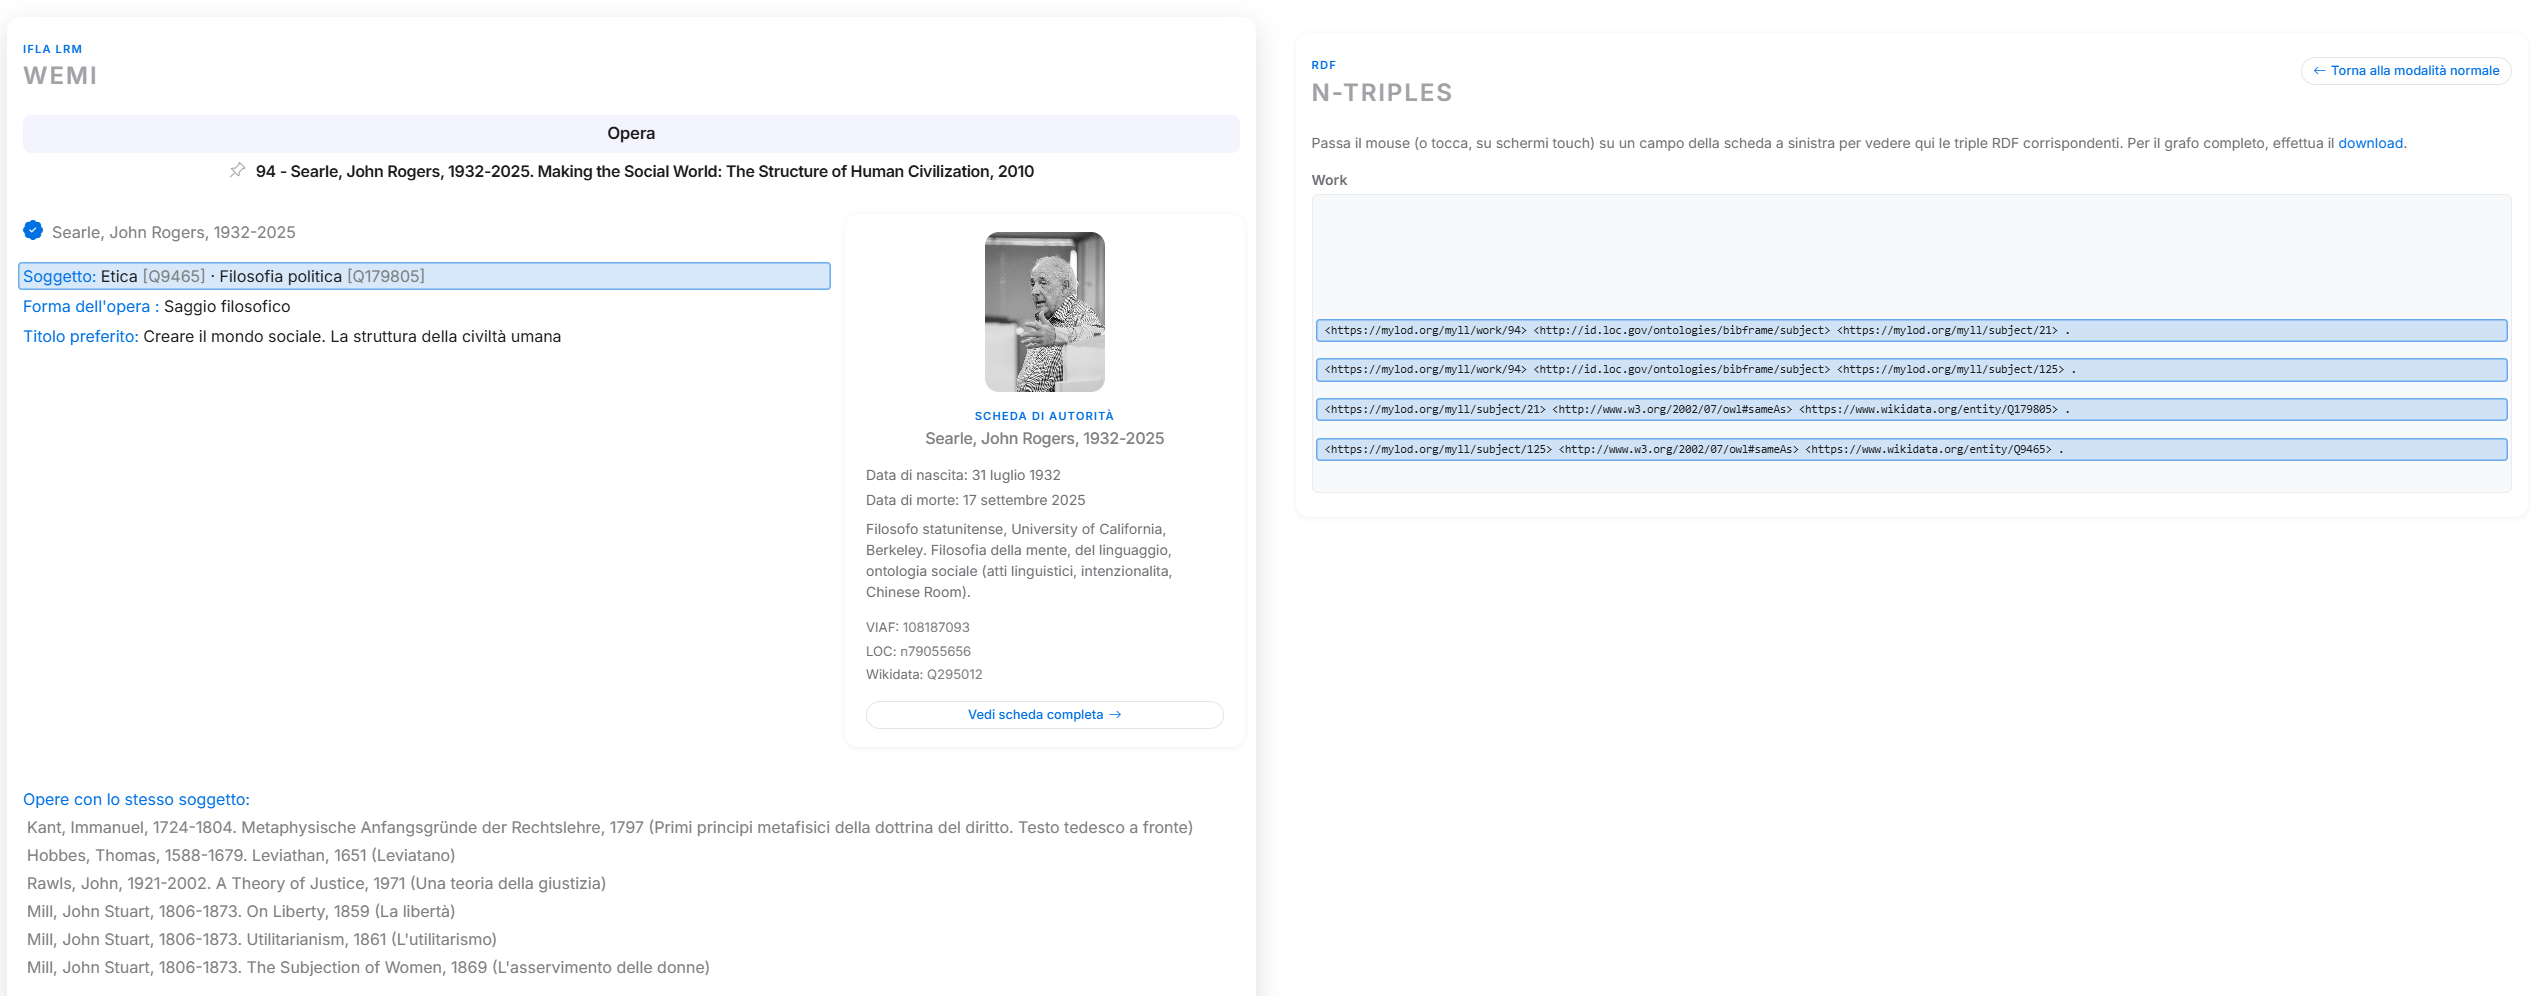
Natürliche Sprache und Maschinensprache nebeneinander erleben, beim Erkunden deiner RDF-Tripel
Akteure, Orte und Themen als Entitäten
Autoren, Körperschaften, Orte, Themen, Berufe und Einheitstitel erscheinen im Katalog nicht als in jedem Datensatz wiederholte Zeichenketten, sondern als eigenständige Normdaten-Entitäten: einmal beschrieben, mit einem eigenen persistenten Identifikator versehen und überall dort per Verweis aufgerufen, wo sie vorkommen. Es ist das Prinzip der Normdatenkontrolle, hier systematisch auf alle im Modell vorgesehenen Entitätsklassen angewandt.
Daraus ergeben sich konkrete Folgen. Eine Korrektur an der Namensform eines Autors wirkt sich sofort auf jedes Werk aus, das darauf verweist, ohne dass wiederholte Eingriffe nötig wären; Namensvarianten, Pseudonyme und Formen in unterschiedlichen Schriften laufen auf derselben Entität zusammen und stellen sicher, dass eine Suche über eine beliebige von ihnen dennoch zum selben Ergebnis führt.
Jeder Normdatensatz vereint die bevorzugte Namensform, die erfassten Varianten, eine biographische oder beschreibende Anmerkung und — entscheidend für die Interoperabilität — die Verknüpfungen zu den Identifikatoren der wichtigsten internationalen Agenturen: VIAF, Library of Congress, ISNI, Bibliothèque nationale de France, SBN und Wikidata, um nur einige zu nennen. Durch diese Abgleiche hört die Entität auf, ein lokales Datum zu sein, und fügt sich in das weltweite Netz der bibliographischen Normdaten ein, in dem biographische und geographische Angaben automatisch aus den verknüpften Quellen angereichert werden können.
Jede Beschreibung lässt sich schließlich in den wichtigsten RDF-Formaten exportieren — Turtle, JSON-LD, N-Triples, RDF/XML, N-Quads — oder unmittelbar in einer Graph-Abfrageumgebung erkunden.
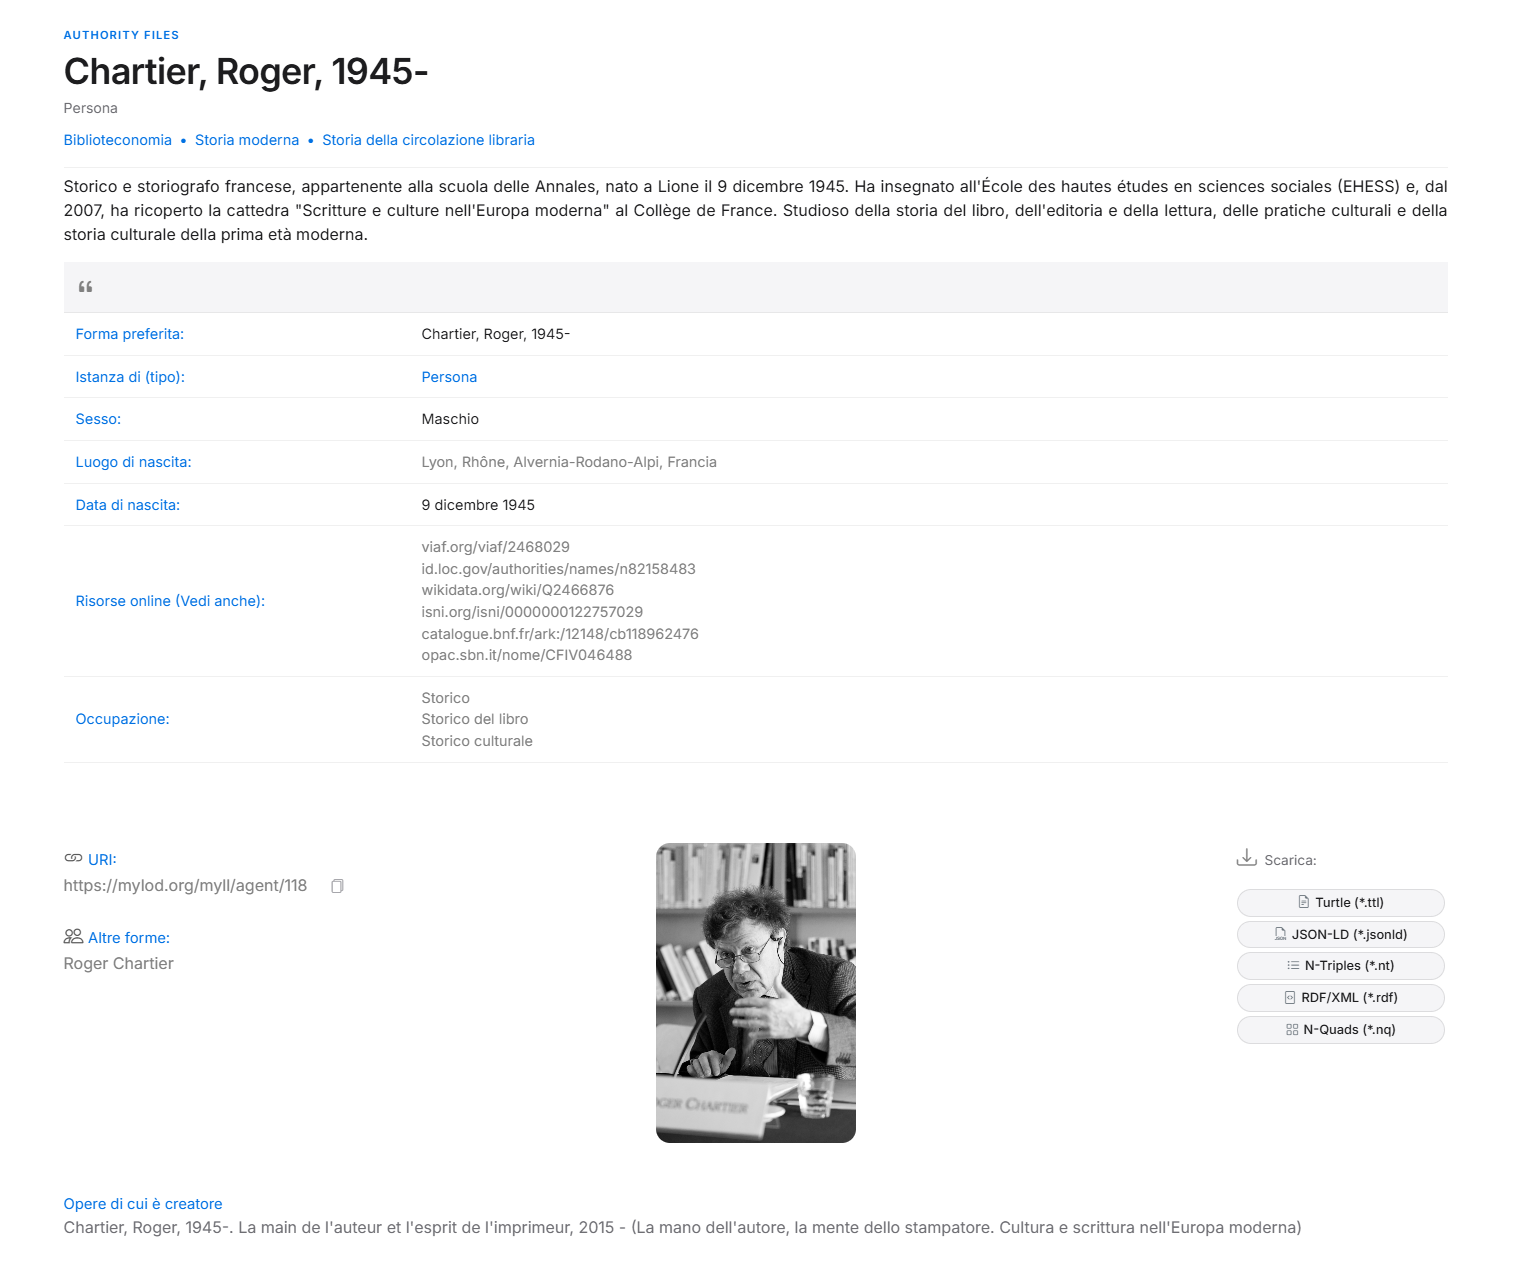
Normdatensatz mit RDF-Export, automatisch aus Wikidata angereichert
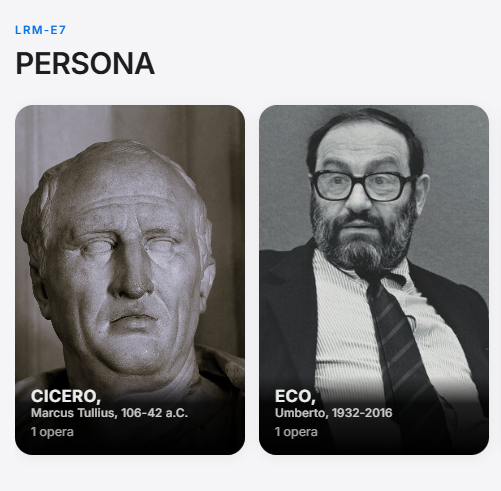
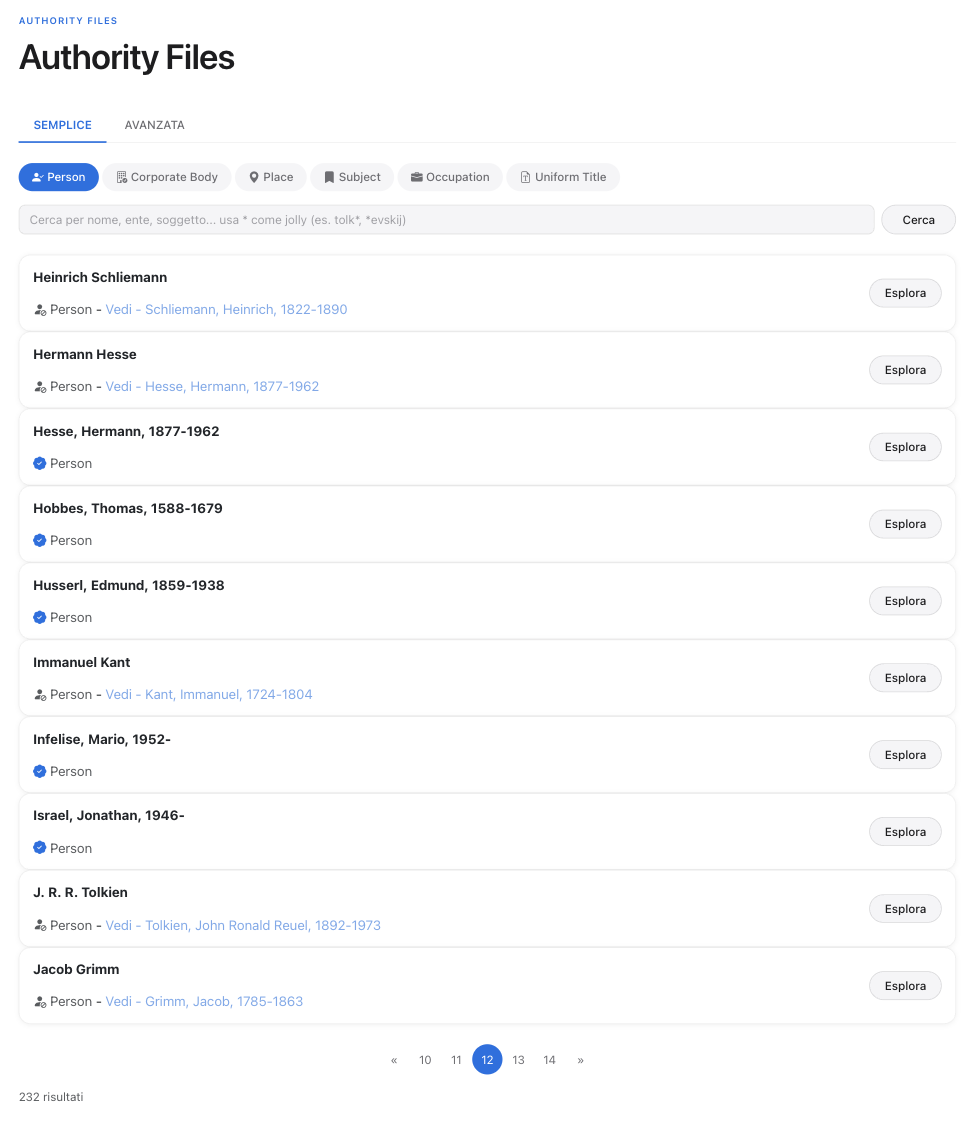
Personen als eigenständige Entitäten und die gesonderte Suche nach Entitätstyp
Ein abfragbarer Datengraph
Jede im Katalog beschriebene Entität — Werke, Expressionen, Manifestationen, Exemplare, Akteure, Orte, Themen und Zeiträume — wird zugleich als Menge von RDF-Tripeln veröffentlicht, der elementaren Einheit des semantischen Webs, die jeweils aus einem Subjekt, einem Prädikat und einem Objekt bestehen. Die verwendeten Eigenschaften werden nicht lokal definiert, sondern aus den von der internationalen Gemeinschaft übernommenen Standardvokabularen geschöpft: BIBFRAME, FOAF und viele weitere.
Diese Struktur ist es, die den Daten erlaubt, die Grenzen der Anwendung zu verlassen. Ein externes System, das diese Vokabulare kennt, kann die Beschreibungen von MYLODLibrary ohne jede vorherige Absprache interpretieren, ebenso wie der Katalog sich seinerseits über gemeinsame Identifikatoren an externe Ressourcen anschließen kann. Das Ergebnis ist kein geschlossenes Archiv, sondern ein Knoten innerhalb eines größeren dokumentarischen Netzes. Die Umwandlung der Daten vom MARC21-Format nach RDF (über verschiedene Stufen der Erzeugung sowie des verfügbaren Datenformats, etwa MARCXML) ist darauf ausgelegt, dem Katalogisierenden die Möglichkeit zu geben, die Semantik der RDF-Daten zu erlernen, ohne das MARC21-Format zu verlassen. Möglich wird dies durch die parallele Koexistenz zweier Datenbanken: der relationalen, auf der MARC21 arbeitet, und der offenen, die für die Aufnahme von für das semantische Web veröffentlichten Daten gebaut ist.
Der gesamte Graph aus Tripeln ist öffentlich mit SPARQL abfragbar, der nativen Sprache zur Erkundung von RDF-Daten, über einen Endpunkt mit reinem Lesezugriff. Um die Einstiegshürde zu senken und die Suche zu erleichtern, bietet die Oberfläche eine Sammlung fertiger Abfragen — die Verteilung der Sprachen, die in einem bestimmten Jahrhundert tätigen Autoren, die häufigsten Themen —, die sich sofort ausführen und anschließend abwandeln lassen: eine Möglichkeit, die Sprache durch Beobachtung ihrer Wirkung zu erlernen, ganz ohne Vorkenntnisse.
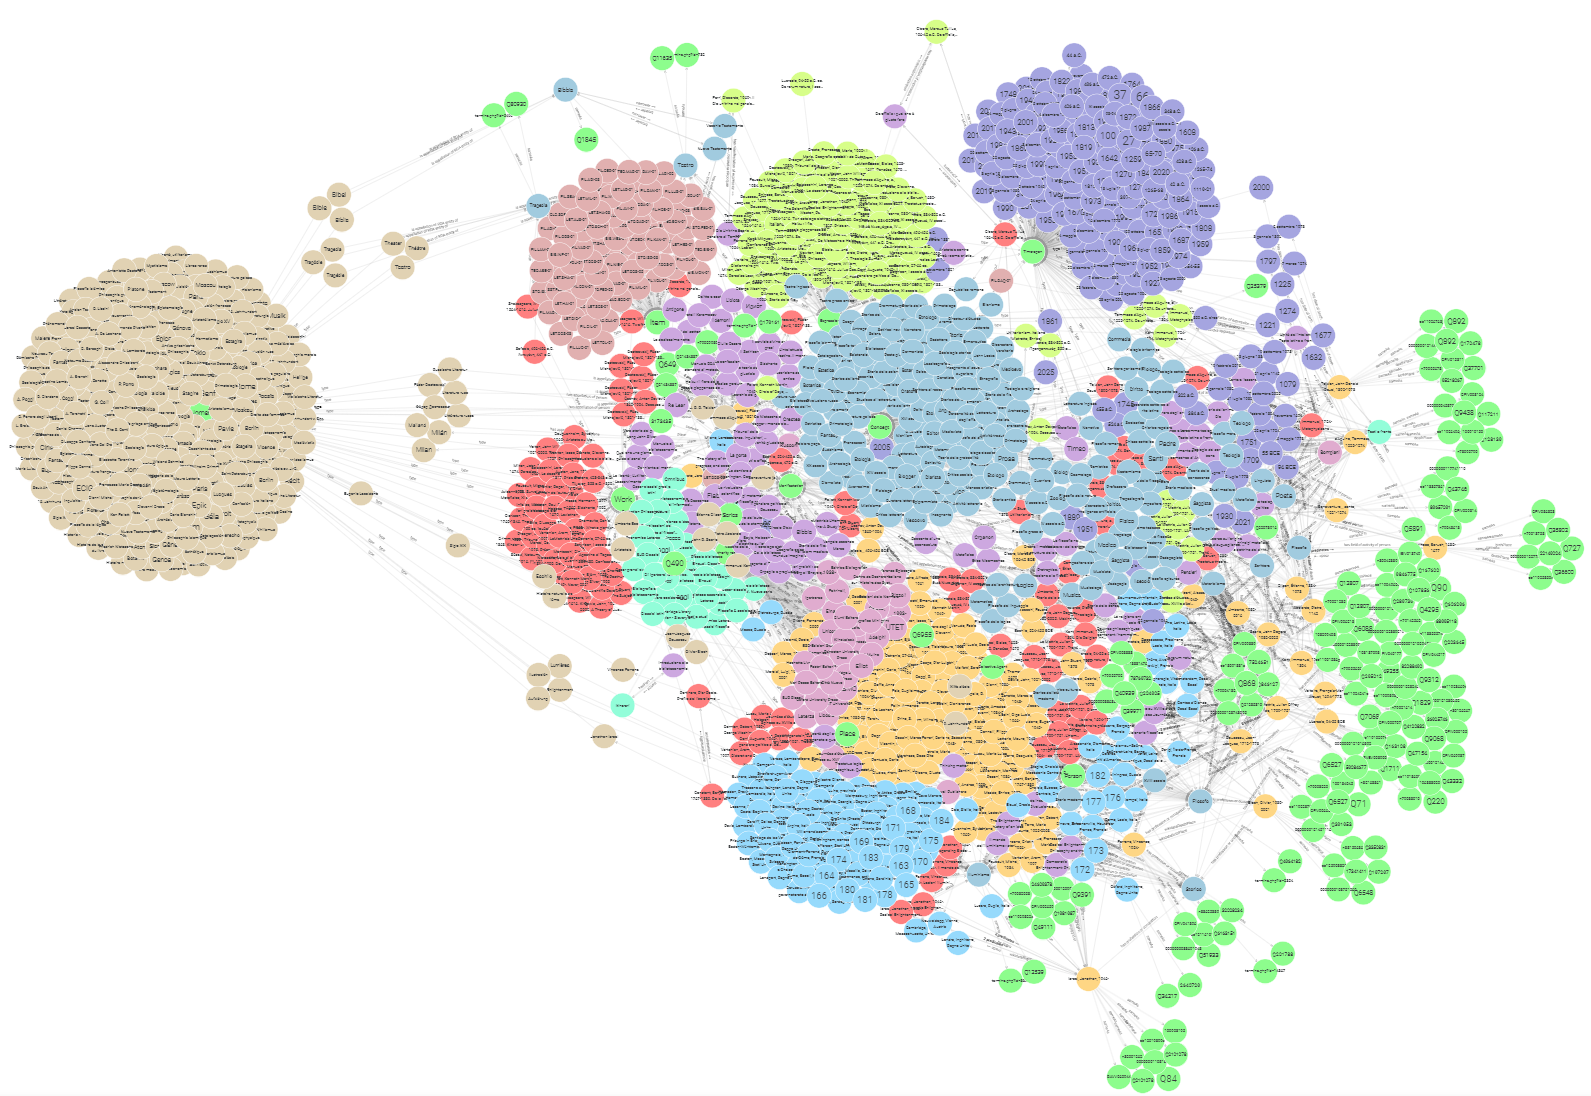
Ein Ausschnitt des RDF-Graphen des Katalogs: jeder Knoten eine Entität, jede Kante eine Beziehung
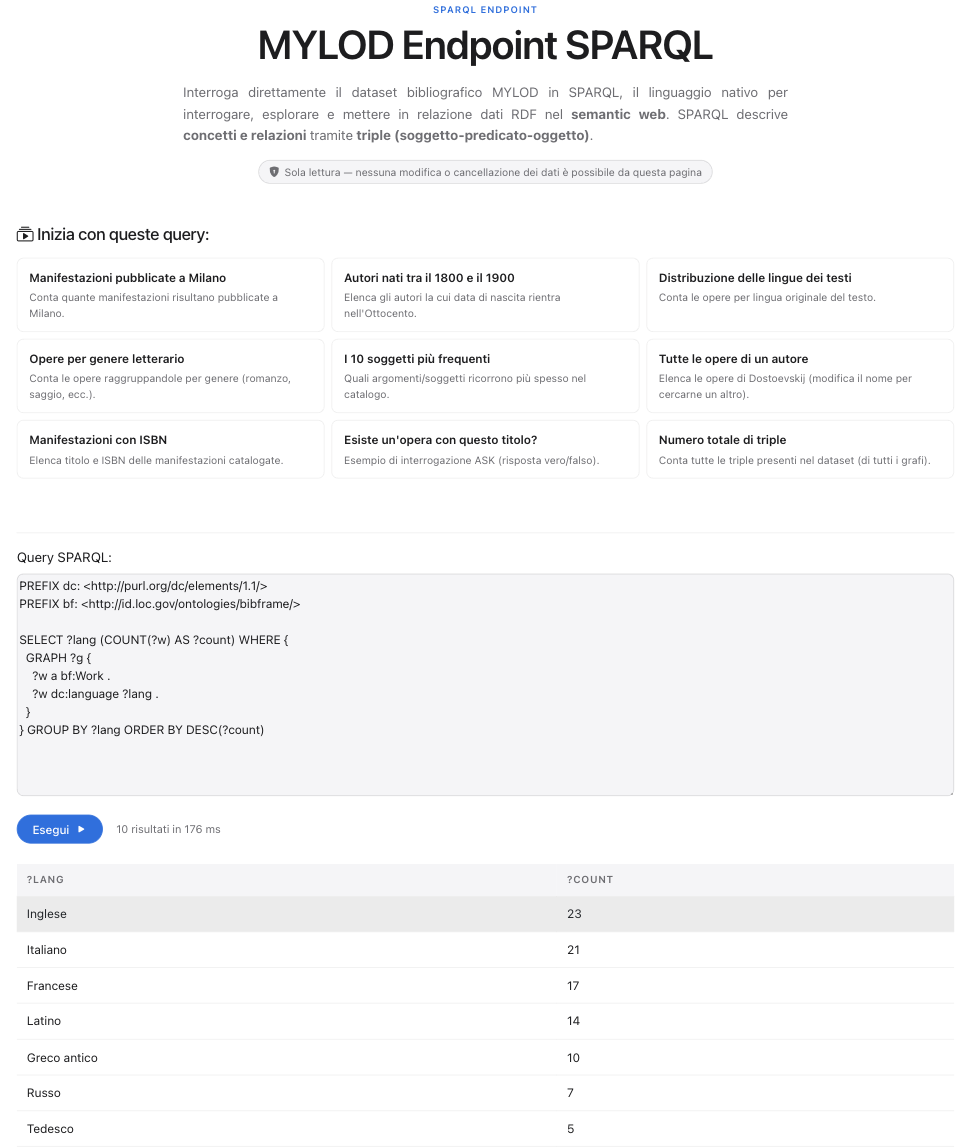
Der öffentliche SPARQL-Endpunkt, mit gebrauchsfertigen Beispielabfragen
MARC21, natives RDF und Ihr persönlicher Bereich
Auf der Seite der Datenerzeugung beschreitet MYLODLibrary zwei parallele Wege, statt einen einzigen vorzuschreiben. Der erste geht vom traditionellen bibliothekarischen Format aus: Man erfasst einen MARC21-Datensatz nach etablierter Praxis, und ein automatisches Verfahren leitet daraus Feld für Feld die entsprechenden LRM-Entitäten ab, erzeugt die Kette Werk-Expression-Manifestation-Exemplar und die zugehörigen Normdatenverknüpfungen. Der zweite ermöglicht die direkte native Katalogisierung nach den Modellen RDA und IFLA LRM über eine Reihe von Formularen für jede Entität des Modells.
Die beiden Wege sind keine Alternativen zueinander, sondern Antworten auf unterschiedliche Bedürfnisse: der erste bewahrt die Ausbildungsinvestitionen und Arbeitsabläufe derer, die bereits mit MARC21 arbeiten, der zweite erlaubt es, die Ausdruckskraft des LRM-Modells ohne die Zwänge eines in einer anderen technologischen Epoche entstandenen Formats zu nutzen. Beide laufen im selben Katalog und im selben RDF-Graphen zusammen. Das bedeutet, dass jede Entität den Katalogisierungsanforderungen unabhängig vom gewählten Format gerecht wird. Ob man natives RDF erzeugt oder von MARC21 ausgeht, gelangt man in jedem Fall zur kaskadenartigen Veröffentlichung des WEMI-Systems.
Jedem registrierten Benutzer ist zudem ein persönlicher Katalogisierungsbereich vorbehalten — ein Labor, in dem man üben und eigene Beschreibungen aufbauen kann, von Grund auf oder ausgehend von einem bereits ausgefüllten Beispieldatensatz. Die in diesem Bereich bearbeiteten Daten bleiben streng privat: Sie erscheinen nicht im öffentlichen Katalog, sind für andere Benutzer nicht sichtbar und gelangen nicht in den abfragbaren Graphen. Das ist eine wesentliche Voraussetzung dafür, dass das Werkzeug auch in Lehrkontexten eingesetzt werden kann, in denen der Fehler — und gegebenenfalls das Melden von Wartungsarbeiten an der Plattform — Teil des Wegs von Wachstum und Lernen ist.
Der persönliche Arbeitsbereich ist jedoch kein vom übrigen Katalog abgeschottetes Fach: Wer katalogisiert, kann bereits öffentliche Normdatensätze — eine Person, einen Ort, ein Thema, einen Beruf — frei wiederverwenden, genau wie ein erfahrener Katalogisierer, um unnötige Duplikate zu vermeiden. Expressionen, Manifestationen und Exemplare bleiben dagegen stets eigene, eigenständige Entitäten: Selbst wenn sie ein bereits im allgemeinen Katalog vorhandenes Werk beschreiben, werden sie niemals mit bestehenden Datensätzen zusammengeführt oder überlagert. Diese Unterscheidung ist bewusst gewählt: Normdaten sind gemeinsames Gut, die detaillierte bibliografische Beschreibung bleibt persönlich.
Das Beschreibungsmodell beschränkt sich nicht auf das gedruckte Buch: Handschriften und alte Drucke verfügen über eigene Abschnitte — Beschreibstoff, Lagenstruktur, Schrift, Einband, Type, Druckermarke — und für Handschriften über ein TEI/XML-Transkriptionsmodul, das automatisch aus den bereits erfassten Metadaten erzeugt oder aus einer anderswo erstellten Datei importiert und nach dem offiziellen TEI-Schema validiert werden kann. Abgerundet wird das Bild dadurch, dass jede Manifestation eine eigene digitale Kopie enthalten kann — ein direkt auf der Plattform hochgeladenes PDF, das ohne externe Software vom öffentlichen Datensatz aus angesehen werden kann.
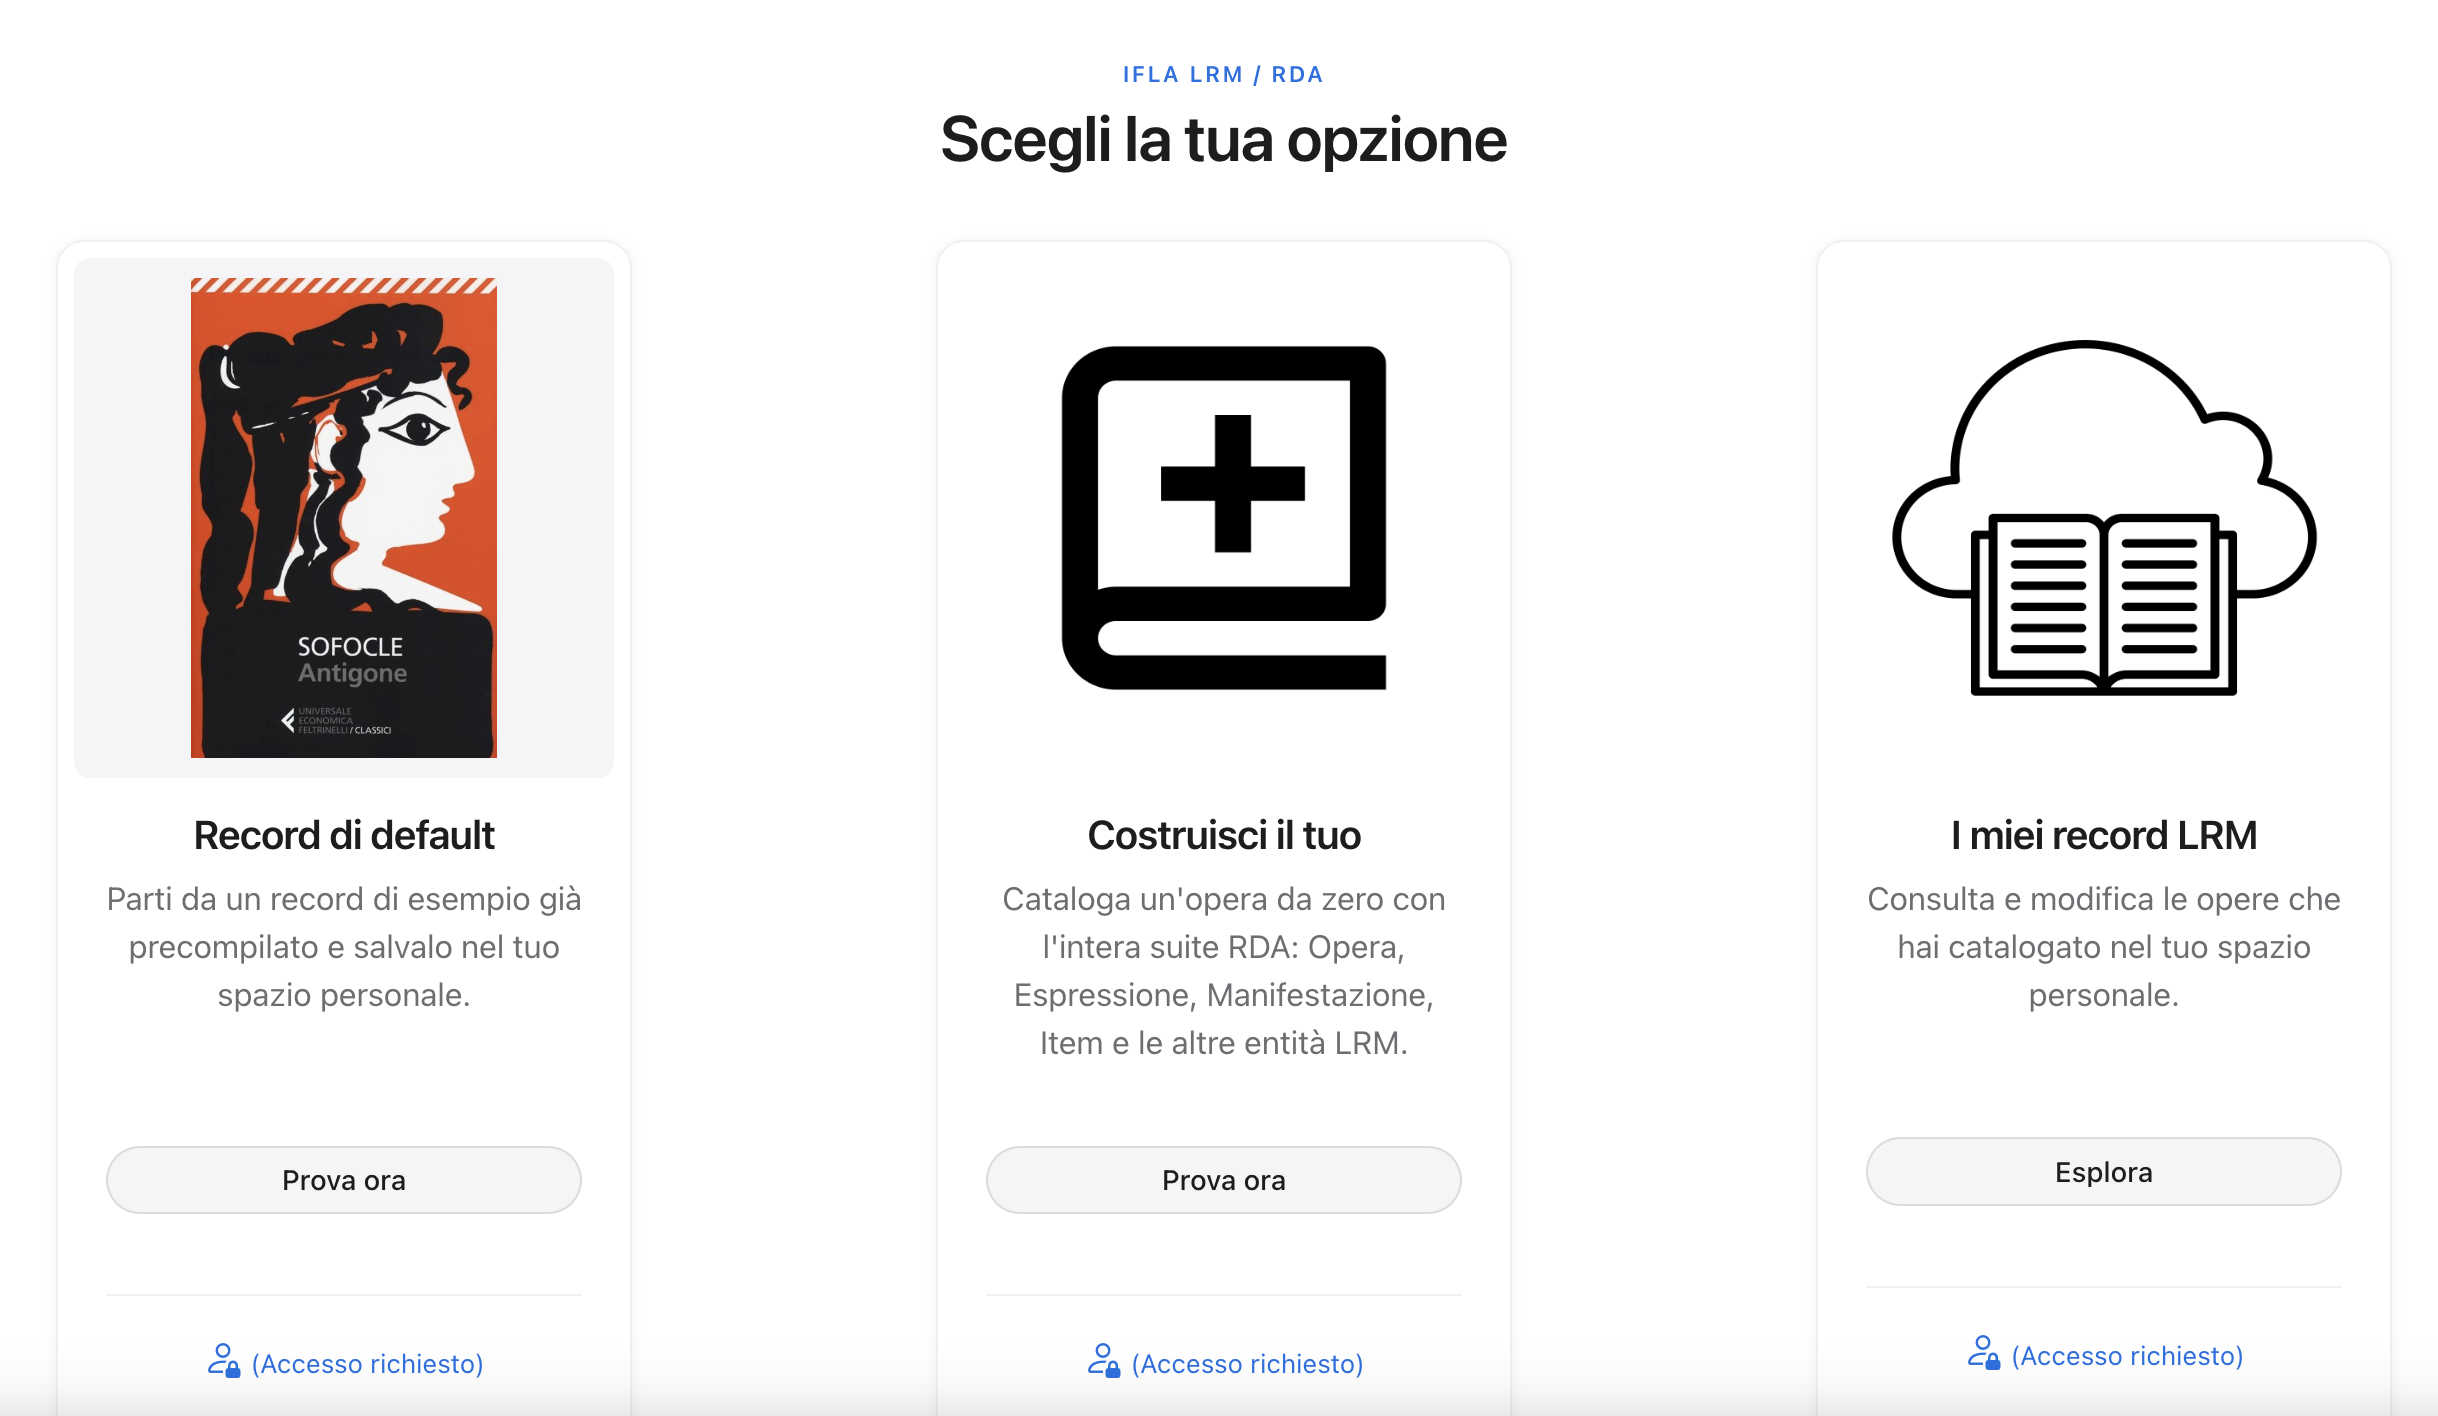
Der Hub für native IFLA-LRM/RDA-Katalogisierung, mit dem persönlichen Bereich des Katalogisierenden
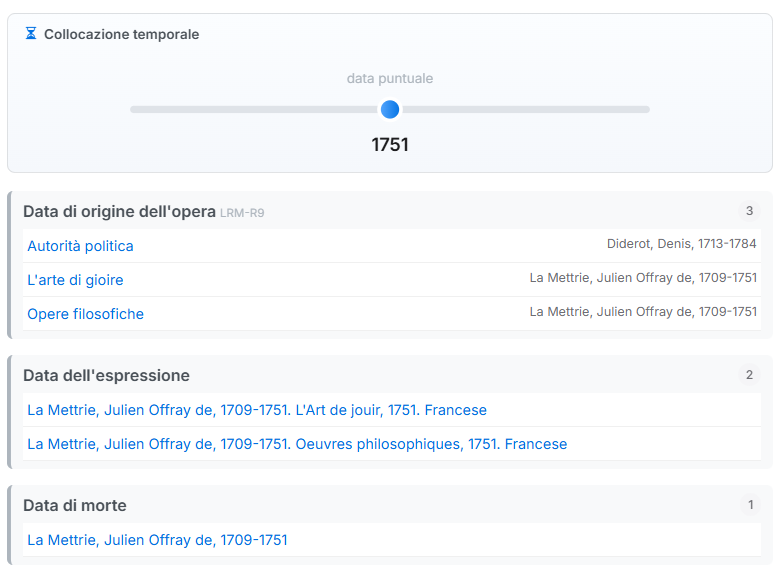
Die Beziehungen zwischen Ressourcen über die Entität Zeitspanne erkunden