MYLODLibrary è un catalogo bibliografico che descrive risorse non come record isolati e autosufficienti, ma come una rete di entità poste in relazione tra loro secondo la logica dei Linked Open Data, il modello concettuale IFLA LRM e lo standard di catalogazione RDA.
Il presupposto è che un catalogo non debba limitarsi ad attestare l'esistenza di un documento, ma debba rendere esplicite le relazioni che lo attraversano: il legame tra un'opera e le sue traduzioni, tra un'edizione e l'esemplare conservato, tra un autore e l'insieme dei suoi scritti, tra un testo e i temi che affronta e molto altro ancora. Una descrizione bibliografica tradizionale enuncia questi rapporti in forma discorsiva e chiusa, comprensibile al lettore umano ma opaca a qualunque elaborazione automatica; qui invece sono codificati in una struttura formale e perciò interrogabili, verificabili e riutilizzabili da sistemi terzi.
Il progetto integra due percorsi di catalogazione — il formato bibliotecario tradizionale, il MARC21, e la descrizione nativa in IFLA LRM — che convergono nel medesimo catalogo pubblico e alimentano un unico grafo di dati RDF, liberamente interrogabile anche attraverso un endpoint SPARQL. Le sezioni che seguono ne ripercorrono le componenti principali, dall'interfaccia di consultazione fino agli strumenti di produzione e pubblicazione dei dati.
Nota per i lettori: le risorse contenute nel catalogo MYLODLibrary appartengono a una collezione libraria privata e personale, in costante aggiornamento, pubblicata con lo scopo di essere messa a disposizione per lo studio e l'evoluzione del progetto. Per questo motivo è importante segnalare che, a livello di descrizione dell'Item, i dati hanno il solo obiettivo di validare le ricerche e la produzione MYLOD e di fornire strumenti di studio per il data entry e la costruzione dei Linked Open Data.
Cerca ed esplora
Il catalogo generale è la porta d'accesso al patrimonio descritto in MYLODLibrary e ne costituisce il punto di osservazione privilegiato per chi consulta. L'interrogazione può avvenire in forma semplice — per titolo, autore o soggetto, con il supporto di caratteri jolly per le ricerche parziali — oppure in forma avanzata, combinando più criteri attraverso operatori booleani (AND, OR, NOT) che consentono di circoscrivere progressivamente l'insieme dei risultati fino a isolare esattamente ciò che interessa.
L'interfaccia di consultazione contiene una restituzione analitica del contesto: accanto all'elenco dei risultati, un pannello di statistiche calcolate dinamicamente descrive la porzione di catalogo che si sta consultando, articolandola per lingua del testo, luogo e data di pubblicazione, agenti e così via. La possibilità di filtrare i risultati per modalità di registrazione darà agli utenti una panoramica di quanto è stato pubblicato in formato nativo RDF o, eventualmente, partendo dal MARC21. La ricerca cessa così di essere un semplice recupero di record e diventa uno strumento di analisi: chi consulta non ottiene soltanto un elenco, ma un prospetto quantitativo del sottoinsieme che ha isolato.
Ogni risultato dichiara inoltre la propria provenienza riportando il numero complessivo di triple generate, rendendo immediatamente percepibile la densità informativa che sta dietro alla descrizione. Da qui si accede alla scheda completa dell'opera e a tutti i formati in cui essa è disponibile.
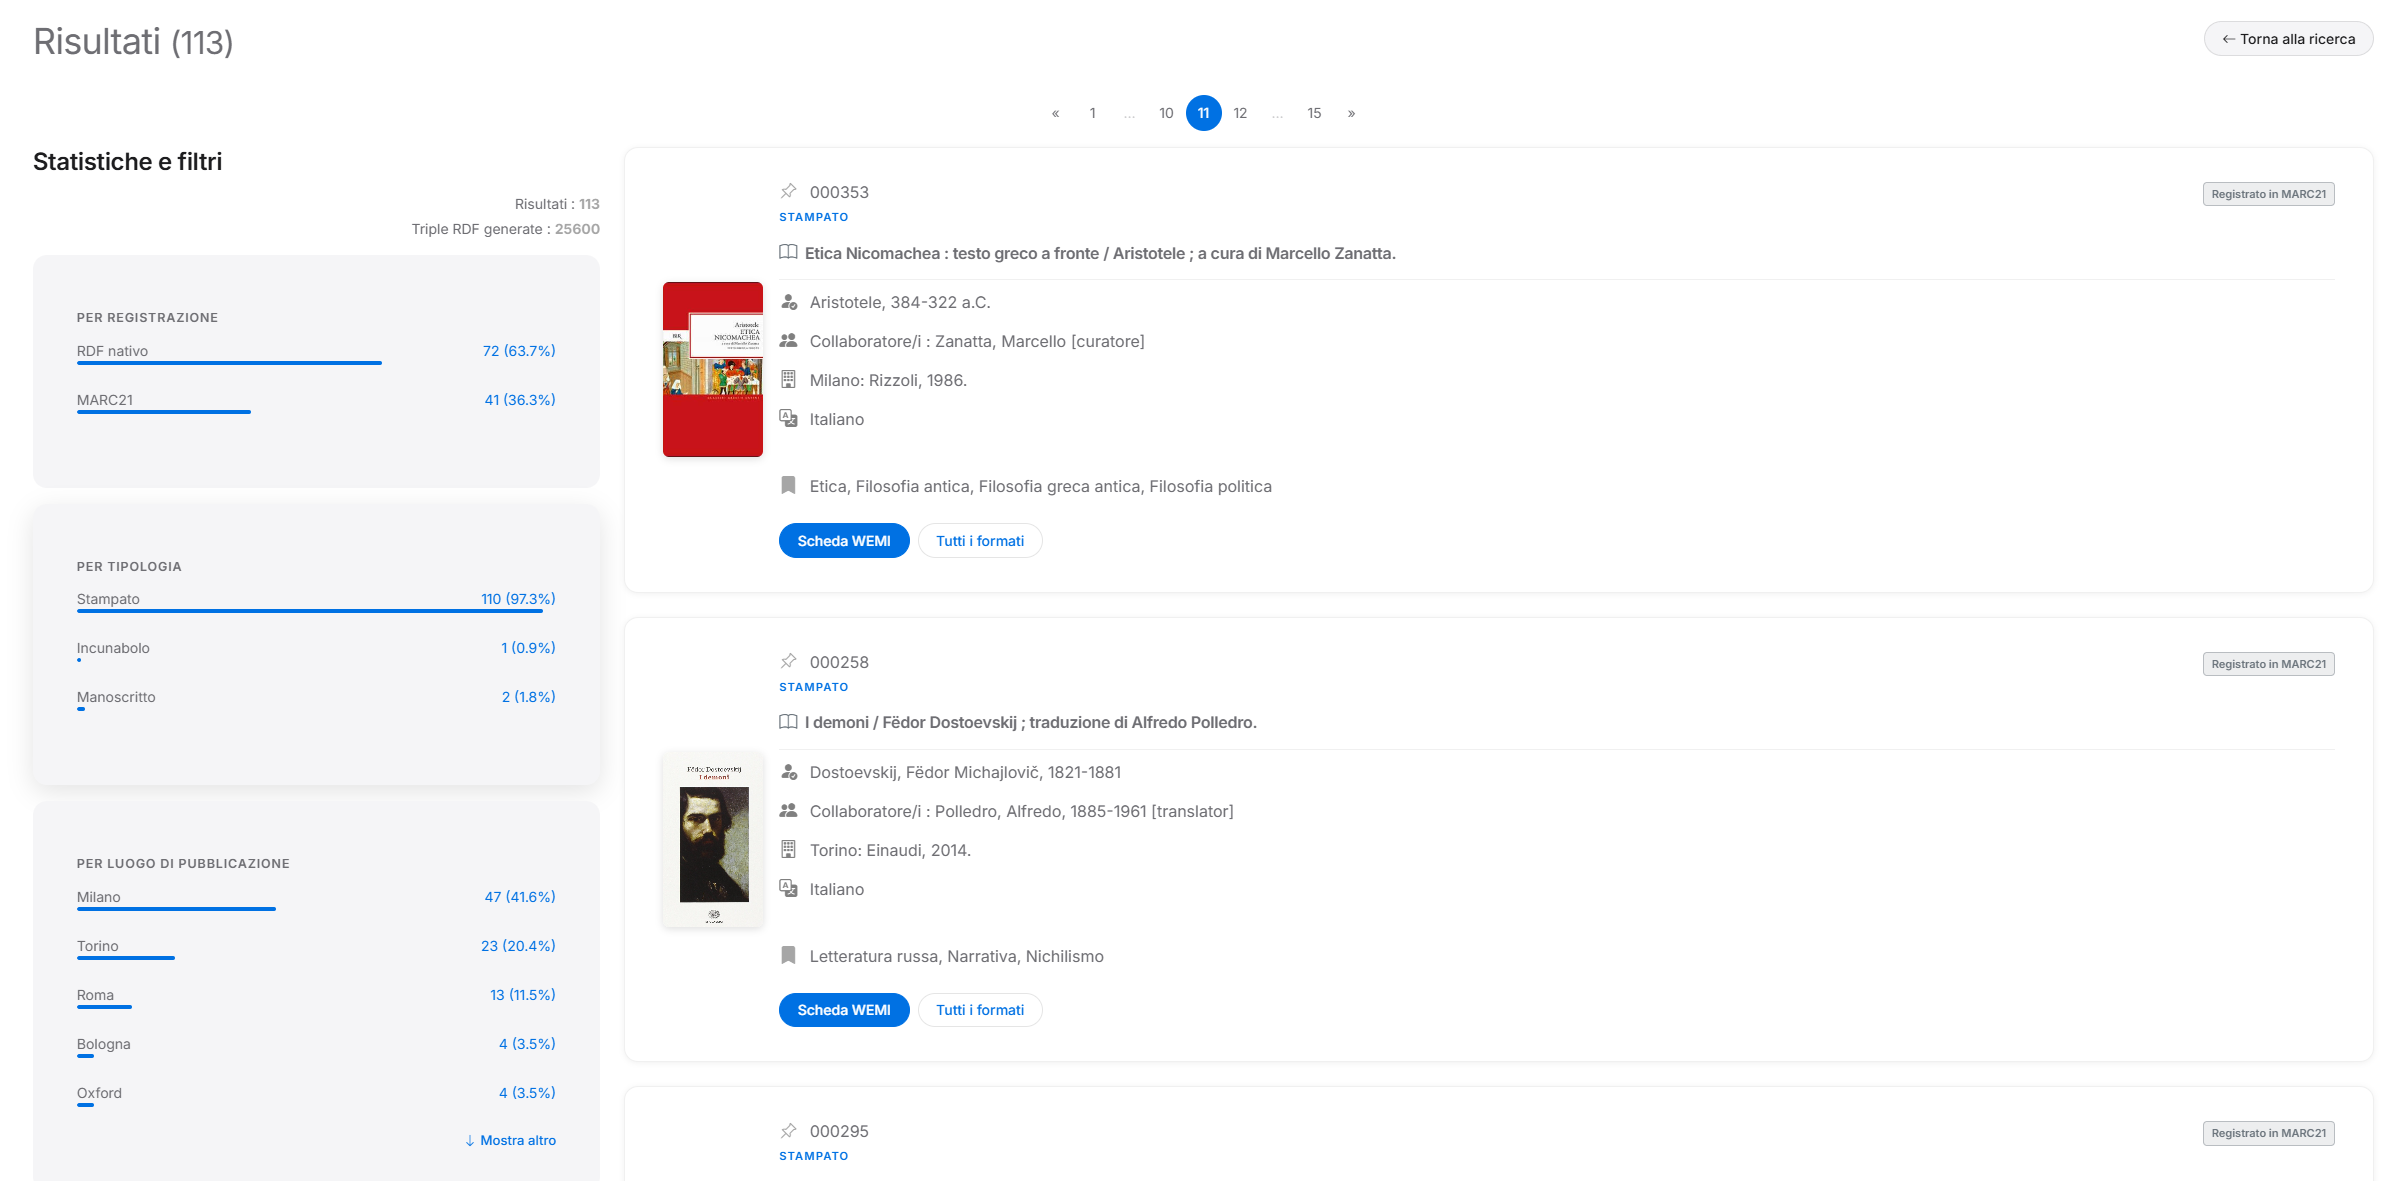
Ricerca nel catalogo generale, con filtri e statistiche in tempo reale
Opera, Espressione, Manifestazione, Item
Al centro dell'impianto concettuale del progetto si colloca il modello IFLA Library Reference Model, il quadro di riferimento con cui la comunità bibliotecaria internazionale ha ripensato la descrizione delle risorse. Il principio è che ciò che comunemente chiamiamo "un libro" non sia in realtà un oggetto unico, ma la sovrapposizione di quattro entità distinte e gerarchicamente collegate.
L'Opera è il contenuto intellettuale nella sua astrazione — la Divina Commedia come creazione dell'ingegno, indipendentemente da come la si legga. L'Espressione ne è una realizzazione concreta: una determinata traduzione, una revisione critica, una versione in una data lingua. La Manifestazione corrisponde all'edizione materialmente prodotta e pubblicata, con il suo editore, il suo anno, il suo ISBN. L'Item, infine, è l'esemplare singolo fisicamente posseduto e collocato su uno scaffale.
Descrivere separatamente questi quattro livelli, anziché comprimerli in un record unico, consente al catalogo di rispondere a interrogativi che una descrizione piatta non è in grado di formulare: quante traduzioni esistono di una data opera, in quali edizioni siano state pubblicate, quali esemplari se ne conservino. Ogni entità è inoltre posta in relazione con gli agenti che l'hanno prodotta, con i soggetti che tratta, con i luoghi e i periodi cui si riferisce.
L'intera trama di queste relazioni è ispezionabile come grafo interattivo, generato automaticamente dalla scheda di ciascun record: uno strumento che rende visibile — e didatticamente leggibile — l'architettura semantica che sostiene la descrizione bibliografica. Tale schema agevola il sistema informatico che produce i dati, poiché permette alla macchina di produrre, gestire e conservare automaticamente tutte le relazioni che il catalogatore è in grado di descrivere, dando così la possibilità agli utenti che consultano il catalogo di muoversi in totale libertà su vari scenari che le risorse inglobano o ai quali possono far approdare, sia interni che esterni al catalogo stesso.
Le stesse logiche relazionali si estendono anche agli agenti tra loro: una persona può essere dichiarata membro di un ente collettivo, un ente collettivo può precedere o succedere a un altro — per fusioni, scissioni, cambi di denominazione — e due agenti possono più genericamente risultare associati. Anche questi legami, modellati sui tipi di relazione previsti da IFLA LRM, vengono pubblicati come triple RDF e resi visibili nella scheda pubblica di ciascun agente.
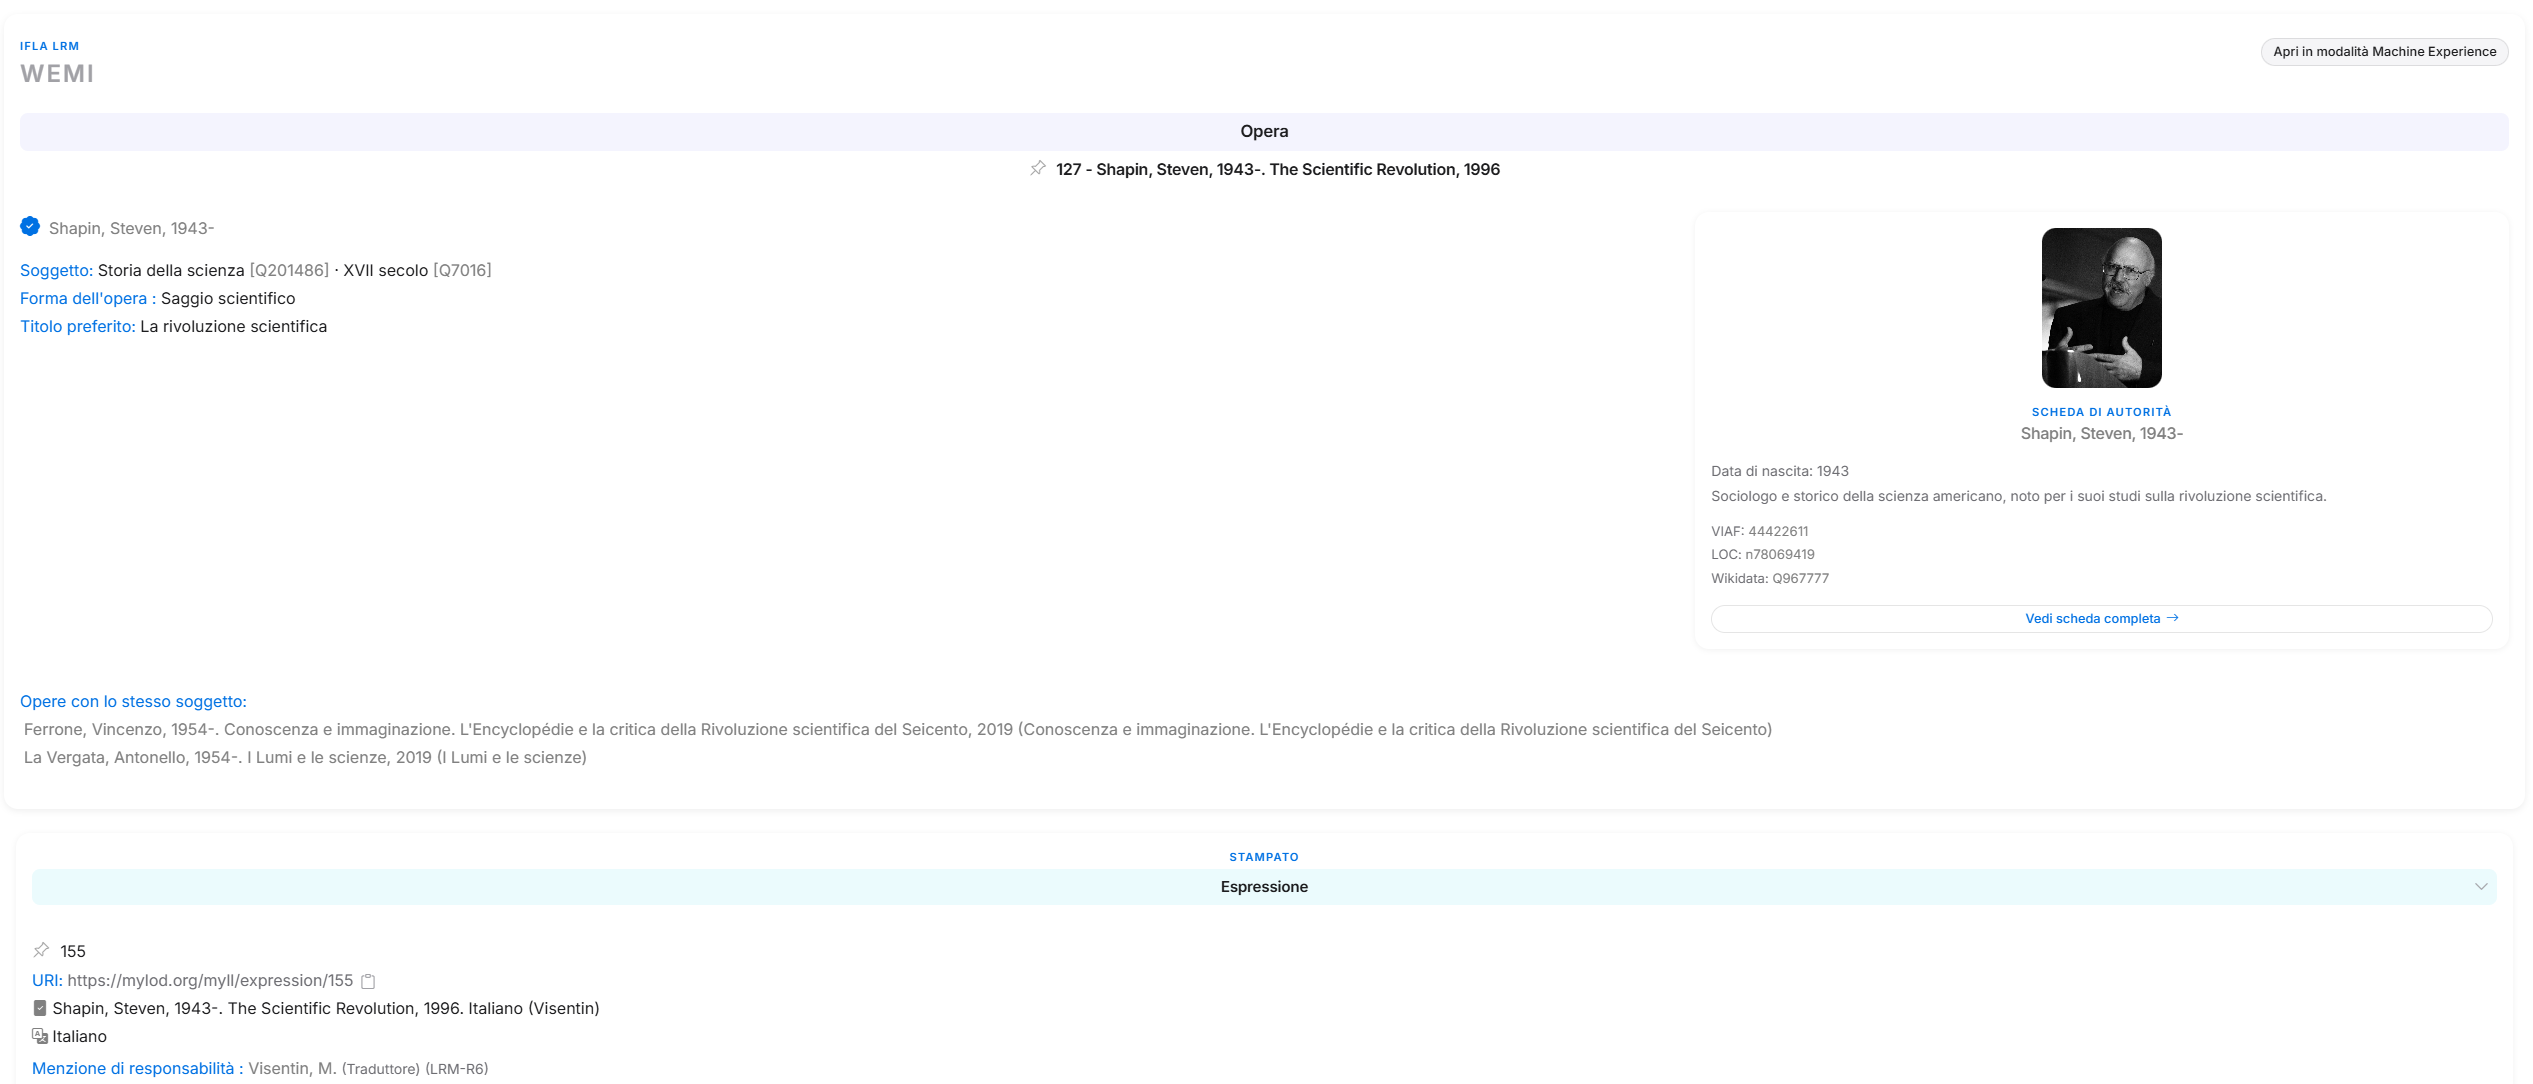
La cascata Opera → Espressione → Manifestazione, con la scheda di autorità dell'agente a lato
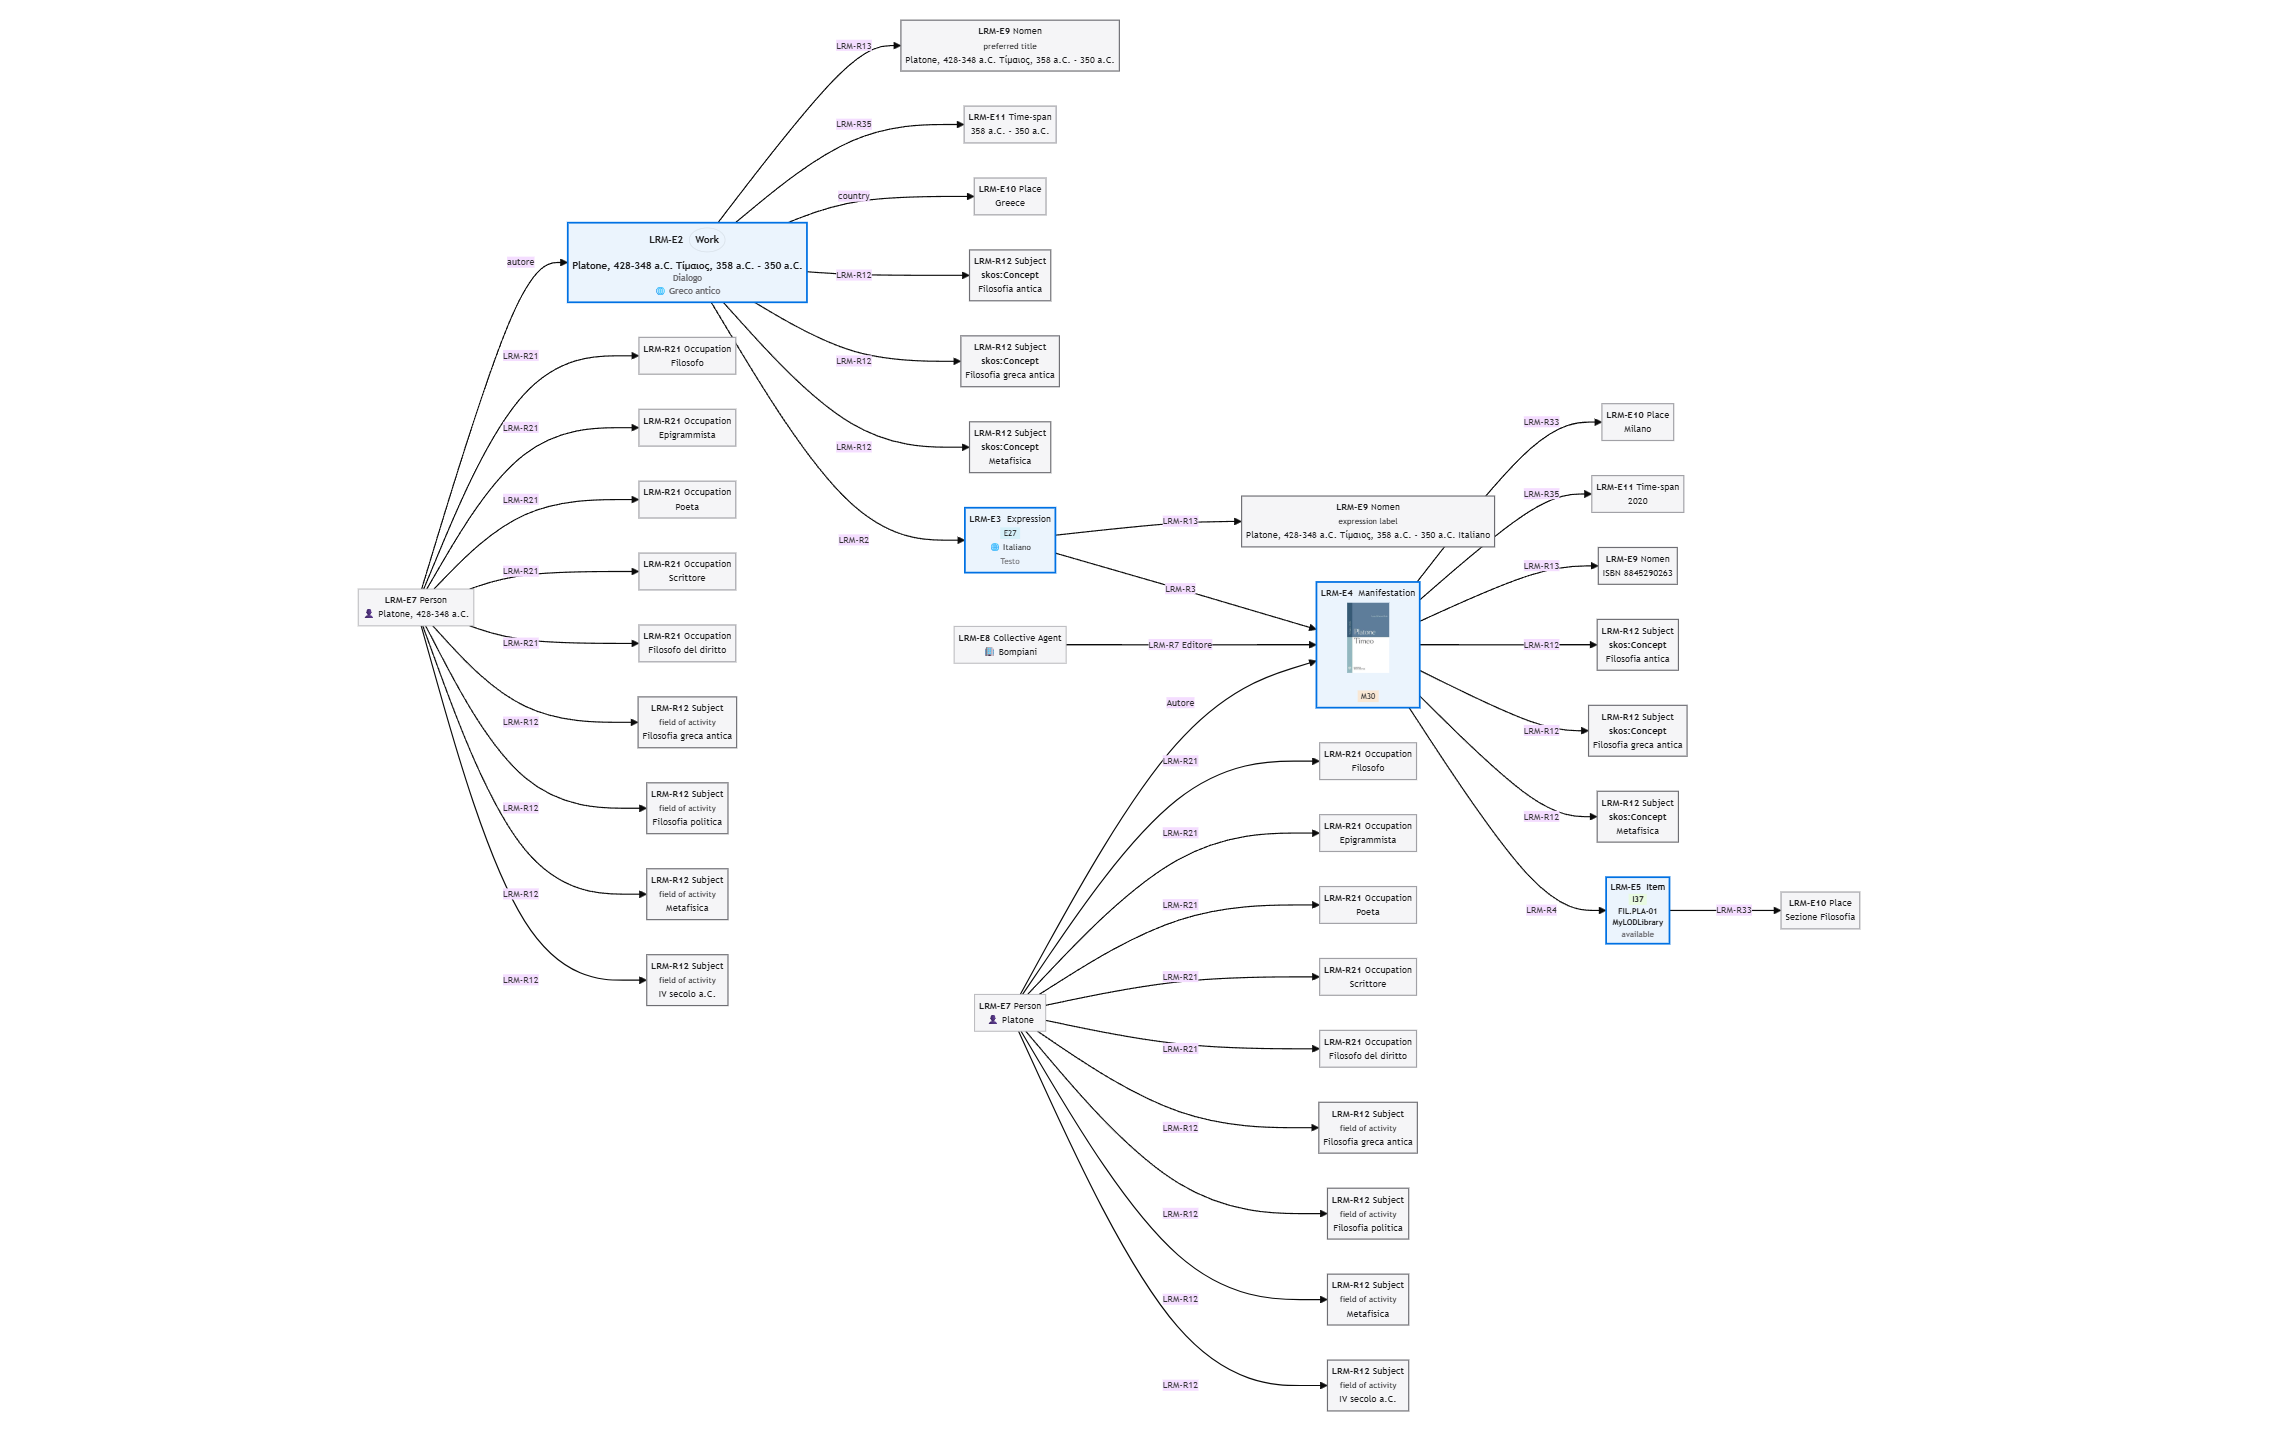
Il grafo delle relazioni LRM, generato automaticamente per ogni opera
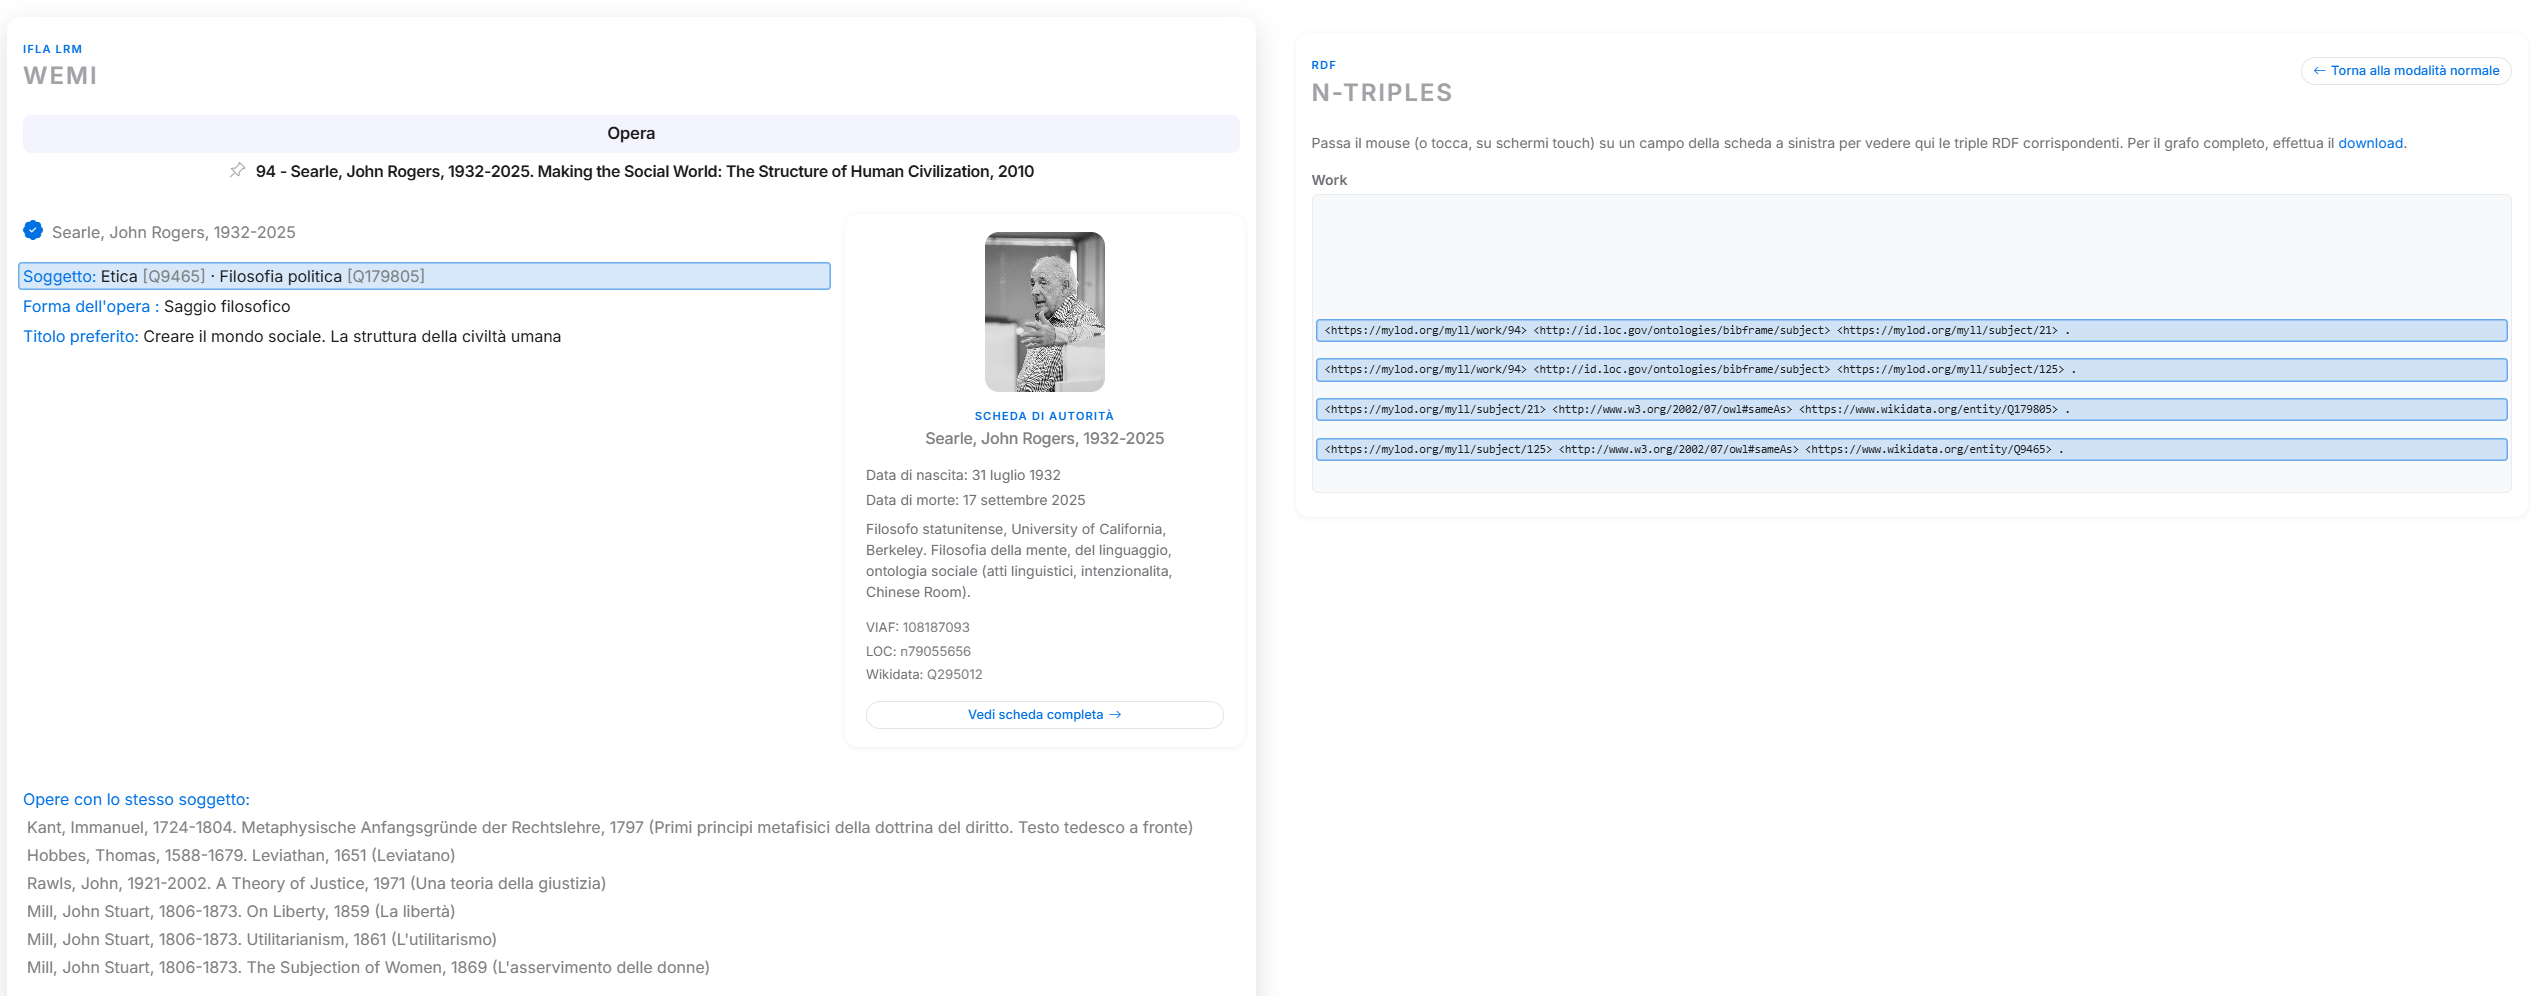
Fai vivere in parallelo il linguaggio naturale con quello della macchina, esplorando le tue triple rdf
Agenti, luoghi, soggetti come entità
Autori, enti collettivi, luoghi, soggetti, occupazioni e titoli uniformi non figurano nel catalogo come stringhe di testo replicate in ciascun record, bensì come entità di autorità autonome: descritte una sola volta, dotate di un proprio identificativo persistente e richiamate per riferimento ovunque ricorrano. È il principio di controllo dell'autorità, qui applicato in modo sistematico a tutte le classi di entità previste dal modello.
Ne discendono conseguenze concrete. Una rettifica apportata alla forma del nome di un autore si propaga istantaneamente a ogni opera che vi fa riferimento, senza necessità di interventi ripetuti; le varianti onomastiche, gli pseudonimi e le forme in scritture diverse convergono sulla medesima entità, garantendo che una ricerca condotta su una qualsiasi di esse conduca comunque al medesimo risultato.
Ciascuna scheda di autorità raccoglie la forma preferita del nome, le forme varianti registrate, una nota biografica o descrittiva e — elemento decisivo per l'interoperabilità — i collegamenti agli identificativi delle principali agenzie internazionali: VIAF, Library of Congress, ISNI, Bibliothèque nationale de France, SBN e Wikidata, per citarne alcuni. Attraverso questi allineamenti l'entità cessa di essere un dato locale e si inserisce nella rete globale delle authority bibliografiche, dove dati biografici e geografici possono essere arricchiti automaticamente dalle fonti collegate.
Ogni descrizione è infine esportabile nei principali formati RDF — Turtle, JSON-LD, N-Triples, RDF/XML, N-Quads — oppure esplorabile direttamente in un ambiente di interrogazione a grafo.
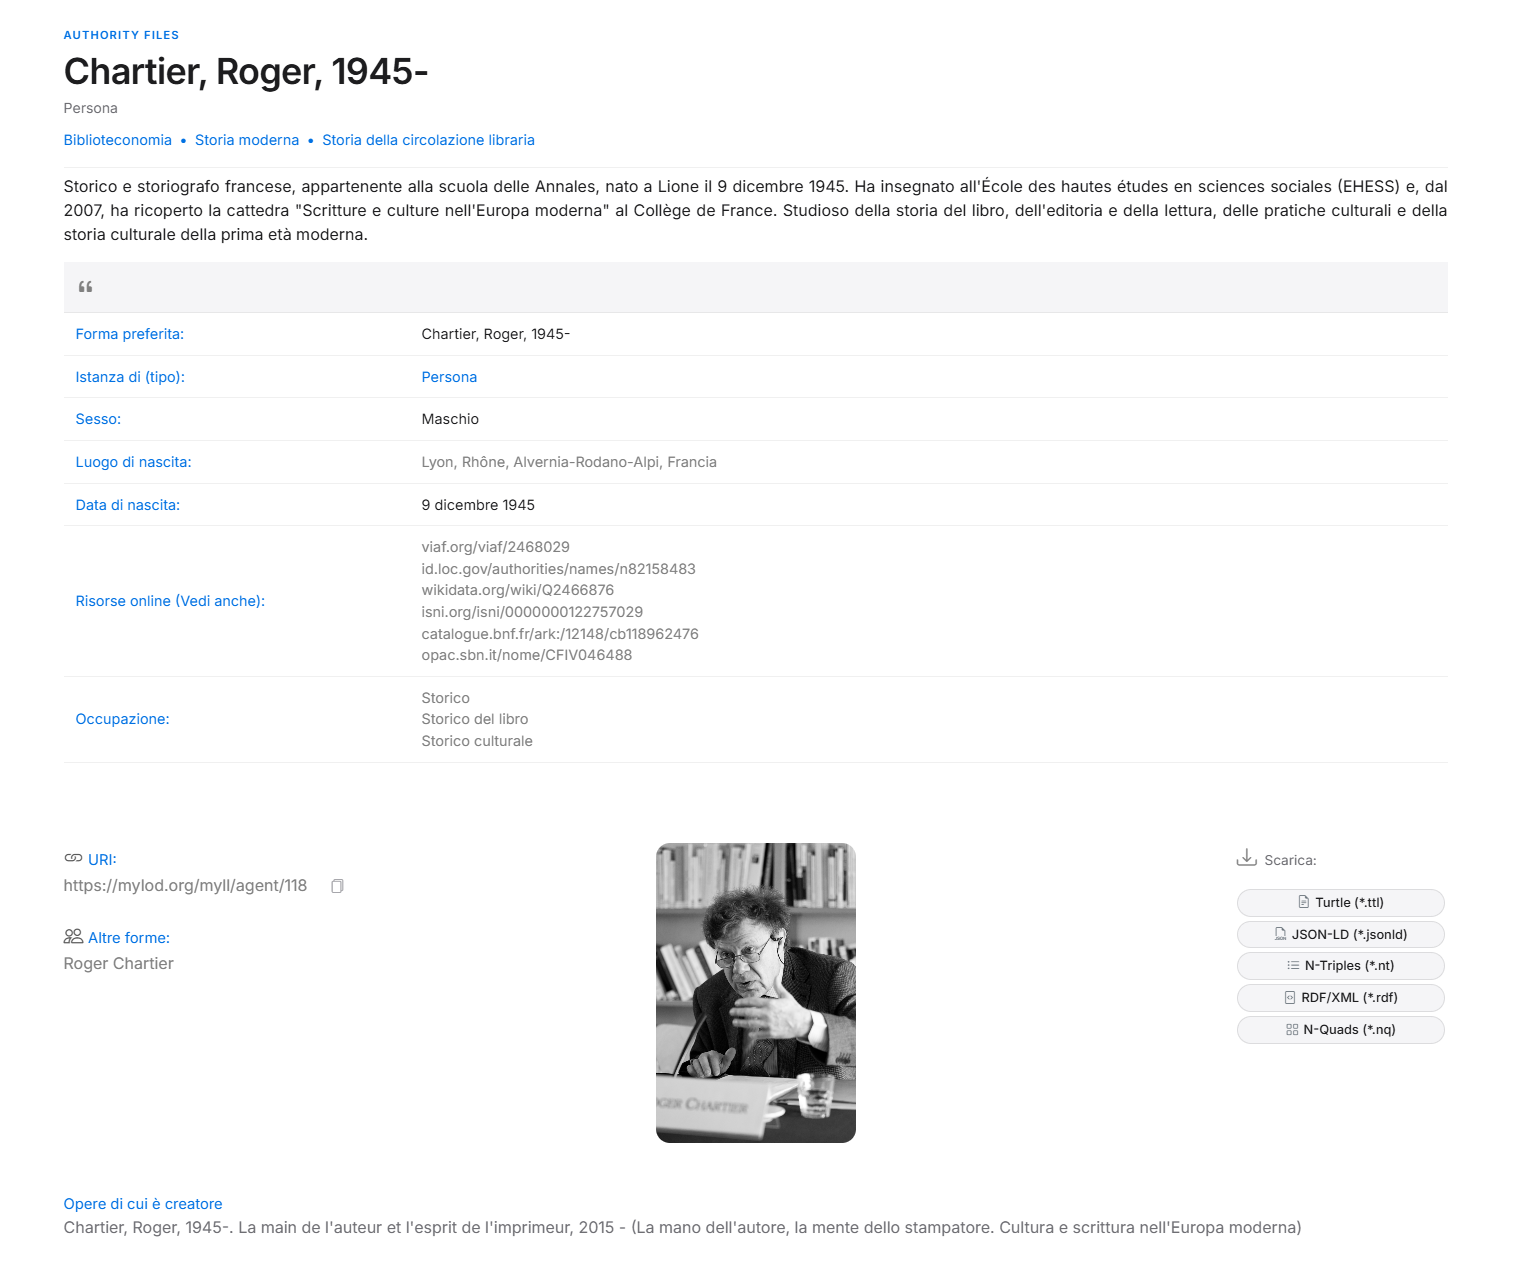
Scheda di autorità con export RDF, arricchita automaticamente da Wikidata
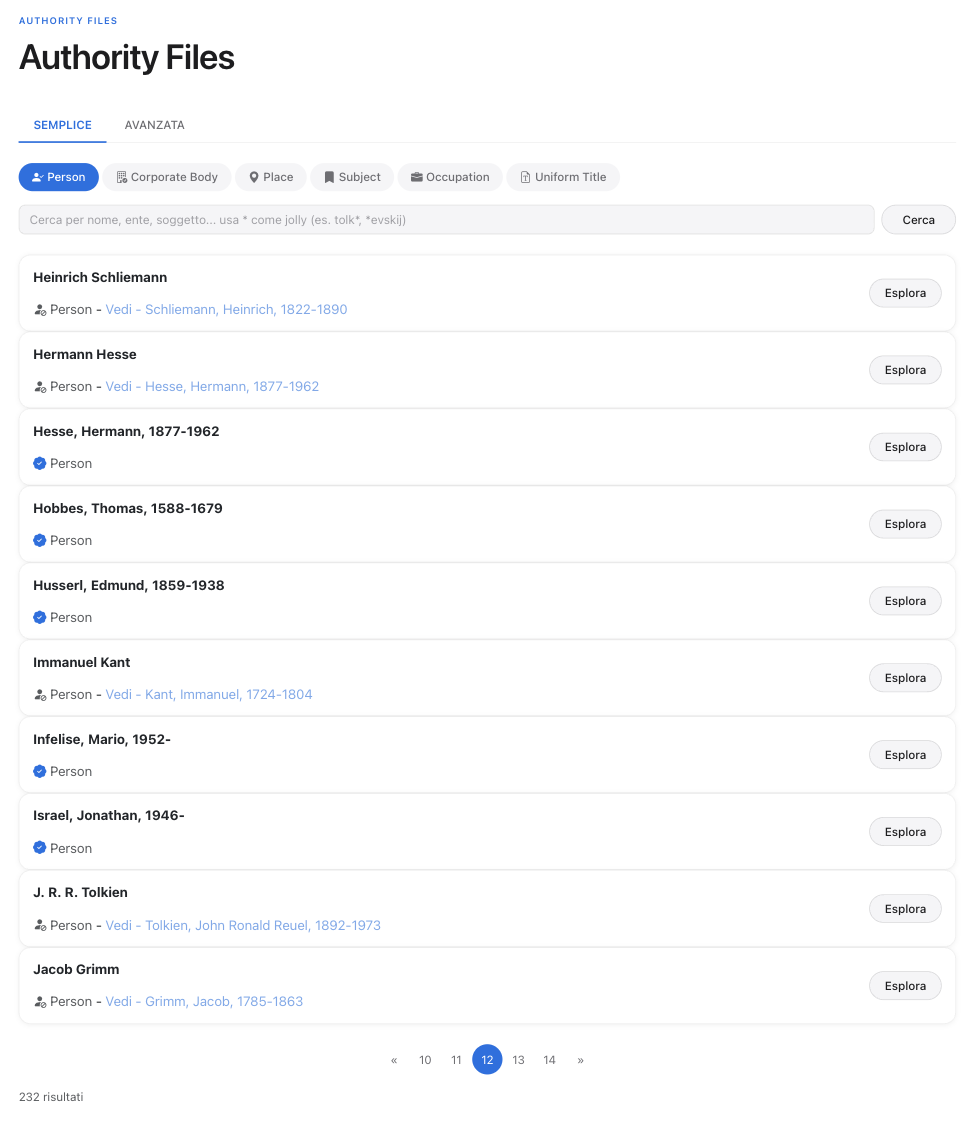
Le Persone come entità autonome, e la ricerca dedicata per tipo di entità
Un grafo di dati interrogabile
Ogni entità descritta nel catalogo — opere, espressioni, manifestazioni, esemplari, agenti, luoghi, soggetti e periodi — viene contestualmente pubblicata come insieme di triple RDF, l'unità elementare del web semantico, costituite ciascuna da un soggetto, un predicato e un oggetto. Le proprietà impiegate non sono definite localmente ma attinte dai vocabolari standard adottati dalla comunità internazionale: BIBFRAME, FOAF, e tanti altri.
Questa struttura è ciò che consente ai dati di uscire dai confini dell'applicazione. Un sistema esterno che conosca quei vocabolari è in grado di interpretare le descrizioni di MYLODLibrary senza alcun accordo preventivo, così come il catalogo può a sua volta agganciarsi a risorse esterne attraverso gli identificativi condivisi. Il risultato non è un archivio chiuso, ma un nodo all'interno di una rete documentaria più ampia. La conversione dei dati dal formato MARC21 ad RDF (attraverso varie tappe di produzione così come di formato del dato disponibile, come il MARCXML) è studiata per fornire al catalogatore la possibilità di apprendere la semantica dei dati RDF senza abbandonare il formato MARC21. Ciò viene permesso dalla coesistenza parallela di due banche dati: quella relazionale, sulla quale opera il MARC21, e quella aperta, costruita per ospitare dati pubblicati per il web semantico.
L'intero grafo di triple è interrogabile pubblicamente in SPARQL, il linguaggio nativo per l'esplorazione dei dati RDF, attraverso un endpoint in sola lettura. Per abbassare la soglia d'ingresso e facilitare la ricerca, l'interfaccia propone una raccolta di interrogazioni già pronte — la distribuzione delle lingue, gli autori attivi in un dato secolo, i soggetti più ricorrenti — che possono essere eseguite immediatamente e poi modificate: un modo per apprendere il linguaggio osservandone gli effetti, senza alcuna competenza pregressa.
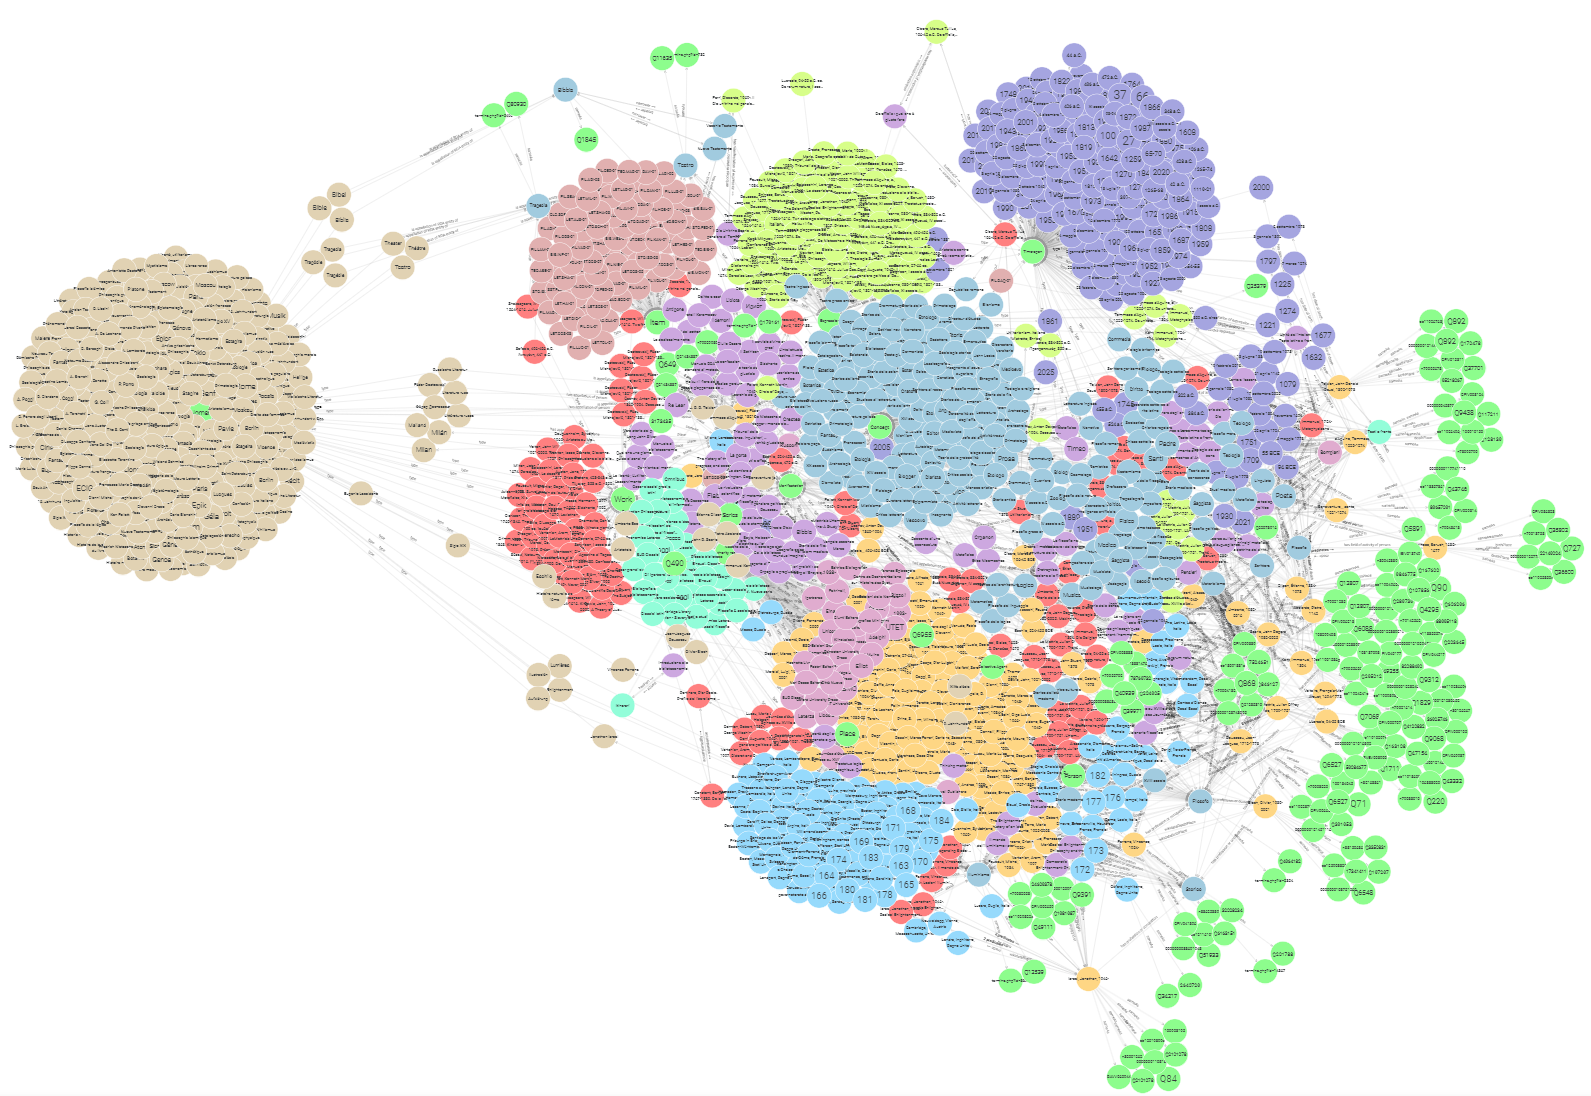
Una porzione del grafo RDF del catalogo: ogni nodo è un'entità, ogni arco una relazione
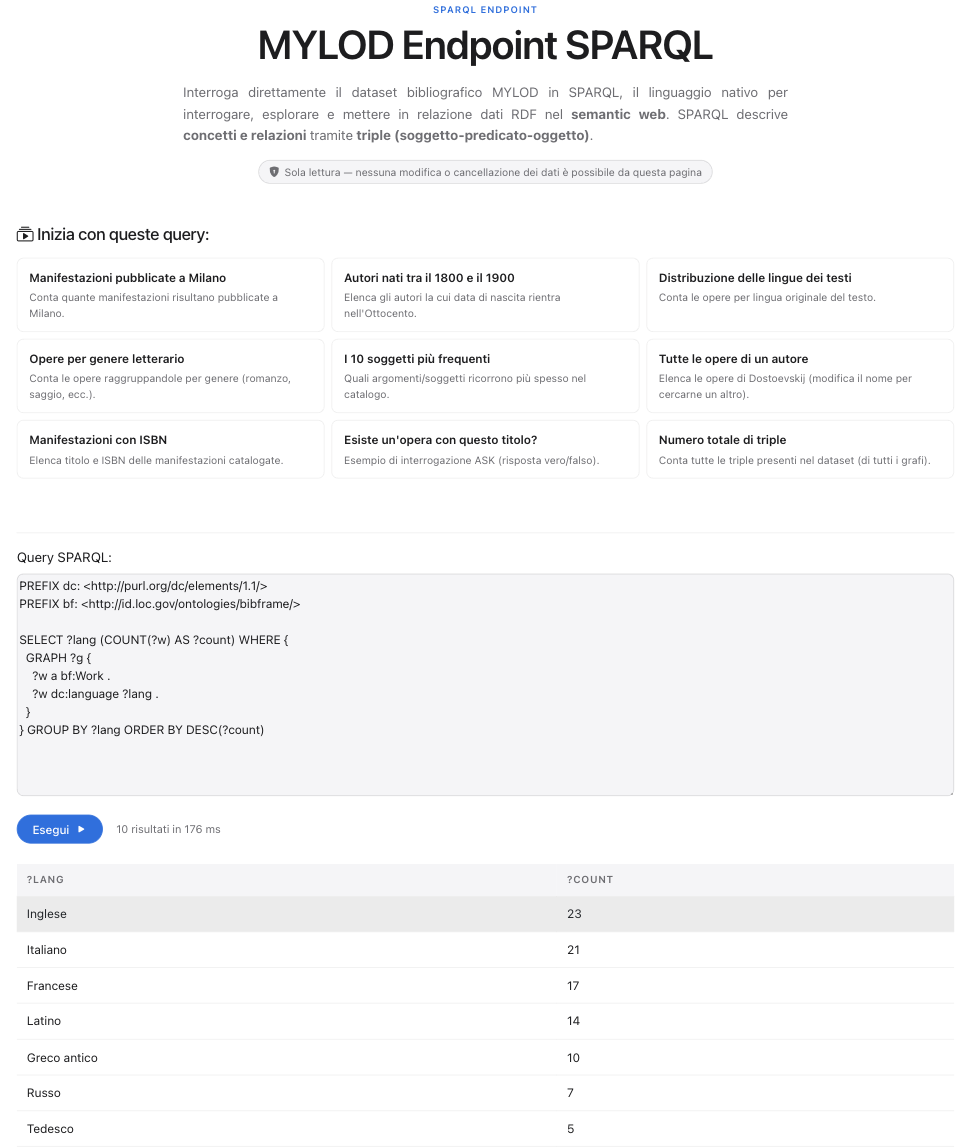
L'endpoint SPARQL pubblico, con query di esempio pronte all'uso
MARC21, RDF nativo e il tuo spazio personale
Sul versante della produzione dei dati, MYLODLibrary percorre due strade parallele anziché imporne una sola. La prima muove dal formato bibliotecario tradizionale: si compila un record MARC21 secondo la prassi consolidata e una procedura automatica ne deriva, campo per campo, le entità LRM corrispondenti, generando la catena Opera-Espressione-Manifestazione-Item e i relativi collegamenti di autorità. La seconda consente la catalogazione nativa diretta secondo i modelli RDA e IFLA LRM, attraverso una suite di maschere dedicate a ciascuna entità del modello.
Le due vie non sono alternative tra loro, ma risposte a esigenze diverse: la prima salvaguarda l'investimento formativo e i flussi di lavoro di chi opera già in MARC21, la seconda permette di sfruttare l'espressività del modello LRM senza le costrizioni di un formato concepito in un'altra epoca tecnologica. Entrambe convergono nel medesimo catalogo e nel medesimo grafo RDF. Questo significa che ciascuna entità risponde alle esigenze di catalogazione indipendentemente dal formato scelto. Producendo RDF nativo o partendo dal MARC21, si arriva comunque alla pubblicazione a cascata del sistema WEMI.
A ogni utente registrato è inoltre riservato uno spazio di catalogazione personale — un laboratorio in cui esercitarsi e costruire le proprie descrizioni, partendo da zero oppure da un record di esempio già compilato. I dati elaborati in quest'area restano rigorosamente privati: non compaiono nel catalogo pubblico, non sono visibili agli altri utenti e non entrano nel grafo interrogabile. È una condizione essenziale perché lo strumento possa essere impiegato anche in contesti didattici, dove l'errore — ed eventualmente la segnalazione di manutenzioni nella piattaforma — è parte del percorso di crescita e apprendimento.
Lo spazio personale non è tuttavia un compartimento isolato dal resto del catalogo: chi cataloga può liberamente riutilizzare le entità di autorità già pubbliche — un agente, un luogo, un soggetto, un'occupazione — esattamente come farebbe un catalogatore esperto, evitando di duplicare ciò che già esiste. Le Espressioni, le Manifestazioni e gli Esemplari restano invece sempre entità proprie e distinte: anche quando si riferiscono alla stessa opera già presente nel catalogo generale, non vengono mai fusi né sovrapposti ai record esistenti. È una distinzione voluta: le authority sono patrimonio condiviso, la descrizione bibliografica di dettaglio resta personale.
Il modello descrittivo non si limita al libro a stampa: manoscritti e libri antichi dispongono di sezioni dedicate — supporto, fascicolazione, scrittura, legatura, impronta, marca tipografica — e, per i manoscritti, di un modulo di trascrizione in TEI/XML, generabile automaticamente dai metadati già catalogati oppure importato da un file prodotto altrove e validato secondo lo schema ufficiale TEI. A completare il quadro, ogni Manifestazione può ospitare una propria copia digitale — un PDF caricato direttamente sulla piattaforma, consultabile in lettura dalla scheda pubblica senza necessità di software esterni.
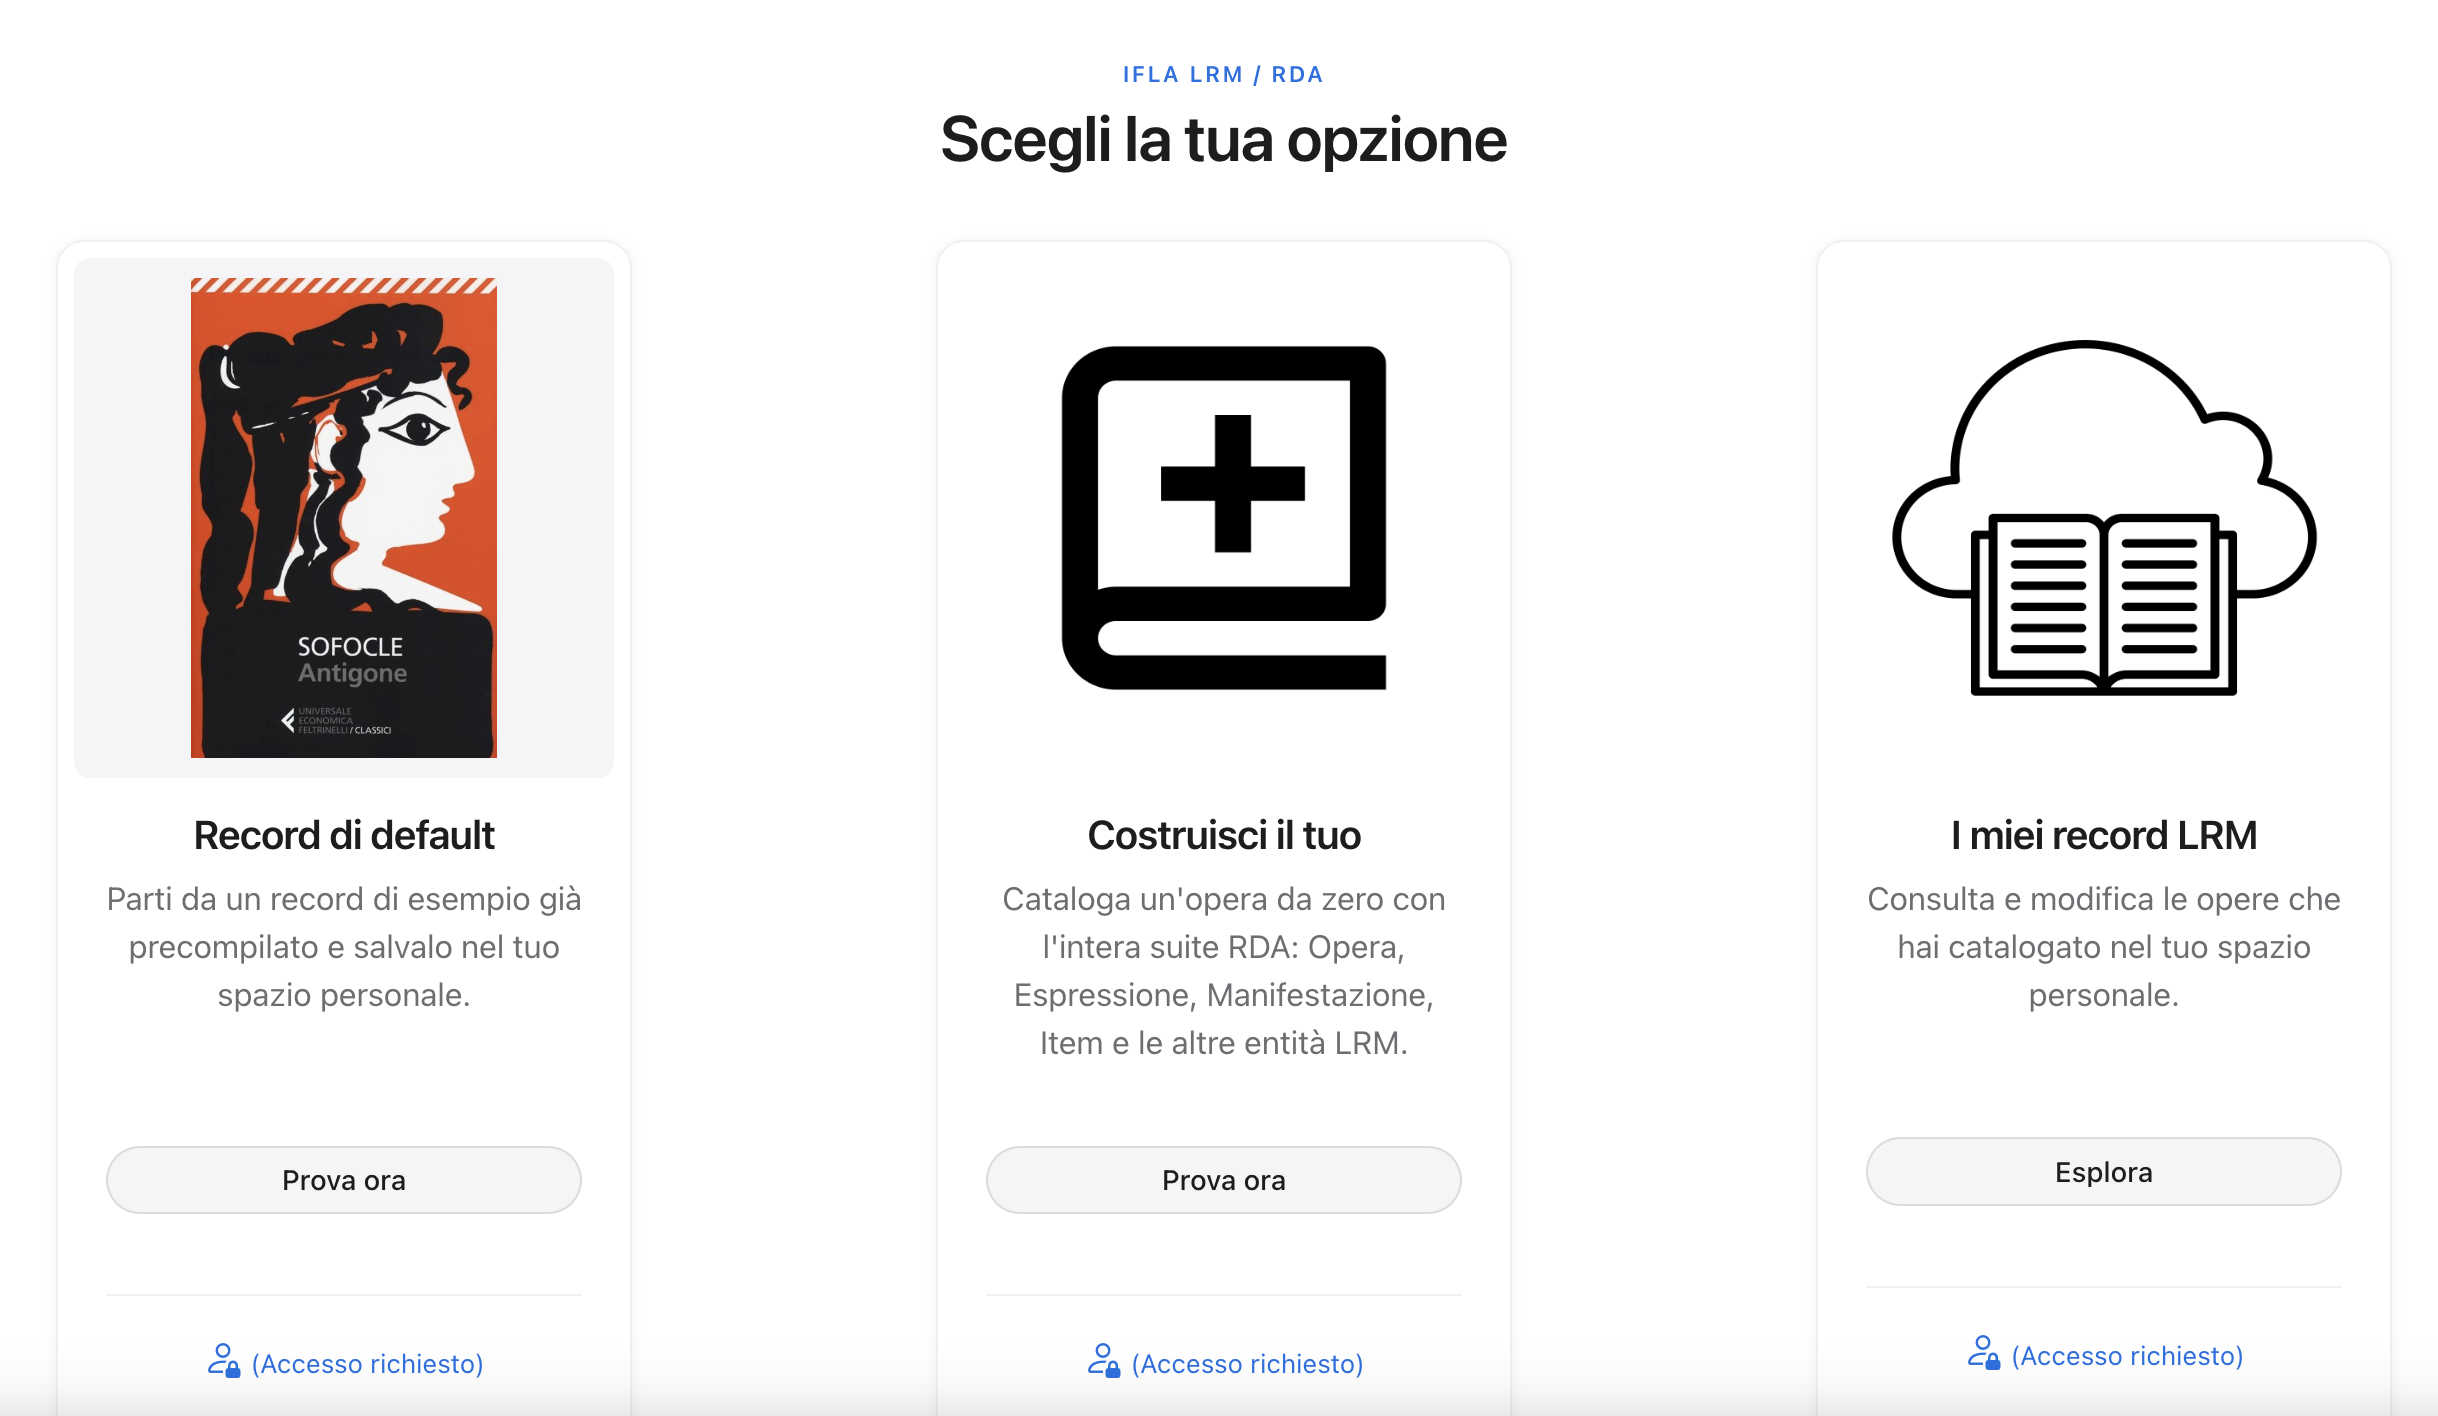
L'hub di catalogazione nativa IFLA LRM/RDA, con lo spazio personale del catalogatore
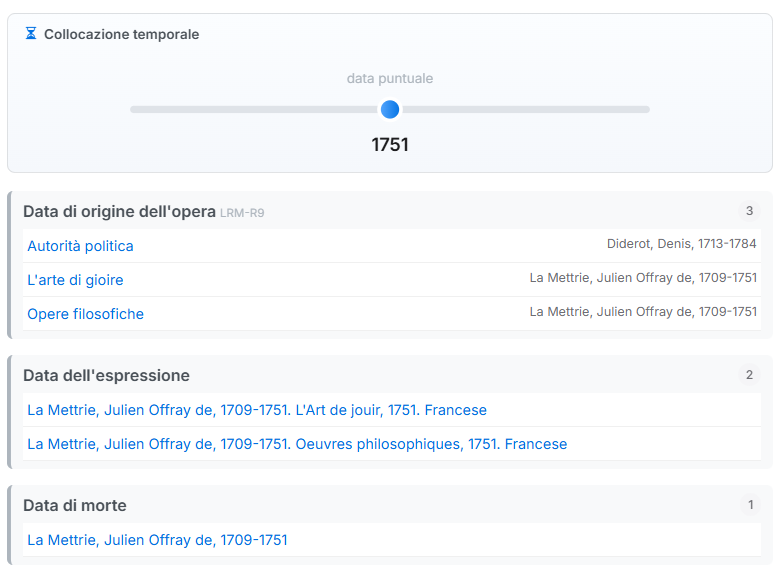
Naviga le relazioni tra le risorse attraverso l'entità Arco di tempo